핵심 요약
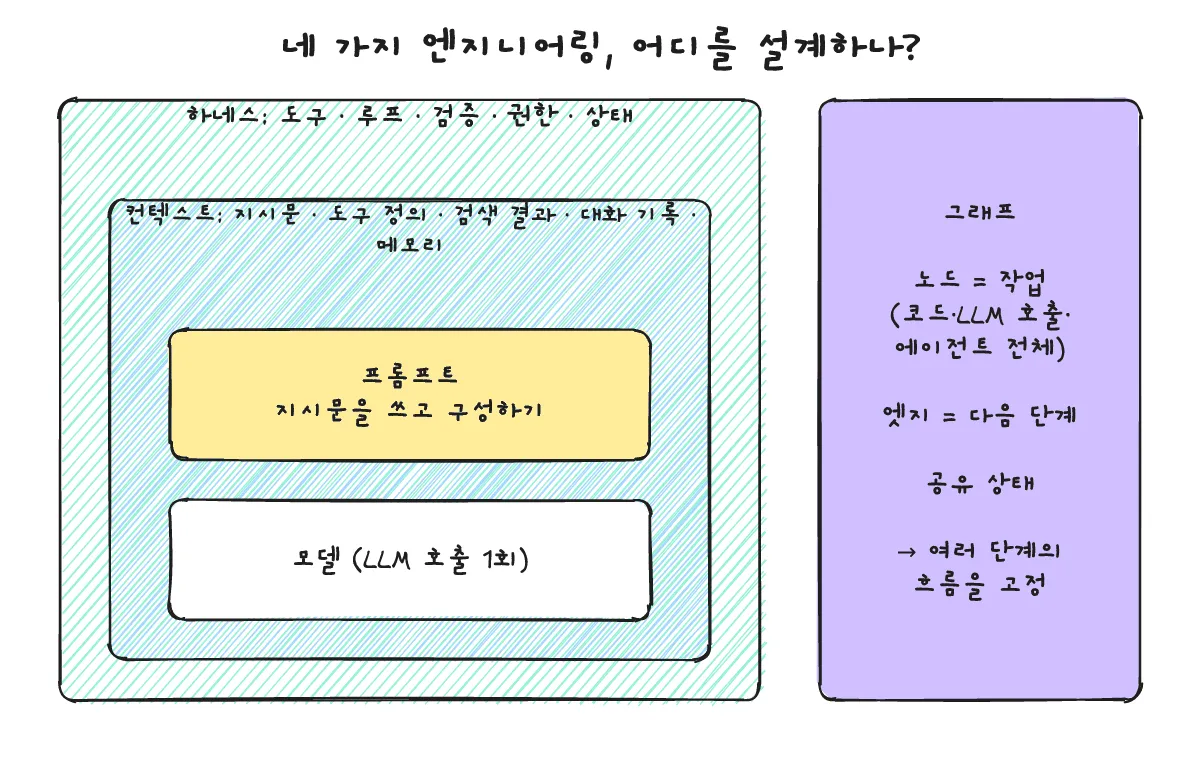
프롬프트 엔지니어링은 LLM에게 줄 지시문을 쓰고 구성하는 일, 컨텍스트 엔지니어링은 지시문 바깥의 도구 정의·검색 결과·대화 기록·메모리까지 포함해 모델이 보는 정보 전체를 고르고 관리하는 일입니다(Anthropic 정의). 하네스 엔지니어링은 모델을 둘러싼 실행 환경(도구, 루프, 검증, 권한, 상태)을 설계하는 일이고, 그래프 엔지니어링은 LangGraph처럼 작업을 노드·엣지·공유 상태로 이뤄진 그래프로 짜서 흐름을 고정하는 접근입니다. 뒤의 두 용어는 표준 정의가 없는 최근 용어라서, 이 글은 실제로 쓰이는 용법을 출처와 함께 정리합니다.
요즘 AI 에이전트 글을 읽다 보면 ”○○ 엔지니어링”이라는 말이 계속 늘어납니다. 이 글에서는 프롬프트·컨텍스트·하네스·그래프 엔지니어링을 하나씩 정의하고, 서로 무엇이 다른지, 언제 쓰는지, 짧은 예시까지 정리합니다. 마지막에 RAG와 평가(eval)도 간단히 덧붙입니다. 정의는 모두 아래 출처에서 가져왔고, 출처가 없는 부분은 그렇다고 밝혔습니다.
프롬프트 엔지니어링은 정확히 무엇을 다루나?
한 줄 답: 모델에게 줄 지시문을 어떻게 쓰고 구성할지를 다룹니다.
-
정의: Anthropic은 프롬프트 엔지니어링을 “최적의 결과를 얻기 위해 LLM 지시문을 작성하고 구성하는 방법”이라고 설명합니다(Anthropic, Effective context engineering for AI agents). Anthropic 프롬프트 엔지니어링 문서는 명확성과 예시부터 XML 구조화, 역할 프롬프팅, 사고(thinking), 프롬프트 체이닝까지의 기법을 별도의 “Prompting best practices” 문서에서 다룬다고 안내합니다. 같은 문서는 프롬프트를 다듬기 전에 성공 기준과 그것을 검증할 방법부터 갖추라고 권합니다.
-
언제 쓰나: 한 번의 호출로 끝나는 작업(요약, 분류, 변환 등)에서 결과가 들쭉날쭉하거나 형식이 지켜지지 않을 때 가장 먼저 손대는 곳입니다. Anthropic의 Building effective agents도 많은 경우 검색과 예시를 곁들인 단일 LLM 호출 최적화로 충분하다고 권합니다.
-
짧은 예시: 역할·작업·출력 형식을 나눠 적은 프롬프트입니다(설명용 예시).
<역할> 당신은 임베디드 리눅스 로그를 읽는 리뷰어입니다.
<작업> 아래 로그에서 오류 원인 후보를 3개 이내로 고르세요.
<형식> 각 후보마다 근거가 된 로그 줄을 그대로 인용하세요.
<로그>
...
</로그>
컨텍스트 엔지니어링은 프롬프트 엔지니어링과 무엇이 다른가?
한 줄 답: 프롬프트가 “지시문”이라면, 컨텍스트는 그 지시문을 포함해 모델이 추론 시점에 보는 정보 전체입니다.
- 정의: Anthropic은 컨텍스트 엔지니어링을 “LLM 추론 중 최적의 토큰(정보) 집합을 고르고 유지하는 전략들”로 정의하고, 프롬프트 바깥에서 컨텍스트에 들어오는 다른 모든 정보까지 포함한다고 설명합니다. 또 이를 프롬프트 엔지니어링의 자연스러운 발전으로 봅니다(Anthropic).
- 핵심 원칙: 같은 글에 따르면 LLM은 유한한 주의(attention) 예산을 가지므로, 좋은 컨텍스트 엔지니어링은 원하는 결과의 가능성을 최대화하는 “가능한 한 작은, 신호가 강한 토큰 집합”을 찾는 것입니다. 검색 쪽에서는 파일 경로 같은 가벼운 식별자만 들고 있다가 필요할 때 불러오는 just-in-time 전략을, 긴 작업 쪽에서는 긴 대화를 요약해 새 컨텍스트로 이어 가는 컴팩션(compaction), 구조화된 메모(structured note-taking), 하위 에이전트(sub-agent) 구조를 소개합니다.
- 언제 쓰나 / 예시: 여러 턴에 걸친 작업이나 긴 작업에서 “무엇을 보여 줄지”가 문제일 때입니다. 예를 들어 에이전트가 파일 전체를 매번 붙여 넣는 대신 파일 경로만 들고 있다가 필요할 때 읽게 하거나, 대화가 길어지면 결정 사항만 요약해 이어 가게 하는 것이 컨텍스트 엔지니어링입니다.
하네스 엔지니어링은 무엇이고, 표준 정의가 있나?
한 줄 답: 모델을 둘러싼 실행 환경(도구, 루프, 검증, 권한, 상태)을 설계하는 일이며, 아직 표준 정의는 없고 최근에 퍼진 용어입니다.
-
용어 상태: 위키백과 Agent harness 항목은 “harness engineering”이라는 표현이 2026년 초에 등장했고, 누가 처음 썼는지는 논란이 있다고 적고 있습니다(Mitchell Hashimoto의 글이라는 설명과 LangChain Vivek Trivedy의 글이라는 설명이 함께 있습니다). 따라서 아래는 “표준 정의”가 아니라 자주 인용되는 용법입니다.
-
흔한 용법: LangChain의 The Anatomy of an Agent Harness는 “에이전트 = 모델 + 하네스”로 정리하고, 하네스를 “모델 자체가 아닌 모든 코드·설정·실행 로직”으로 설명합니다. 모델에 상태, 도구 실행, 피드백 루프, 강제할 수 있는 제약을 주면 에이전트가 된다는 것입니다. O’Reilly Radar 글은 여기에 시스템 프롬프트·규칙 파일, 도구와 MCP 서버, 샌드박스, 오케스트레이션, 훅, 관측(로그·트레이스)을 하네스 구성 요소로 나열합니다. LangChain 글은 “오늘날 하네스는 대체로 좋은 컨텍스트 엔지니어링을 전달하는 수단”이라고도 쓰며, 위키백과도 하네스를 프롬프트·컨텍스트 엔지니어링을 부분으로 포함하는 더 넓은 층으로 보는 시각을 소개합니다. 즉 컨텍스트가 “무엇을 보여 줄지”라면, 하네스는 “무엇을 하게 하고 어떻게 확인할지”까지 넓힌 범위입니다.
-
언제 쓰나 / 예시: 에이전트가 도구를 쓰고, 결과를 검증하고, 실패하면 다시 시도해야 할 때입니다. 아래는 가짜 모델로 하네스의 핵심(도구 루프 + 결정적 검증 + 최대 반복 수)만 보여 주는 예시 코드입니다. 실제 API는 호출하지 않습니다.
# Example: the core of a harness = tool loop + verification (fake model, no API)
def fake_model(history):
    # stands in for an LLM: first asks for a tool, then answers
    if not any(m["role"] == "tool" for m in history):
        return {"tool": "add", "args": (2, 3)}
    return {"answer": history[-1]["content"]}

TOOLS = {"add": lambda a, b: a + b}

def verify(answer):            # deterministic check before we accept
    return isinstance(answer, int)

def run(task, max_steps=5):
    history = [{"role": "user", "content": task}]
    for step in range(max_steps):
        out = fake_model(history)
        if "tool" in out:
            result = TOOLS[out["tool"]](*out["args"])
            history.append({"role": "tool", "content": result})
            continue
        if verify(out["answer"]):
            return out["answer"], step + 1
        history.append({"role": "user", "content": "check failed, try again"})
    raise RuntimeError("gave up")

print(run("what is 2 + 3?"))
Python 3.13.5에서 실제로 실행한 출력입니다(답 5, 2번째 단계에서 종료).
(5, 2)그래프 엔지니어링은 무엇이고, LangGraph와 어떤 관계인가?
한 줄 답: 에이전트 시스템을 노드·엣지·공유 상태로 이뤄진 그래프로 설계해 흐름을 통제하는 접근이고, 이 말 역시 새로 붙은 이름입니다.
-
용어 상태: LangChain 블로그 3 Years of Graph Engineering with LangGraph는 “graph engineering”을 프롬프트·컨텍스트·하네스·루프 엔지니어링에 이어 X(트위터)에서 나온 최신 유행어라고 소개하면서, 새로운 아이디어가 아니라 신뢰할 수 있는 에이전트를 만드는 기존 접근에 붙은 최신 이름이라고 스스로 말합니다. 그래프로 표현하면 LLM의 판단에만 기대지 않고 빌더가 원하는 경로로 동작을 제한할 수 있다는 것이 핵심 설명입니다.
-
LangGraph의 구성: LangGraph Graph API 문서에 따르면 그래프는 State(공유 상태), Nodes(상태를 받아 작업하고 업데이트를 돌려주는 함수), Edges(다음에 실행할 노드를 정하는 고정 또는 조건부 전이)로 이뤄집니다. LangChain 글에 따르면 노드는 결정적 코드, LLM 호출 1회, 도구 호출, 자체 루프를 가진 에이전트 전체일 수도 있습니다. 필자의 해석을 덧붙이면, 이는 Anthropic이 말하는 “LLM과 도구를 미리 정한 코드 경로로 엮는 워크플로”를 명시적으로 그리는 방식에 가깝습니다(Building effective agents).
-
언제 쓰나 / 예시: 단계와 분기를 미리 정해 예측 가능하고 감사(audit)할 수 있게 만들고 싶을 때입니다. 아래는 LLM 없이 “작성 → 검사 → 통과 못 하면 다시 작성” 루프를 그래프로 만든 예시입니다. LangGraph 1.2.15에서 실제로 실행했습니다.
# Example: a tiny LangGraph state graph (no LLM; nodes are plain functions)
from typing import TypedDict
from langgraph.graph import StateGraph, START, END

class State(TypedDict):
    draft: str
    tries: int

def write(state: State):
    return {"draft": state["draft"] + "!", "tries": state["tries"] + 1}

def check(state: State):
    return "done" if state["draft"].endswith("!!") else "retry"

g = StateGraph(State)
g.add_node("write", write)
g.add_edge(START, "write")
g.add_conditional_edges("write", check, {"retry": "write", "done": END})
app = g.compile()
print(app.invoke({"draft": "hello", "tries": 0}))
{'draft': 'hello!!', 'tries': 2}RAG와 평가(eval)는 이 그림의 어디에 들어가나?
한 줄 답: RAG는 컨텍스트를 채우는 대표적인 방법이고, 평가는 위의 어떤 변경이든 정말 나아졌는지 재는 장치입니다.
- RAG: Lewis 등의 논문 Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(2020)이 제안한 방식으로, 생성 모델에 외부 문서 검색을 결합합니다. 이 글의 구분으로 보면 “무엇을 컨텍스트에 넣을지”를 정하는 컨텍스트 엔지니어링의 한 수단입니다.
- 평가: “eval engineering”도 표준 용어는 아닙니다. 다만 Anthropic의 Demystifying evals for AI agents는 에이전트 평가를, 잘하는 일을 늘리는 capability eval과 예전 작업을 여전히 하는지 보는 regression eval로 나누고, 가능하면 결정적 채점기, 필요할 때 LLM 채점기, 사람 채점은 신중하게 쓰라고 권합니다. 프롬프트를 바꾸든 하네스를 바꾸든, 평가가 있어야 개선인지 알 수 있습니다.
결국 언제 무엇부터 손대야 할까?
한 줄 답: 가장 단순한 것부터 시작하고, 막힐 때만 한 층씩 올립니다.
- 네 가지는 경쟁 관계가 아니라 범위가 다릅니다. 위 출처들의 설명을 이어 보면 프롬프트는 컨텍스트의 일부이고(Anthropic), 컨텍스트 관리는 하네스가 하는 일 중 하나이며(LangChain, 위키백과), 그래프는 여러 단계의 흐름을 고정하는 구조로서 노드 안에 LLM 호출이나 에이전트 전체를 담을 수 있습니다.
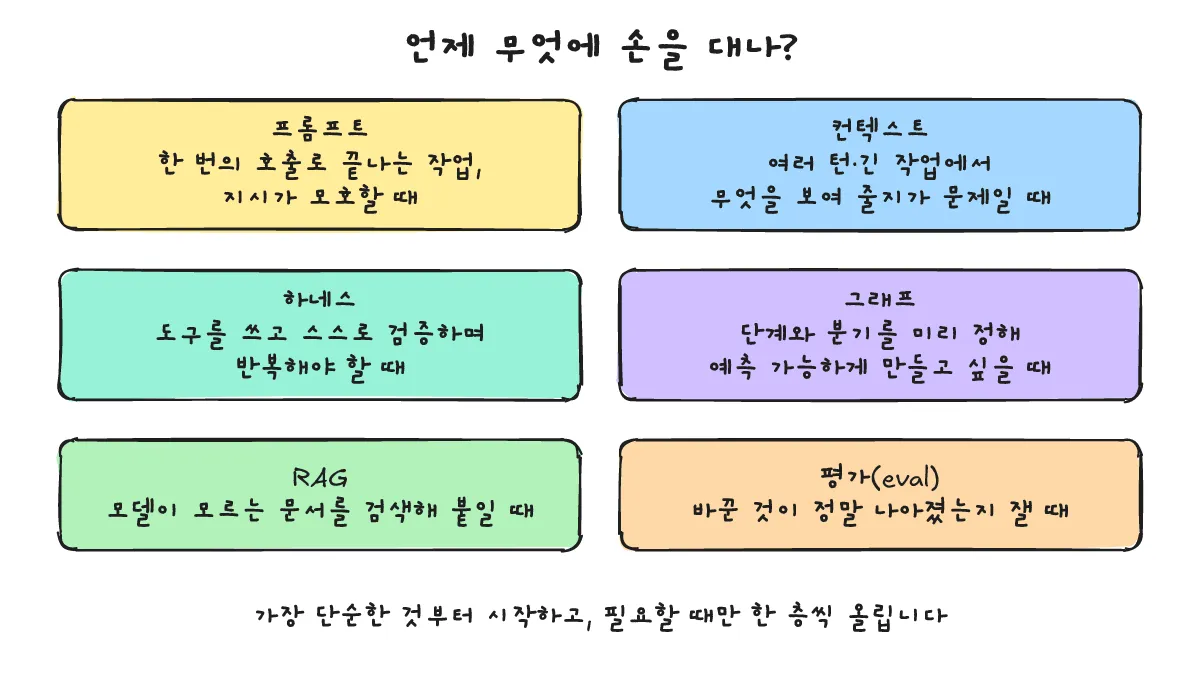
- Anthropic은 가능한 가장 단순한 해법을 찾고 필요할 때만 복잡도를 올리라고 권합니다(Building effective agents). 순서로 옮기면 ① 프롬프트를 다듬고 ② 컨텍스트(검색·메모리)를 정리하고 ③ 도구와 검증 루프가 필요하면 하네스를 만들고 ④ 흐름을 예측 가능하게 묶어야 하면 그래프로 고정합니다. 각 단계의 효과는 평가로 확인합니다.
참고한 출처는?
- Anthropic — Effective context engineering for AI agents
- Anthropic — Prompt engineering overview
- Anthropic — Building effective agents
- Anthropic — Demystifying evals for AI agents
- LangChain — The Anatomy of an Agent Harness
- O’Reilly Radar — Agent Harness Engineering
- Wikipedia — Agent harness
- LangChain — 3 Years of Graph Engineering with LangGraph
- LangGraph — Graph API overview
- Lewis et al. (2020) — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks