SK하이닉스 AI 해커톤 2026 1차 예선(AI 기초 이해 및 활용 역량) 대비 공부 노트. Day4 프롬프트 엔지니어링에 이어지는 글.
-
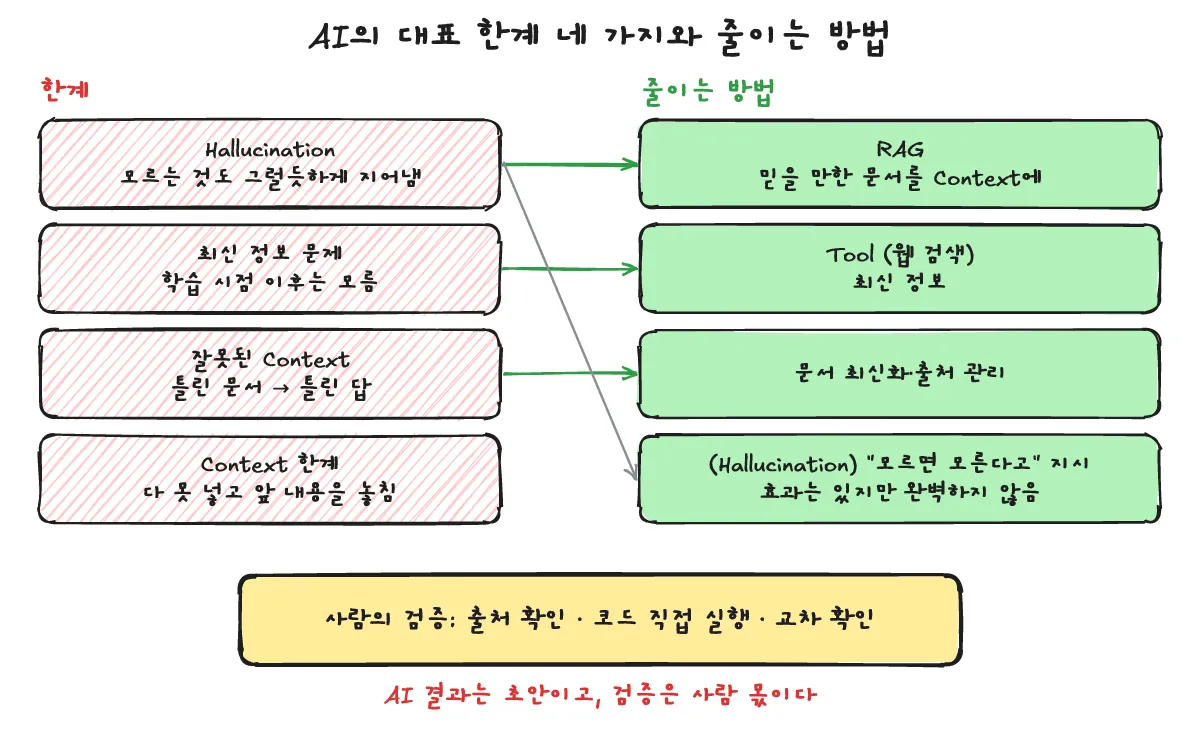
Hallucination(환각)이란? AI가 사실이 아닌 내용을 그럴듯하고 자신 있게 말하는 것. 예: 없는 논문 제목을 지어내거나, 틀린 날짜를 확신에 차서 말함.
-
왜 생기나? LLM은 사실을 검색하는 게 아니라 “다음에 올 그럴듯한 토큰”을 확률로 예측한다. 모르면 “모른다”고 하는 게 기본 동작이 아니라서, 말투는 자연스러운데 내용은 틀린 답이 나올 수 있다.
- 비유: 세종대왕 발명품 3개를 묻는데 2개만 알 때, 대화를 멈추기 싫어서 하나를 지어내는 것.
- 시험용 한 줄: LLM은 사실을 검색하는 게 아니라 그럴듯한 다음 토큰을 확률로 예측하기 때문에, 모르는 내용도 자연스럽게 지어낼 수 있다.
-
Hallucination 줄이는 방법
- RAG: 믿을 만한 문서를 찾아 Context에 넣어 근거 기반으로 답하게 한다.
- Tool(웹 검색): 학습 시점 이후의 최신 정보 문제까지 해결한다.
- 프롬프트로 “모르면 모른다고 답하라” 지시: 효과는 있지만 모델이 자기가 모른다는 걸 항상 아는 건 아니라 완벽하지 않다.
- 사람의 검증: 출처 확인, 코드 직접 실행, 교차 확인.
-
잘못된 Context (Garbage in, garbage out): RAG로 넣은 문서가 오래됐거나 틀리면 AI는 그걸 믿고 틀린 답을 한다. RAG는 문서 최신화와 출처 관리가 필수다.
-
AI의 대표 한계 네 가지
- Hallucination: 모르는 내용도 그럴듯하게 지어낸다.
- 최신 정보 문제: 학습 시점 이후 일은 모른다.
- 잘못된 Context: 틀린 문서를 넣으면 틀린 답이 나온다.
- Context 한계: 컨텍스트 윈도우에 다 못 넣고, 길어지면 앞 내용을 놓친다.
-
AI가 써준 코드 검증하기
- 직접 빌드하고 실행해 본다.
- 빌드·실행이 된다고 결과가 맞는 건 아니다. 정상 입력, 경계값, 이상한 입력으로 테스트해서 예상한 결과가 나오는지 확인한다.
- 문법 오류는 컴파일러가 잡아주니, 사람은 로직이 요구사항에 맞는지 보는 데 집중한다.
-
Day5 결론: AI 결과는 초안이고, 검증은 사람 몫이다. 출처 확인, 테스트, 교차 확인.
Part 2. Embedding과 RAG 구조
-
네 가지 구분 (시험 단골)
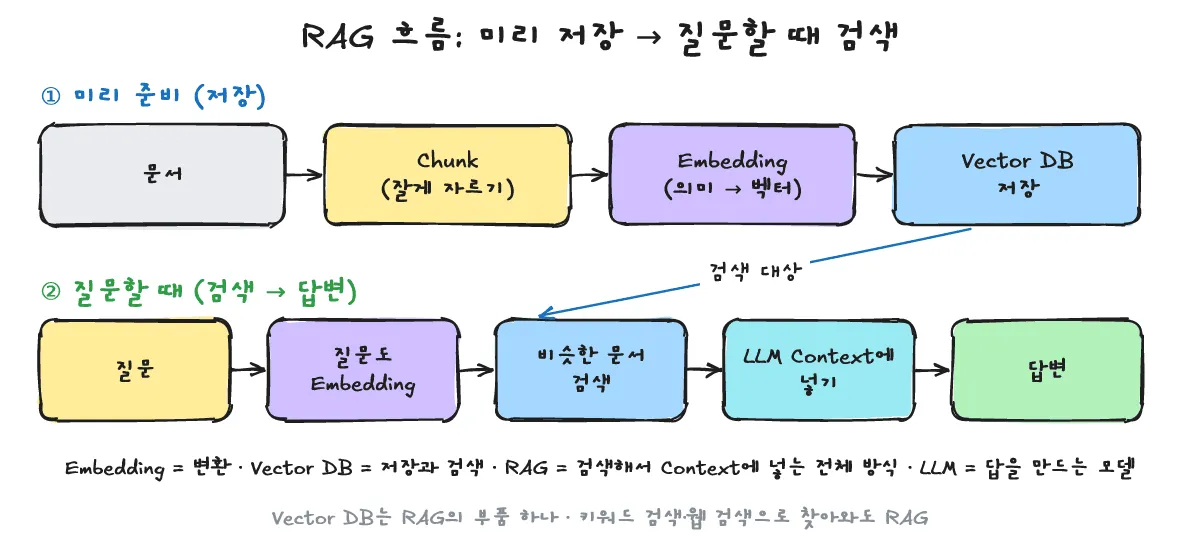
- Embedding: 문장을 의미가 담긴 숫자 벡터로 바꾸는 것
- Vector DB: 그 벡터들을 저장해 두고 비슷한 걸 빨리 찾아주는 저장소
- RAG: 질문과 관련된 문서를 찾아 LLM의 Context에 넣어주는 전체 방식
- LLM: 그 Context를 보고 최종 답을 만드는 모델
-
RAG 흐름: 문서 → Chunk(잘게 자르기) → Embedding → Vector DB 저장 → 질문도 Embedding → 비슷한 문서 검색 → LLM Context에 넣기 → 답변
-
Chunk로 자르는 이유
- 필요한 단위로 저장하면 유사 문서 검색이 더 효율적이고 정확해진다.
- Context 한계: 통째로 넣으면 컨텍스트 윈도우를 잡아먹고, 상관없는 내용이 섞여 답이 흐려진다.
- 주의: 너무 작으면 문맥이 끊기고, 너무 크면 쓸데없는 내용이 섞인다. 그래서 조각끼리 살짝 겹치게(overlap) 자르기도 한다.
-
“Vector DB가 곧 RAG다”는 틀린 말: Vector DB는 RAG의 부품 하나일 뿐이고, RAG는 찾아서 Context에 넣고 LLM이 답하는 전체 방식이다. RAG가 꼭 Vector DB를 써야 하는 것도 아니다. 키워드 검색이나 웹 검색으로 찾아와도 RAG다.
- 시험용 한 줄: Embedding은 변환, Vector DB는 저장과 검색, RAG는 검색해서 Context에 넣는 전체 방식, LLM은 답을 만드는 모델이다.
Part 3. AI Agent와 Tool Calling
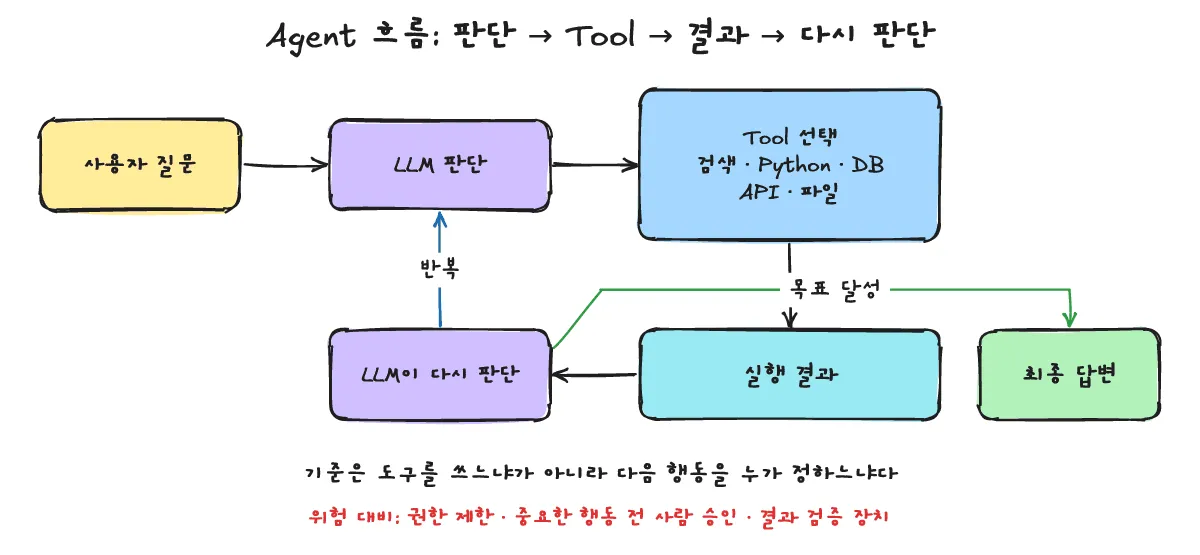
- Agent란? 그냥 LLM은 질문을 받으면 바로 답만 한다. Agent는 LLM이 문제를 보고 스스로 판단해서 도구를 고르고, 써보고, 결과를 보고 다음 행동을 정한다. 이걸 반복해서 목표를 이룬다.
- 흐름: 사용자 질문 → LLM 판단 → Tool 선택(검색, Python, DB, API, 파일) → 실행 결과 → LLM이 다시 판단 → … → 최종 답변
-
예: “오늘 서울 날씨 알려줘”
- 그냥 LLM: 실시간 정보가 없어서 지어내거나, 모른다고 답한다. 어느 쪽이든 실제 날씨는 못 알려준다.
- Agent: 위치 확인 → 날씨 API나 웹 검색 → 결과를 보고 답변한다.
-
LLM / Workflow / Agent 구분 (시험 단골)
- LLM: 질문 받으면 바로 답한다. 도구가 없다.
- Workflow: 사람이 정해둔 순서대로 움직인다. 예: 매일 9시에 뉴스 3개 검색 → 요약 → 메일 발송.
- Agent: LLM이 상황을 보고 다음에 뭘 할지 스스로 정한다. 예: “요즘 반도체 업계 이슈를 정리해줘”를 받으면 뭘 검색할지 고르고, 부족하면 다시 검색하고, 필요하면 표도 만든다.
- 기준은 도구를 쓰느냐가 아니라 다음 행동을 누가 정하느냐다.
-
Agent의 위험
- 사용자가 원하지 않는 방향으로 작업이 진행될 수 있다.
- 도구를 반복 호출해서 시간과 비용이 늘어난다.
- 중간에 Hallucination이 끼면 잘못된 결과 위에 다음 행동을 쌓는다.
- 파일 삭제나 메일 발송처럼 되돌릴 수 없는 행동을 할 수 있다.
- 그래서 권한 제한, 중요한 행동 전 사람 승인, 결과 검증 장치를 둔다.
다음 글
머신러닝 기초와 AI로 문제 해결하기, 그리고 종합 문제 풀이