블로킹과 논블로킹, 동기(싱크)와 비동기(어싱크) 차이는 I/O가 당장 진행될 수 없을 때 호출이 기다리는가, 그리고 호출 자체가 I/O를 끝내고 결과를 들고 돌아오는가 아니면 요청 제출과 완료 수거가 분리되는가로 나누어 볼 수 있습니다. 이 글에서는 리눅스 매뉴얼 페이지(pipe(7), read(2), epoll(7), io_uring(7)), 커널 공식 문서, 그리고 이 글의 실행 환경(x86-64 리눅스, gcc 14.2, liburing 2.9, strace 6.13)에서 직접 실행한 결과를 바탕으로 파이프 읽기 예제 네 가지의 동작을 비교합니다.
핵심 요약
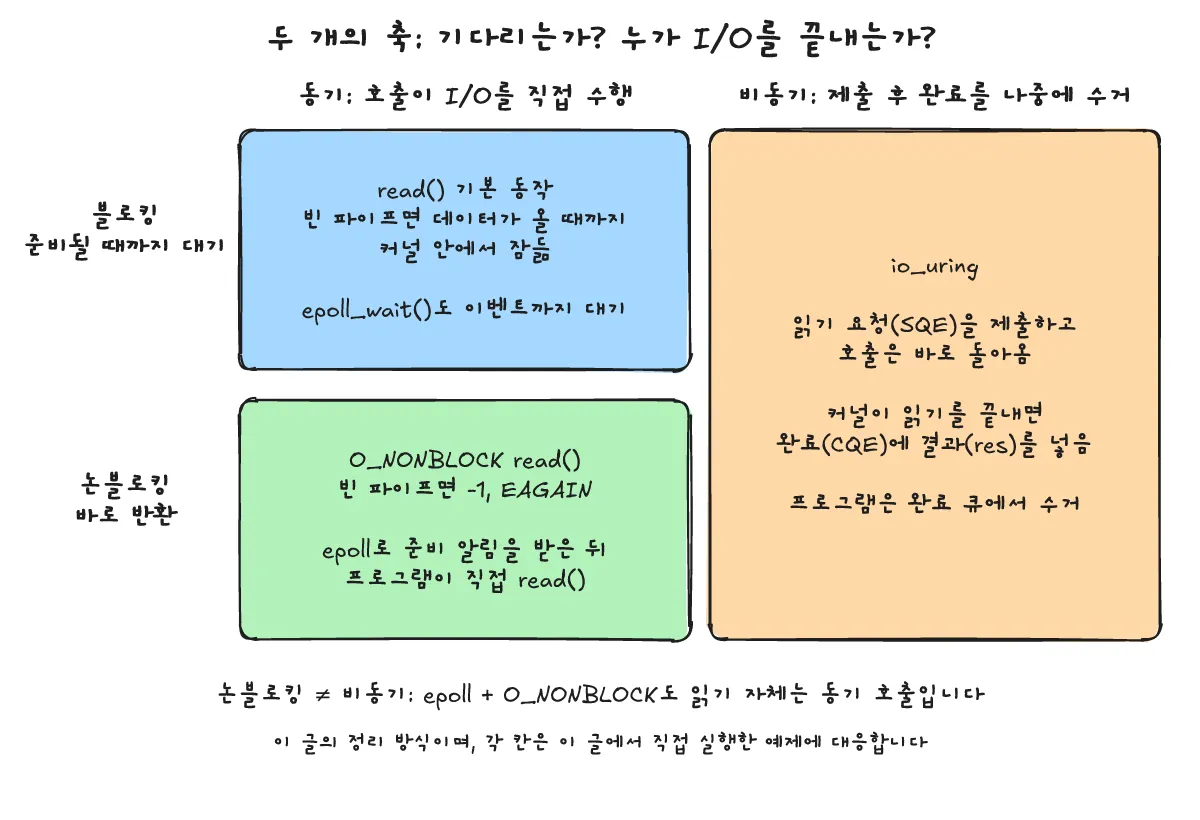
이 글에서는 리눅스 매뉴얼 페이지의 설명과 일치하도록 두 가지 기준으로 정리합니다. 블로킹과 논블로킹은 I/O를 당장 진행할 수 없을 때 호출이 대기하는지의 구분입니다(빈 파이프에서 기본 read(2)는 블로킹하며, O_NONBLOCK을 켜면 즉시 -1과 EAGAIN을 반환합니다). 동기(싱크)와 비동기(어싱크)는 호출 자체가 I/O를 수행해 반환 시점에 결과를 돌려주는지(O_NONBLOCK을 켠 read도 동기), 아니면 요청을 먼저 제출하고 완료 결과를 나중에 수거하는지(io_uring)의 구분입니다. epoll은 준비 알림(readiness notification)으로, epoll_wait(2)가 파일 디스크립터가 준비될 때까지 기다린(블로킹) 뒤 프로그램이 직접 read를 호출합니다. 따라서 논블로킹과 비동기는 같은 말이 아닙니다.
블로킹과 논블로킹, 동기(싱크)와 비동기(어싱크) 차이는 무엇입니까?
한 줄 답: 같은 말이 아닙니다. 블로킹과 논블로킹은 당장 I/O를 진행할 수 없을 때 호출이 기다리는지를 뜻하고, 동기(싱크)와 비동기(어싱크)는 호출이 직접 I/O 결과를 들고 복귀하는지 아니면 요청 제출과 완료 수거가 분리되는지를 뜻합니다.
대기 여부(블로킹/논블로킹)와 완료 전달 방식(동기/비동기)
리눅스 매뉴얼 페이지의 동작에 맞춰 이 글에서는 두 축을 다음과 같이 정리합니다.
-
블로킹 / 논블로킹(대기 여부): 호출 시점에 I/O가 바로 진행될 수 없을 때 호출이 대기하는지 여부입니다.
pipe(7)과read(2)에 따르면 빈 파이프에서 기본read(2)를 호출하면 데이터가 들어올 때까지 블로킹하지만,O_NONBLOCK플래그를 켜면 기다리지 않고 즉시-1(errno = EAGAIN)을 반환합니다. -
동기(싱크) / 비동기(어싱크): 호출 자체가 I/O를 수행하고 반환 시점에 결과를 함께 돌려주는지, 아니면 I/O 요청을 먼저 제출하고 완료(completion)를 나중에 수거하는지의 차이입니다.
read(2)는O_NONBLOCK을 켰더라도 데이터가 있을 때 호출 자체가 읽기를 수행하고 바이트 수를 반환하므로 동기 호출입니다. 반면io_uring(7)은 제출 큐(SQ)에 요청을 넣고 완료 큐(CQ)에서 결과를 수거하는 비동기 I/O API입니다.
왜 논블로킹과 비동기를 흔히 섞어 부릅니까?
일반적인 이벤트 기반 코드에서 O_NONBLOCK을 설정한 파일 디스크립터를 epoll(7)에 등록해 쓰는 구성이 널리 쓰이기 때문에 두 용어가 자주 혼용됩니다. 하지만 epoll(7)은 I/O가 가능한지 감시하는 준비 알림(readiness notification) 메커니즘입니다. epoll_wait(2)는 이벤트가 없을 때 호출 스레드를 블로킹하며 기다렸다가, 디스크립터가 읽을 준비(EPOLLIN)가 되었음을 알려줍니다. 그다음 실제 데이터를 읽는 작업은 유저 프로그램이 직접 동기 호출인 read(2)를 불러 수행합니다. 따라서 O_NONBLOCK이나 epoll을 쓰는 것과 io_uring처럼 커널에 I/O를 제출하고 완료 이벤트를 수거하는 비동기 I/O는 구조가 다릅니다.
블로킹 read는 커널 안에서 어떻게 기다립니까?
한 줄 답: 빈 파이프에서 read(2)를 호출하면 데이터가 들어올 때까지 커널 안에서 대기하며, 커널 공식 문서에 설명된 일반적인 패턴에서는 .read 경로가 대기 큐(wait queue)에 프로세스를 재운 뒤 데이터가 준비되면 wake_up()으로 깨웁니다.
빈 파이프에서 read() 실행과 strace 확인
pipe(7) 매뉴얼 페이지의 “I/O on pipes and FIFOs” 절에 따르면, 프로세스가 빈 파이프에서 읽기를 시도하면 read(2)는 데이터가 들어올 때까지 블로킹합니다(반대로 가득 찬 파이프에 쓰기를 시도하면 write(2)가 충분한 데이터를 읽어 갈 때까지 블로킹합니다). 아래 blocking_read.c는 파이프를 만든 뒤 자식 프로세스가 잠시 뒤 "hello" 5바이트를 쓰고, 부모 프로세스는 빈 파이프에서 곧바로 read()를 호출합니다.
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    int fds[2];
    char buf[16];
    pipe(fds);
    if (fork() == 0) {                       /* child: write after 1 second */
        sleep(1);
        write(fds[1], "hello", 5);
        _exit(0);
    }
    printf("parent: calling read() on an empty pipe\n");
    fflush(stdout);
    ssize_t n = read(fds[0], buf, sizeof buf);   /* blocks until data arrives */
    printf("parent: read() returned %zd: %.*s\n", n, (int)n, buf);
    wait(NULL);
    return 0;
}
이 글의 실행 환경(x86-64 리눅스, gcc 14.2, liburing 2.9, strace 6.13)에서 gcc -O0 -Wall -o blocking_read blocking_read.c로 경고 없이 빌드해 직접 실행한 결과는 다음과 같습니다.
parent: calling read() on an empty pipe
parent: read() returned 5: hello
이어서 strace -f -e signal=none -e trace=read,write ./blocking_read로 시스템 콜 순서를 확인한 결과입니다(동적 로더가 라이브러리를 읽는 줄은 생략했으며, strace 실행 시 표준 출력을 /dev/null로 리다이렉트했기 때문에 출력 write(1, ...)가 버퍼링되어 보일 수 있습니다).
365189 write(1, "parent: calling read() on an emp"..., 40) = 40
365189 read(3,  <unfinished ...>
365190 write(4, "hello", 5)             = 5
365190 +++ exited with 0 +++
365189 <... read resumed>"hello", 16)   = 5
365189 write(1, "parent: read() returned 5: hello"..., 33) = 33
365189 +++ exited with 0 +++
strace 출력을 보면 부모 프로세스(PID 365189)가 호출한 read(3, ...가 <unfinished ...> 상태로 멈춰 있다가, 자식 프로세스(PID 365190)가 write(4, "hello", 5) = 5를 호출한 뒤에야 <... read resumed>"hello", 16) = 5로 복귀합니다. 즉 read 호출이 데이터가 도착할 때까지 커널 내부에서 기다렸다가 5바이트를 읽고 돌아왔음을 볼 수 있습니다. strace로 프로세스의 시스템 콜을 추적하는 기초 방법은 strace, 프로세스가 어떤 시스템 콜을 내는지 보는 법에서 다룹니다.
VFS .read와 wait queue의 동작 원리
유저 프로그램이 호출한 read(2)가 커널로 진입해 파일이나 드라이버의 연산으로 연결되는 전체 경로는 「유저 프로그램은 어떻게 커널을 호출할까? svc/syscall, ioctl, copy_from_user 흐름」에서 다룹니다. 리눅스 커널 공식 문서인 VFS(Virtual File System) 문서에 따르면, struct file_operations의 .read 멤버는 read(2) 및 관련 시스템 콜이 호출될 때 실행됩니다.
이 글에서는 별도의 커널 모듈을 작성하거나 실행하지 않았으며, 커널 내부의 대기 원리는 리눅스 커널 문서(“Unreliable Guide To Hacking The Linux Kernel”의 “Wait Queues include/linux/wait.h” 절)에 설명된 내용으로 살펴봅니다. 해당 문서에 따르면 대기 큐(wait queue)는 특정 조건이 참이 될 때 누군가 자신을 깨워 주기를 기다리는 용도로 쓰이며, 레이스 컨디션을 피하도록 주의해서 사용해야 합니다. 주요 구성은 다음과 같습니다.
-
DECLARE_WAIT_QUEUE_HEAD()또는init_waitqueue_head()로 대기 큐 헤드(wait_queue_head_t)를 선언합니다. -
대기하는 프로세스는 대기 큐 엔트리(
wait_queue_entry_t)를 큐에 넣으며, 반드시 조건을 검사하기 전에 자신을 큐에 먼저 넣어야 합니다. -
wait_event_interruptible()은 조건식이 참이 되면0을 반환하고, 시그널을 받으면-ERESTARTSYS를 반환합니다(wait_event()는 시그널을 무시합니다). -
wake_up()은 큐에 있는 프로세스들을 깨웁니다(배타적 대기자인 경우 예외).
커널 문서들이 설명하는 일반적인 패턴을 연결해 보면, 드라이버나 파일 시스템의 .read 경로는 읽을 데이터가 아직 없을 때 호출 프로세스를 대기 큐에 재워 두고, 나중에 데이터가 들어왔을 때 wake_up()으로 깨웁니다. 이것이 블로킹 read가 커널 안에서 기다리는 전형적인 모습입니다.
O_NONBLOCK을 켜면 무엇이 달라집니까?
한 줄 답: fcntl(2)의 F_SETFL로 O_NONBLOCK 플래그를 켜면 빈 파이프에서 read(2)가 대기하지 않고 즉시 -1(errno = EAGAIN)을 반환하며, 데이터가 있을 때는 호출 자체가 데이터를 읽어 반환하므로 여전히 동기 호출입니다.
O_NONBLOCK 설정과 EAGAIN 확인
pipe(7)에 따르면, fcntl(2)의 F_SETFL 연산으로 O_NONBLOCK 열린 파일 상태 플래그(open file status flag)를 활성화하거나 fifo(7)를 O_NONBLOCK으로 열면 논블로킹 I/O가 가능합니다. 이때 어떤 프로세스라도 파이프를 쓰기용으로 열어 두고 있다면 빈 파이프에 대한 읽기는 EAGAIN으로 실패하며, 반대로 잠재적인 쓰기 프로세스가 하나도 없다면 읽기는 성공하여 빈 결과(0)를 반환합니다. read(2)의 ERRORS 절 역시 소켓이 아닌 파일 디스크립터에 O_NONBLOCK이 표시되어 있고 읽기가 블로킹될 상황이면 EAGAIN 에러가 발생한다고 설명합니다(소켓의 경우 EAGAIN 또는 EWOULDBLOCK).
아래 nonblock_read.c는 파이프의 읽기 디스크립터에 O_NONBLOCK을 켠 뒤, 파이프가 비어 있을 때 한 번 읽고, "hello"를 쓴 뒤에 다시 한 번 읽습니다.
#include <errno.h>
#include <fcntl.h>
#include <stdio.h>
#include <string.h>
#include <unistd.h>

int main(void) {
    int fds[2];
    char buf[16];
    pipe(fds);
    fcntl(fds[0], F_SETFL, fcntl(fds[0], F_GETFL) | O_NONBLOCK);

    ssize_t n = read(fds[0], buf, sizeof buf);   /* empty pipe: returns at once */
    printf("1st read: %zd, errno=%s\n", n, n < 0 ? strerror(errno) : "-");
    printf("EAGAIN? %s\n", (n < 0 && errno == EAGAIN) ? "yes" : "no");

    write(fds[1], "hello", 5);
    n = read(fds[0], buf, sizeof buf);
    printf("2nd read: %zd: %.*s\n", n, (int)n, buf);
    return 0;
}
gcc -O0 -Wall -o nonblock_read nonblock_read.c로 빌드해 실행한 결과는 다음과 같습니다.
1st read: -1, errno=Resource temporarily unavailable
EAGAIN? yes
2nd read: 5: hello
같은 실행을 strace -e trace=read,write,fcntl ./nonblock_read로 추적한 결과입니다(동적 로더가 라이브러리를 읽는 줄은 생략했으며, 표준 출력이 리다이렉트되어 마지막 write(1, ...)에 출력이 합쳐져 있습니다).
fcntl(3, F_GETFL)                       = 0 (flags O_RDONLY)
fcntl(3, F_SETFL, O_RDONLY|O_NONBLOCK)  = 0
read(3, 0x7fffcfd05cc0, 16)             = -1 EAGAIN (Resource temporarily unavailable)
write(4, "hello", 5)                    = 5
read(3, "hello", 16)                    = 5
write(1, "1st read: -1, errno=Resource tem"..., 84) = 84
+++ exited with 0 +++
논블로킹 read가 여전히 동기인 이유
strace 출력을 보면 fcntl(3, F_SETFL, O_RDONLY|O_NONBLOCK) = 0 직후 호출한 첫 번째 read(3, ...)는 기다리지 않고 즉시 -1 EAGAIN을 반환합니다. 즉 당장 진행할 수 없을 때 대기하지 않으므로 논블로킹입니다. 이어서 write(4, "hello", 5) = 5로 데이터가 들어간 뒤 호출한 두 번째 read(3, "hello", 16) = 5는 그 호출 자체가 파이프에서 데이터를 읽어 버퍼에 채우고 바이트 수 5를 반환합니다. 호출이 반환될 때 이미 읽기 작업과 결과가 완료되어 있으므로, O_NONBLOCK read는 논블로킹이면서 동시에 동기(싱크) 호출입니다.
epoll은 논블로킹입니까, 비동기입니까?
한 줄 답: epoll은 비동기 I/O가 아니라 여러 파일 디스크립터에서 I/O가 가능한지 감시하는 준비 알림(readiness notification) API이며, epoll_wait(2)가 준비된 디스크립터를 알려주면 프로그램이 직접 read(2)를 호출합니다.
관심 목록(interest list), 준비 목록(ready list), 그리고 VFS .poll
epoll(7) 매뉴얼 페이지에 따르면, epoll API는 poll(2)와 비슷하게 여러 파일 디스크립터를 감시하여 그중 어느 것이라도 I/O가 가능한지 확인하는 역할을 합니다. 레벨 트리거(level-triggered) 또는 엣지 트리거(edge-triggered) 방식으로 동작할 수 있으며 감시 대상 디스크립터 수가 많을 때도 잘 확장됩니다. 내부 구조와 주요 시스템 콜은 다음과 같습니다.
-
epoll_create1(2)은epoll인스턴스를 생성합니다. -
epoll인스턴스는epoll_ctl(2)로 등록한 관심 목록(interest list)과, I/O 활동의 결과로 커널이 동적으로 채우는 준비 목록(ready list)을 유지합니다. -
epoll_wait(2)는 I/O 이벤트를 기다리며, 현재 사용 가능한 이벤트가 없으면 호출 스레드를 블로킹합니다.
또한 커널 VFS 문서에 따르면 struct file_operations의 .poll은 프로세스가 해당 파일에 활동이 있는지 확인하고(선택적으로 활동이 생길 때까지 잠들고자) 할 때 VFS가 호출하며, select(2)와 poll(2) 시스템 콜 등에서 사용됩니다. 하드웨어 수준에서도 상태를 반복해서 확인하는 폴링과 이벤트를 기다리는 인터럽트의 대비가 나타나는데, 그 차이는 인터럽트와 폴링 비교 글에서 확인할 수 있습니다.
epoll_pipe.c 실행과 strace 흐름
아래 epoll_pipe.c는 파이프 읽기 디스크립터에 O_NONBLOCK을 설정하고 epoll 인스턴스에 EPOLLIN 이벤트로 등록한 뒤, 자식 프로세스가 잠시 뒤 데이터를 쓸 때까지 epoll_wait()에서 대기합니다.
#include <fcntl.h>
#include <stdio.h>
#include <sys/epoll.h>
#include <sys/wait.h>
#include <unistd.h>

int main(void) {
    int fds[2];
    char buf[16];
    pipe(fds);
    fcntl(fds[0], F_SETFL, fcntl(fds[0], F_GETFL) | O_NONBLOCK);

    int ep = epoll_create1(0);
    struct epoll_event ev = { .events = EPOLLIN, .data.fd = fds[0] };
    epoll_ctl(ep, EPOLL_CTL_ADD, fds[0], &ev);

    if (fork() == 0) {                       /* child: write after 1 second */
        sleep(1);
        write(fds[1], "hello", 5);
        _exit(0);
    }
    struct epoll_event out;
    printf("waiting in epoll_wait()\n");
    fflush(stdout);
    int r = epoll_wait(ep, &out, 1, -1);     /* sleeps until the fd is readable */
    printf("epoll_wait returned %d, EPOLLIN=%s, fd=%d\n",
           r, (out.events & EPOLLIN) ? "yes" : "no", out.data.fd);
    ssize_t n = read(fds[0], buf, sizeof buf);
    printf("read: %zd: %.*s\n", n, (int)n, buf);
    wait(NULL);
    return 0;
}
gcc -O0 -Wall -o epoll_pipe epoll_pipe.c로 빌드해 실행한 출력은 다음과 같습니다.
waiting in epoll_wait()
epoll_wait returned 1, EPOLLIN=yes, fd=3
read: 5: hello
이어서 strace -f -e signal=none -e trace=epoll_create1,epoll_ctl,epoll_wait,read,write ./epoll_pipe로 확인한 발췌 결과입니다(동적 로더가 라이브러리를 읽는 줄은 생략했습니다).
365207 epoll_create1(0)                 = 5
365207 epoll_ctl(5, EPOLL_CTL_ADD, 3, {events=EPOLLIN, data=0x3}) = 0
365207 write(1, "waiting in epoll_wait()\n", 24) = 24
365207 epoll_wait(5,  <unfinished ...>
365208 write(4, "hello", 5)             = 5
365207 <... epoll_wait resumed>[{events=EPOLLIN, data=0x3}], 1, -1) = 1
365207 read(3, "hello", 16)             = 5
365208 +++ exited with 0 +++
365207 write(1, "epoll_wait returned 1, EPOLLIN=y"..., 56) = 56
365207 +++ exited with 0 +++strace에서 부모 프로세스(PID 365207)의 epoll_wait(5, <unfinished ...>는 자식 프로세스(PID 365208)가 write(4, "hello", 5) = 5를 실행할 때까지 블로킹합니다. 데이터가 써지면 epoll_wait가 깨어나 EPOLLIN 이벤트와 함께 1을 반환하고, 그 직후에 부모 프로세스가 직접 read(3, "hello", 16) = 5를 호출해 데이터를 읽어 옵니다. 즉 epoll은 “지금 읽을 준비가 되었다”고 알려줄 뿐이며, 실제 읽기 호출은 여전히 유저 프로그램이 수행합니다.
io_uring은 무엇이 비동기입니까?
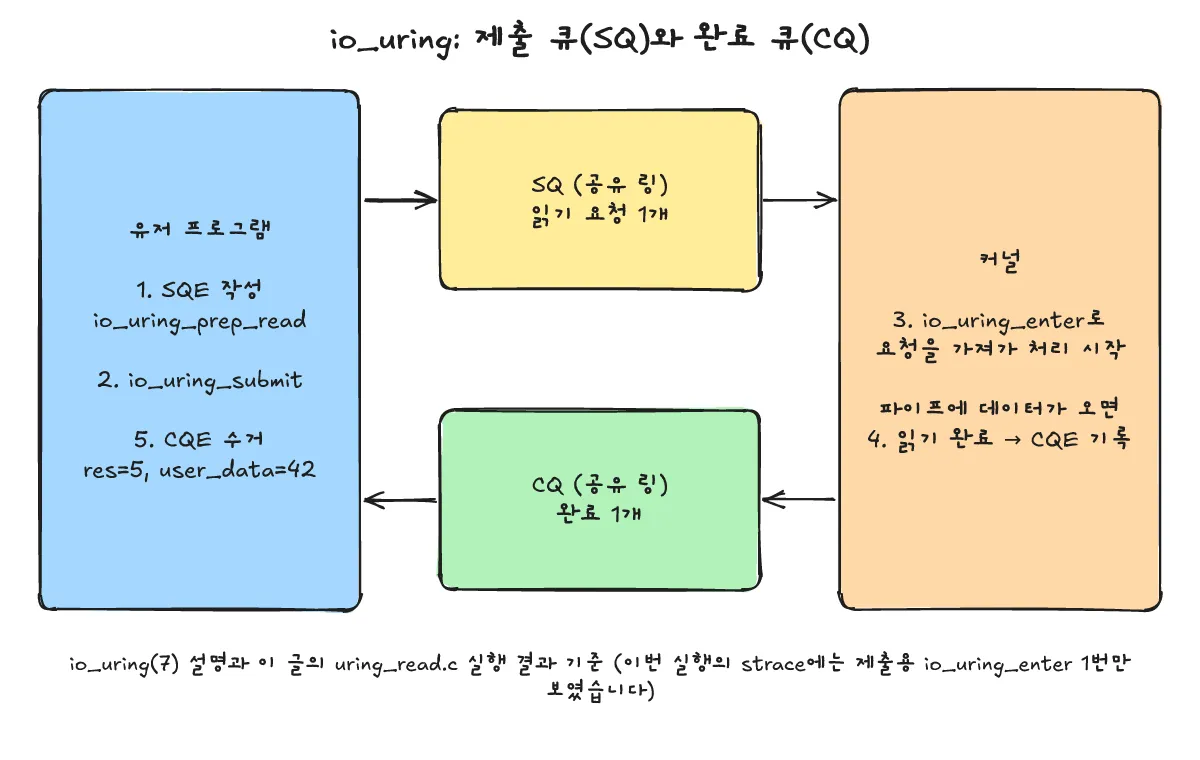
한 줄 답: io_uring은 유저 공간과 커널 공간이 공유하는 제출 큐(SQ)에 I/O 요청(SQE)을 넣어 제출하고, 커널이 처리를 끝낸 결과를 완료 큐(CQ)의 이벤트(CQE)로 나중에 수거하므로 요청 제출과 완료 수거가 분리된 비동기 I/O입니다.
제출 큐(SQ)와 완료 큐(CQ) 구조
io_uring(7) 매뉴얼 페이지에 따르면, io_uring은 리눅스 전용 비동기 I/O API로, 유저가 하나 이상의 I/O 요청을 제출하면 호출 프로세스를 블로킹하지 않고 비동기적으로 처리합니다. 핵심 동작 구조는 다음과 같습니다.
-
io_uring_setup(2)과mmap(2)을 통해 유저 공간과 커널 공간 사이에 공유되는 두 개의 링 버퍼인 제출 큐(submission queue, SQ)와 완료 큐(completion queue, CQ)를 설정합니다. -
각 요청은 제출 큐 엔트리(SQE)로 표현되며, 예를 들어
read(2)에 해당하는IORING_OP_READ같은 opcode를 담습니다. -
SQE를 추가한 뒤
io_uring_enter(2)를 호출하면 커널에 처리를 시작하라고 알립니다.io_uring_enter(2)는 선택적으로 일정 개수의 완료를 기다리는 동작도 함께 수행할 수 있습니다. -
커널은 처리가 끝나면 SQE마다 정확히 하나의 완료 큐 이벤트(CQE)를 CQ에 넣습니다. CQE의
res필드는 동일한 시스템 콜이 반환했을 값을 담으며, 에러가 발생한 경우에는-errno값을 담습니다(errno변수는 사용되지 않습니다).
아래 예제는 liburing 헬퍼 라이브러리(io_uring_queue_init, io_uring_get_sqe, io_uring_prep_read, io_uring_submit, io_uring_peek_cqe, io_uring_wait_cqe, io_uring_cqe_seen, io_uring_queue_exit)를 사용합니다.
uring_read.c 실행과 strace 관찰
아래 uring_read.c는 파이프에 데이터가 전혀 없는 상태에서 먼저 읽기 요청(SQE, user_data = 42)을 제출하고, 완료 여부를 한 번 확인(io_uring_peek_cqe)한 뒤, 파이프에 "hello"를 쓰고 완료 이벤트(io_uring_wait_cqe)를 수거합니다.
#include <liburing.h>
#include <stdio.h>
#include <unistd.h>

int main(void) {
    struct io_uring ring;
    int fds[2];
    char buf[16];
    pipe(fds);
    if (io_uring_queue_init(4, &ring, 0) < 0) { printf("io_uring_queue_init failed\n"); return 1; }

    struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
    io_uring_prep_read(sqe, fds[0], buf, sizeof buf, 0);   /* ask the kernel to read */
    sqe->user_data = 42;
    int s = io_uring_submit(&ring);
    printf("submitted %d request(s); no data in the pipe yet\n", s);

    struct io_uring_cqe *cqe;
    printf("peek before write: %s\n",
           io_uring_peek_cqe(&ring, &cqe) == 0 ? "completed" : "not completed yet");

    write(fds[1], "hello", 5);                /* data arrives later */
    io_uring_wait_cqe(&ring, &cqe);           /* collect the completion */
    printf("completion: user_data=%llu res=%d data=%.*s\n",
           (unsigned long long)cqe->user_data, cqe->res, cqe->res, buf);
    io_uring_cqe_seen(&ring, cqe);
    io_uring_queue_exit(&ring);
    return 0;
}
gcc -O0 -Wall -o uring_read uring_read.c -luring으로 경고 없이 빌드해 실행한 출력은 다음과 같습니다.
submitted 1 request(s); no data in the pipe yet
peek before write: not completed yet
completion: user_data=42 res=5 data=hello
이어서 strace -e trace=io_uring_setup,io_uring_enter,write,read ./uring_read로 추적한 결과입니다(동적 로더가 라이브러리를 읽는 줄은 생략했습니다).
io_uring_setup(4, {flags=IORING_SETUP_NO_SQARRAY, sq_thread_cpu=0, sq_thread_idle=0, sq_entries=4, cq_entries=8, features=IORING_FEAT_SINGLE_MMAP|IORING_FEAT_NODROP|IORING_FEAT_SUBMIT_STABLE|IORING_FEAT_RW_CUR_POS|IORING_FEAT_CUR_PERSONALITY|IORING_FEAT_FAST_POLL|IORING_FEAT_POLL_32BITS|IORING_FEAT_SQPOLL_NONFIXED|IORING_FEAT_EXT_ARG|IORING_FEAT_NATIVE_WORKERS|IORING_FEAT_RSRC_TAGS|IORING_FEAT_CQE_SKIP|IORING_FEAT_LINKED_FILE|IORING_FEAT_REG_REG_RING|IORING_FEAT_RECVSEND_BUNDLE|IORING_FEAT_MIN_TIMEOUT, sq_off={head=0, tail=4, ring_mask=16, ring_entries=24, flags=36, dropped=32, array=0, user_addr=0}, cq_off={head=8, tail=12, ring_mask=20, ring_entries=28, overflow=44, cqes=64, flags=40, user_addr=0}}) = 5
io_uring_enter(5, 1, 0, 0, NULL, 8)     = 1
write(4, "hello", 5)                    = 5
write(1, "submitted 1 request(s); no data "..., 127) = 127
+++ exited with 0 +++
출력과 strace를 함께 보면, 파이프에 데이터가 아직 없을 때 읽기 요청이 먼저 제출(io_uring_enter(5, 1, 0, 0, NULL, 8) = 1)되었고, 쓰기 전 io_uring_peek_cqe에서는 not completed yet이 확인되었습니다. 그 뒤 write(4, "hello", 5) = 5로 데이터가 들어가자, 유저 프로그램이 별도로 파이프에 대한 read(3, ...) 시스템 콜을 호출하지 않았는데도 완료 이벤트에서 user_data=42 res=5 data=hello를 수거했습니다. 또한 이번 실행에서는 strace에 제출 시점의 io_uring_enter 한 번만 나타나고 대기 시점에는 추가 io_uring_enter가 나타나지 않았는데, 완료 결과는 공유 메모리에 있는 완료 큐(CQ) 링에서 수거되었습니다.
상황별로 무엇을 고르면 됩니까?
한 줄 답: 네 가지 예제는 데이터가 없을 때 대기하는지, 누가 실제로 데이터를 읽는지, 완료를 어떻게 알게 되는지가 서로 다르므로 프로그램의 제어 흐름에 맞게 선택합니다.
네 가지 파이프 읽기 예제 비교 표
지금까지 살펴본 네 가지 프로그램의 동작을 호출 방식, 빈 파이프에서의 대기 여부, 실제 읽기 수행 주체, 완료 확인 방식으로 정리하면 아래 표와 같습니다.
| 예제 / 호출 | 데이터가 없을 때 대기 여부 | 누가 I/O(읽기)를 수행하는가 | 완료를 알게 되는 방식 |
|---|---|---|---|
blocking_read.c (기본 read(2)) | read(2)가 커널 안에서 데이터가 올 때까지 블로킹 | read(2) 시스템 콜 자체가 수행 | read(2)가 읽은 바이트 수(5)를 반환하며 복귀 |
nonblock_read.c (O_NONBLOCK + read(2)) | 대기하지 않고 즉시 -1(EAGAIN) 반환 | 데이터가 있을 때 호출한 read(2) 자체가 수행 | 성공한 read(2)가 읽은 바이트 수(5)를 반환하며 복귀 |
epoll_pipe.c (epoll_wait(2) + read(2)) | epoll_wait(2)가 디스크립터가 준비될 때까지 블로킹 | 준비 알림을 받은 뒤 유저 프로그램이 호출한 read(2)가 수행 | epoll_wait(2)가 EPOLLIN 준비를 알리고, 이어진 read(2)가 바이트 수 반환 |
uring_read.c (io_uring SQ/CQ) | 요청 제출(io_uring_submit)은 데이터가 없어도 바로 반환(완료 대기는 별도) | 제출된 SQE(IORING_OP_READ)에 따라 커널이 비동기 수행 | 완료 큐(CQ)에서 수거한 CQE의 res(5)와 user_data(42)로 확인 |
-
단일 파일 디스크립터에서 데이터가 올 때까지 현재 흐름이 그대로 기다려도 된다면 기본 블로킹
read(2)로 충분합니다. -
호출 시점에 스레드가 멈추지 않고 당장 읽을 수 없으면
EAGAIN을 받아 다른 일을 처리해야 한다면O_NONBLOCK을 켭니다. -
여러 파일 디스크립터를 감시하다가 I/O가 가능한 디스크립터만 골라 직접
read(2)를 호출하는 이벤트 루프 구조라면epoll(7)과O_NONBLOCK을 조합합니다. -
요청 제출과 완료 수거를 분리해 공유 링 버퍼(SQ/CQ)로 비동기 I/O를 처리하려는 구조라면
io_uring(7)을 사용합니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: O_NONBLOCK read의 동기 여부, 쓰기 프로세스가 없을 때의 파이프 읽기 반환값, 그리고 io_uring의 에러 확인 방식을 정리했습니다.
O_NONBLOCK을 설정한 read(2)는 비동기 I/O입니까?
아닙니다. `O_NONBLOCK`을 켜면 데이터가 없을 때 기다리지 않고 즉시 `-1`(`EAGAIN`)을 반환하므로 논블로킹이지만, 데이터가 있을 때는 `read(2)` 호출 자체가 데이터를 버퍼에 읽어들인 뒤 결과를 들고 복귀하므로 동기 호출입니다.파이프를 쓰기용으로 열어 둔 프로세스가 하나도 없을 때 O_NONBLOCK read(2)는 무엇을 반환합니까?
`pipe(7)`에 따르면, 어떤 프로세스라도 파이프를 쓰기용으로 열어 두고 있을 때 빈 파이프를 읽으면 `EAGAIN`으로 실패하지만, 잠재적인 쓰기 프로세스가 하나도 없다면 `read(2)`는 성공하여 빈 결과(`0`)를 반환합니다.io_uring의 완료 큐 이벤트(CQE)에서는 에러를 어떻게 확인합니까?
`io_uring(7)`에 따르면, CQE는 `errno` 변수를 사용하지 않으며 `res` 필드에 동일한 시스템 콜이 반환했을 값을 담습니다. 에러가 발생한 경우 `res` 필드에 `-errno` 값이 들어갑니다.함께 보면 좋은 글은 무엇입니까?
한 줄 답: 시스템 콜 추적 도구인 strace, 하드웨어 수준의 인터럽트와 폴링 비교, 그리고 유저 공간에서 커널로 진입하는 시스템 콜 흐름을 다룬 관련 글입니다.
출처는 어디입니까?
한 줄 답: 이 글에서 참고한 리눅스 매뉴얼 페이지 네 편과 리눅스 커널 공식 문서 두 편입니다.
-
pipe(7) — Linux manual page (확인 2026-11-04)
-
read(2) — Linux manual page (확인 2026-11-04)
-
epoll(7) — Linux manual page (확인 2026-11-04)
-
io_uring(7) — Linux manual page (확인 2026-11-04)
-
Linux kernel docs: Unreliable Guide To Hacking The Linux Kernel (Wait Queues) (확인 2026-11-04)
-
Linux kernel docs: Overview of the Linux Virtual File System (확인 2026-11-04)