핵심 요약
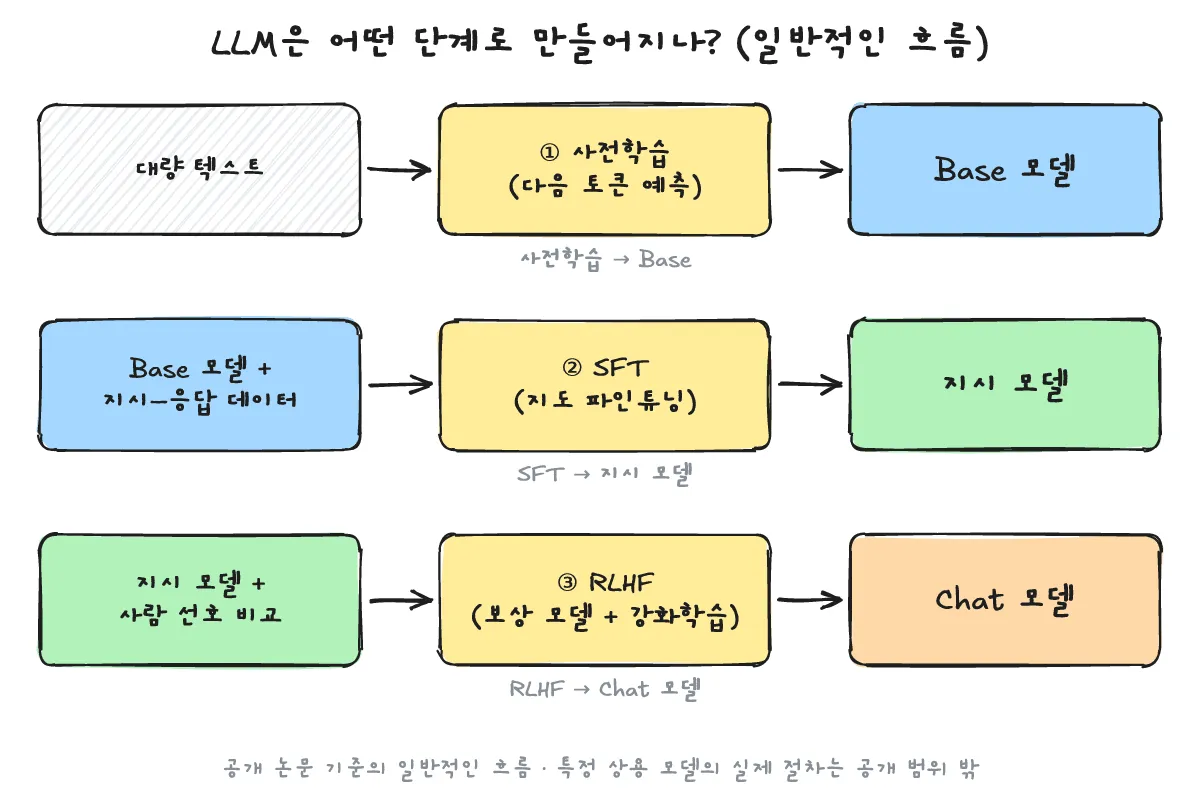
사전학습 파인튜닝 RLHF 차이를 한 줄로 요약하면, LLM은 일반적으로 ① 사전학습(다음 토큰 예측 → Base 모델), ② 파인튜닝/SFT(지시–응답 예시 → 지시를 따르는 모델), ③ RLHF(사람 선호 반영 → 대화형 모델) 순서로 만들어집니다. 이 글에서는 이러한 일반적인 흐름을 다룹니다.
이 글은 SK하이닉스 AI 해커톤 1차 예선(10/17–18)을 준비하며 정리하는 AI 공부 노트 시리즈입니다. Day1에서 다룬 Self-Attention과 Day2에서 다룬 Transformer 등 Day1–4 내용이 모델을 추론하고 사용하는 축이었다면, 이번 글에서는 모델을 만드는 ‘학습’ 축을 살펴봅니다.
전체 흐름을 세 단계로 나누면 다음과 같습니다.
- ① 사전학습: 대량 텍스트로 다음 토큰 예측을 반복해 Base 모델을 만듭니다.
- ② 파인튜닝(SFT): 지시–응답 예시 데이터로 추가 학습해 지시를 따르는 모델을 만듭니다.
- ③ RLHF: 사람의 선호를 반영한 보상 모델을 만들고, 강화학습을 거쳐 대화형(Chat) 모델을 완성합니다. 이는 InstructGPT 논문에 정리된 일반적인 흐름으로, 특정 상용 모델의 실제 학습 절차와 완전히 동일하다고 단정할 수는 없습니다.
사전학습이란? 다음 토큰 예측으로 무엇을 배우나?
한 줄 답: 대량 텍스트로 ‘다음 토큰 맞히기’를 반복해 언어와 지식 패턴을 익힌 Base 모델을 만드는 단계입니다.
- 사전학습: 대량 텍스트에서 ‘다음 토큰 맞히기’를 반복하며 언어와 지식 패턴을 학습합니다. 텍스트 자체가 정답 역할을 하므로 사람이 직접 정답 라벨을 달 필요가 없습니다(자기지도 학습).
- Base 모델 특징: 문장을 자연스럽게 이어 쓰는 데는 뛰어나지만, 질문에 답하거나 지시를 따르는 대화형 모델은 아닙니다. 예를 들어 질문을 입력하면 그와 비슷한 질문을 계속 이어 쓸 수도 있습니다.
- 학습 vs 추론: 학습은 가중치를 업데이트하는 과정이고, 추론은 가중치를 고정한 상태에서 토큰을 생성하는 과정입니다. 추론에 대한 자세한 내용은 Day3 글을 참고해 주세요.
파인튜닝(SFT) vs 프롬프트 차이: 모델을 바꾸나, 입력을 바꾸나?
한 줄 답: 파인튜닝은 지시–응답 데이터로 가중치를 추가 학습하는 반면, 프롬프트는 가중치를 고정하고 입력만 다르게 설계합니다.
- SFT(지도 파인튜닝): 사람이 작성한 지시–응답 예시 데이터로 가중치를 추가 학습시켜, 모델이 지시를 잘 따르도록 만듭니다.
- 프롬프트: 모델의 가중치는 건드리지 않고 입력만 설계합니다. 프롬프트 설계 방법은 Day4 프롬프트 엔지니어링 글에서 자세히 다룹니다.
- LoRA: 기존 사전학습 가중치는 고정해 두고, 각 층에 작은 저랭크(low-rank) 행렬 쌍(어댑터)만 추가로 학습시키는 방법입니다. 학습할 파라미터 수와 메모리 부담을 줄여줍니다. (Hu et al., 2021)
- 각 방식의 차이를 표로 정리하면 다음과 같습니다.
| 방식 | 바뀌는 것 | 필요한 것 | 언제 |
|---|---|---|---|
| 프롬프트 | 입력(가중치 그대로) | 잘 설계한 지시·예시 | 모델을 바꾸지 않고 빠르게 시도할 때 |
| SFT(전체 파인튜닝) | 모델 가중치 전체 | 지시–응답 예시 데이터·학습 자원 | 특정 형식·도메인 동작을 모델에 학습시킬 때 |
| LoRA | 작은 어댑터 가중치(원래 가중치 고정) | 예시 데이터·상대적으로 적은 학습 자원 | 자원이 제한된 상태에서 파인튜닝할 때 |
RLHF란? 사람 선호를 모델에 어떻게 반영하나?
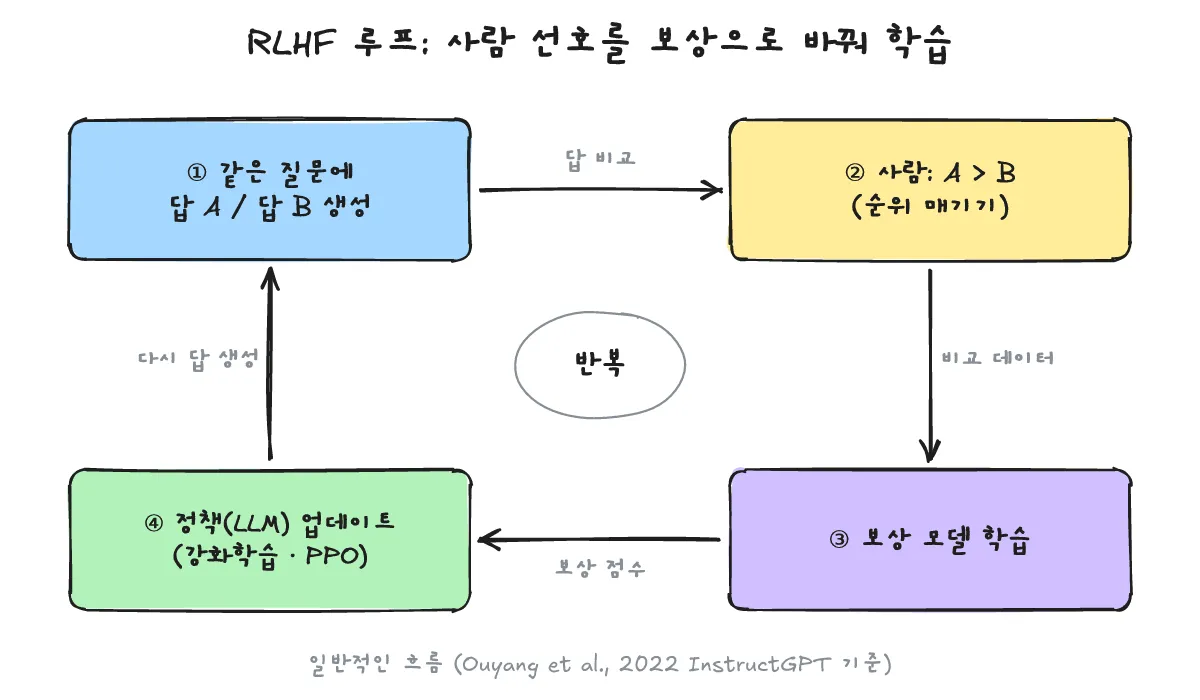
한 줄 답: 모델의 여러 답변에 대해 사람이 매긴 순위로 보상 모델을 먼저 학습시키고, 이후 사람이 선호하는 방향으로 강화학습을 진행합니다.
- 일반적인 흐름(InstructGPT 기준): 같은 질문에 대해 모델이 여러 답변을 생성하면 사람이 선호도 순위를 매깁니다. 이 비교 데이터로 보상 모델(reward model)을 학습시킨 뒤, 보상이 극대화되도록 강화학습(PPO)을 통해 LLM(정책)을 업데이트합니다. (Ouyang et al., 2022)
- 목적: 도움이 되고(helpful), 해롭지 않으며(harmless), 정직한(honest) 답변 등 사람이 선호하는 방향으로 모델을 맞추기 위함입니다(정렬, alignment).
- 대안: 보상 모델과 강화학습 단계를 생략하고, 선호 데이터로 모델을 직접 학습시키는 DPO 같은 방식도 활용됩니다.
- 3단계 요약: 정리하자면 사전학습은 언어와 지식을 배우는 단계, SFT는 지시를 따르게 훈련하는 단계, RLHF는 사람의 선호에 맞게 모델을 교정하는 단계입니다.
[시험용 한 줄] LLM은 사전학습(Base 모델) → 파인튜닝/SFT(지시를 따르는 모델) → RLHF(사람 선호를 반영한 대화형 모델) 순서로 만들어진다는 큰 흐름을 기억해 두시면 좋습니다.
배운 내용을 퀴즈로 확인해 볼까요?
Q1. 사전학습 단계에서는 사람이 정답을 일일이 알려주어야 합니까?
A1. 아닙니다. 주어진 텍스트 자체가 정답 역할을 하는 ‘다음 토큰 맞히기’를 반복하므로, 별도로 정답 라벨을 달 필요가 없는 자기지도 학습 방식을 사용합니다.
Q2. 파인튜닝과 프롬프트의 핵심적인 차이는 무엇입니까?
A2. 파인튜닝은 가중치 자체를 추가 학습하여 모델을 직접 변경하는 반면, 프롬프트는 모델 가중치는 그대로 둔 채 입력 형식만 다르게 설계하는 방식입니다.
Q3. LoRA 방식이 학습 자원을 절약할 수 있는 이유는 무엇입니까?
A3. 사전학습 가중치는 그대로 고정하고, 각 신경망 층에 크기가 작은 저랭크 어댑터만 추가하여 학습시키기 때문입니다.
Q4. RLHF 과정에서 사람은 어떤 역할을 합니까?
A4. 모델이 생성한 여러 답변에 대해 선호도 순위를 매김으로써, 보상 모델이 사람의 선호 기준을 학습할 수 있도록 비교 데이터를 제공합니다.