양자화(Quantization)란? FP16·INT8·INT4 차이와 LLM 메모리가 줄어드는 이유
핵심 요약
LLM 양자화란 모델의 가중치를 더 적은 비트 수로 근사해 저장함으로써 메모리 사용량과 읽어야 할 데이터량을 줄이는 기술입니다. 다만 숫자의 표현 정밀도가 낮아지는 만큼 정확도가 함께 떨어질 가능성이 있으며, 그 정도는 모델과 방법에 따라 달라집니다.
이 글은 SK하이닉스 AI 해커톤 1차 예선(10/17–18)을 준비하며 정리하는 AI 공부 노트 시리즈입니다. Day1에서 다룬 Self-Attention과 Day2에서 다룬 Transformer 구조에 이어, 오늘은 숫자를 표현하는 비트 수를 줄이는 ‘양자화(Quantization)‘를 정리합니다. 양자화는 특히 Day3에서 다룬 Decode 과정(토큰 1개를 만들 때마다 가중치를 메모리에서 다시 읽어오는 memory-bound 특성)의 문제와 깊이 연결되어 있습니다.
양자화란? 숫자 비트 수를 줄이면 무엇이 바뀌나?
한 줄 답: 가중치(필요한 경우 활성값)를 더 적은 비트의 숫자로 근사해 저장하고 계산하는 기술입니다.
- 양자화는 모델의 가중치를 더 적은 비트 수로 근사하여 저장하고 계산하는 기술입니다. 고해상도 사진을 압축 사진으로 바꿀 때 색상 눈금의 개수가 줄어드는 것과 같은 원리로 이해하면 됩니다.
- 비트 수를 줄이면 메모리 사용량과 읽어야 할 데이터의 크기가 줄어듭니다. 다만 숫자의 표현 정밀도가 낮아지면서 정확도 손실이 발생할 가능성이 함께 생기며, 그 정도는 모델과 양자화 방법에 따라 다릅니다.
- 관련 용어로는 학습을 마친 모델에 적용하는 PTQ(학습 후 양자화)와 학습 과정에서부터 양자화를 고려하는 QAT(양자화 인지 학습)가 있습니다. GPTQ·AWQ·GGUF 같은 이름도 자주 언급되지만, 이 글에서는 이름만 소개하며 방식 간 비교는 다루지 않습니다.
FP16 vs INT8 vs INT4 차이: 메모리·속도·정확도는 어떻게 갈리나?
한 줄 답: FP16 대비 INT8은 메모리가 절반, INT4는 4분의 1 수준으로 줄어들지만, 정확도 하락 위험은 그만큼 커질 수 있습니다.
- 파라미터 1개를 저장하는 데 필요한 바이트 수는 FP16이 2바이트(16비트), INT8이 1바이트(8비트), INT4가 0.5바이트(4비트)입니다. 비트 수를 8로 나누면 바이트 수가 됩니다.
- 단순 산술 예시로, 파라미터가 70억 개(7B)인 모델이라면 가중치만 계산했을 때 메모리는 대략 FP16 14GB, INT8 7GB, INT4 3.5GB 수준으로 줄어듭니다. 이 수치는 가중치만 계산한 것이며, KV Cache·활성값·런타임 오버헤드는 포함하지 않았습니다. 실제 모델 파일 크기는 저장 형식과 메타데이터에 따라 달라집니다.
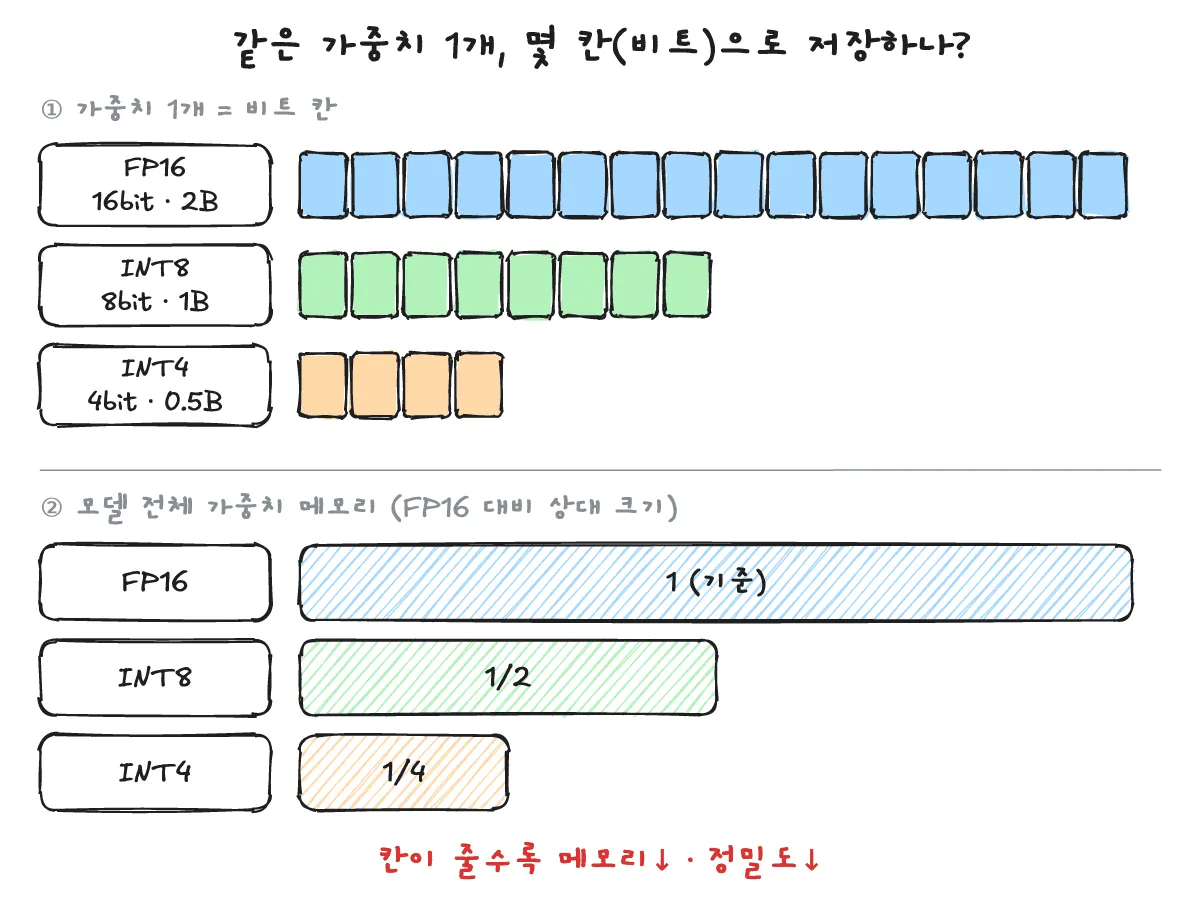
- 형식별 차이를 표로 정리하면 다음과 같습니다.
| 형식 | 비트 | 바이트/파라미터 | 메모리(FP16 대비) | 정확도 위험(정성) |
|---|---|---|---|---|
| FP16 | 16 | 2 | 1 (기준) | 낮음 |
| INT8 | 8 | 1 | 1/2 | 중간 (FP16보다 커질 수 있음) |
| INT4 | 4 | 0.5 | 1/4 | 가장 높음 |
위 표의 정확도 위험은 정성적인 경향만을 나타낸 것이며, 구체적인 하락 폭은 모델과 방법에 따라 다릅니다.
- 연산 속도는 단순히 비트 수가 줄었다고 항상 빨라지는 것은 아닙니다. 하드웨어가 INT8·INT4 연산을 지원하는지, 그리고 어떤 커널을 사용하는지에 따라 속도 향상 폭이 달라지므로 단정할 수 없습니다.
양자화는 Decode의 메모리 대역폭(HBM) 문제와 어떻게 연결되나?
한 줄 답: 가중치 크기가 줄어들면 토큰 1개당 HBM에서 읽어야 하는 데이터량이 줄어들어 대역폭 병목이 완화됩니다.
- Day3에서 다룬 것처럼 Decode 단계는 토큰 1개를 만들 때마다 가중치를 HBM에서 다시 읽어오는 memory-bound 특성을 가지고 있습니다.
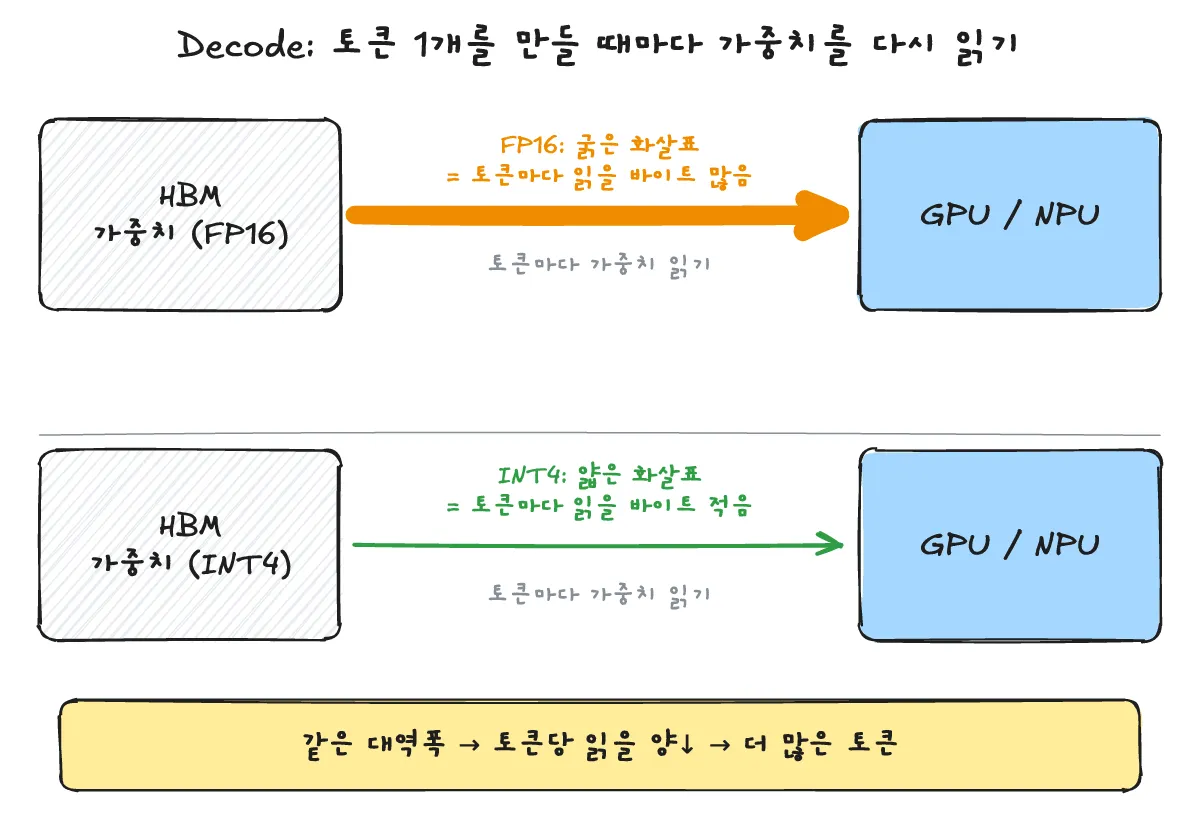
- 가중치 크기가 작아지면 토큰 1개당 읽어야 할 바이트 수가 줄어들어, 동일한 대역폭에서 유리해집니다. FP16에서 INT4로 바꾸면 읽어야 할 가중치 바이트는 산술적으로 4분의 1이 됩니다.
- AI 반도체 관점에서는 연산력만큼이나 “얼마나 적게, 얼마나 빠르게 읽어오느냐”가 중요합니다. 가중치뿐 아니라 KV Cache 역시 양자화의 대상이 될 수 있다는 점도 함께 짚어둡니다.
[시험용 한 줄] 양자화 = 가중치를 더 적은 비트로 근사 → 메모리·읽을 데이터량이 줄어들지만 정밀도도 함께 낮아집니다. Decode가 memory-bound 특성을 가지기 때문에 이 효과가 크게 나타납니다.
배운 내용을 퀴즈로 확인해 볼까요?
Q1. 파라미터를 16비트에서 4비트로 양자화하면 가중치 메모리는 어떻게 변합니까?
A1. 산술적으로 4분의 1 크기로 줄어듭니다(FP16은 2바이트, INT4는 0.5바이트).
Q2. 양자화를 적용할 때 가장 주의해야 할 트레이드오프는 무엇입니까?
A2. 숫자의 표현 정밀도가 낮아지면서 발생할 수 있는 모델 정확도 손실입니다.
Q3. LLM의 Decode 과정에서 양자화가 특히 효과를 발휘하는 이유는 무엇입니까?
A3. Decode는 토큰마다 HBM에서 가중치를 반복해서 읽어야 하는 memory-bound 특성을 가지므로, 읽어야 할 데이터량이 줄어들면 대역폭 병목이 크게 완화되기 때문입니다.
다음 글: Day4 프롬프트 엔지니어링