핵심 요약
음성 인식 STT는 연속적인 아날로그 소리 파형을 1초에 16,000개의 숫자(16 kHz)로 샘플링하고, 사람의 청각 특성을 반영한 2D 멜 스펙트로그램으로 변환한 뒤 Transformer 인코더-디코더 모델이 텍스트 토큰을 순차적으로 예측해 글자로 바꾸는 기술입니다. 대규모 서버 자원을 활용하는 클라우드 방식과 달리, 온디바이스 음성 인식은 기기 내부에서 경량화된 모델을 직접 구동합니다. 따라서 네트워크 지연 없이 오프라인에서도 동작하며 음성 데이터가 외부로 유출되지 않는 반면, 기기의 연산 성능과 메모리 용량에 따른 모델 크기의 제약을 받습니다.
음성 비서, 실시간 자막, 회의록 요약 등 일상에서 널리 쓰이는 서비스의 핵심에는 음성 인식 STT 기술이 있습니다. 이번 글에서는 소리 파형이 디지털 숫자와 멜 스펙트로그램을 거쳐 텍스트로 완성되는 과정부터, 서버 중심의 클라우드 STT와 기기 내에서 동작하는 온디바이스 음성 인식의 핵심 차이점, 그리고 인식 오류가 발생하는 원인까지 한눈에 살펴봅니다. 모델 구조는 OpenAI Whisper의 공식 공개 자료(GitHub README, audio.py)를 기준으로 정리했으며, 멜 스펙트로그램 변환 과정은 실제 파이썬 코드를 실행한 결과를 함께 담았습니다.
음성 인식 STT 원리는 무엇이며, 소리는 어떻게 멜 스펙트로그램과 숫자가 되나요?
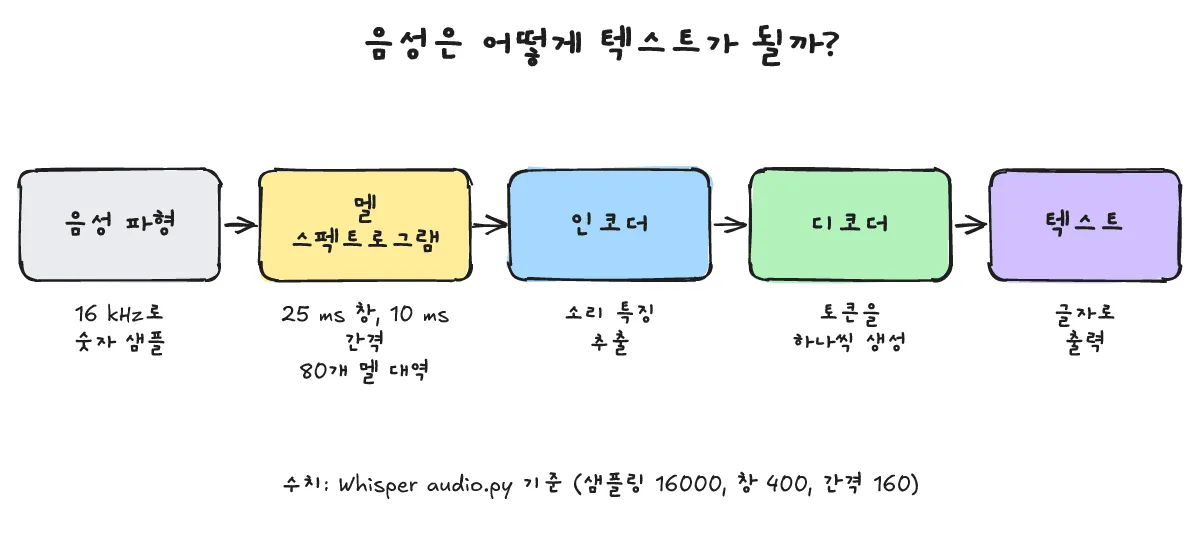
한 줄 답: 마이크로 유입된 연속적인 아날로그 음성을 일정한 간격으로 측정해 디지털 숫자로 변환하고, 이를 짧은 구간으로 나누어 사람의 청각 특성을 반영한 2D 이미지인 멜 스펙트로그램으로 변환합니다. 이는 클라우드 환경뿐만 아니라 온디바이스 음성 인식에서도 모델 입력을 만들기 위해 거치는 필수적인 전처리 과정입니다.
- 샘플링(Sampling): 공기 압력의 연속적인 변화를 일정한 시간 간격으로 측정해 숫자 열로 변환합니다. Whisper의
audio.py에서는SAMPLE_RATE = 16000을 사용하므로, 1초 동안 16,000개의 소리 값을 추출합니다. - 짧은 구간(Window) 분할: 소리의 물리적 특성은 아주 짧은 시간 동안에는 일정하게 유지된다고 가정합니다. 따라서 25 ms 길이의 창(
N_FFT = 400)을 10 ms 간격(HOP_LENGTH = 160)으로 이동시키며 신호를 잘라냅니다. - 주파수 분석과 멜 필터(Mel Filterbank): 각 창에 윈도우 함수를 적용한 뒤 고속 푸리에 변환(FFT)을 수행해 주파수별 에너지를 계산합니다. 여기에 저주파의 미세한 변화를 고주파보다 더 잘 구분하는 사람의 청각 특성을 반영하고자 멜 스케일 필터를 적용하고 로그를 취합니다. Whisper는 모델에 따라 80개 또는 128개의 멜 필터를 사용합니다. 그 결과 가로축은 시간, 세로축은 주파수 대역, 각 픽셀값은 에너지 강도를 나타내는 2D 로그 멜 스펙트로그램이 완성됩니다.
- Whisper의 30초 청크 단위 처리:
audio.py기준 30초 단위 청크는 총 480,000개의 샘플(N_SAMPLES)로 구성되며, 이는 3,000개의 멜 프레임(N_FRAMES, 초당 100프레임)으로 변환되어 모델에 입력됩니다.
실제 실행 결과(Python 3 · NumPy 2.5.3): 아래 코드는 Whisper와 같은 파라미터(16 kHz, 창 400, 이동 160, 멜 80개)를 NumPy만으로 흉내 낸 간이 데모이며, 1초짜리 440 Hz 테스트 톤을 입력으로 썼습니다. Whisper의 실제 구현 코드 전체는 아닙니다.
# Whisper-style log-mel front end, numpy only (sr=16000, n_fft=400, hop=160, n_mels=80)
import numpy as np
SR, N_FFT, HOP, N_MELS = 16000, 400, 160, 80

def hz_to_mel(f): return 2595 * np.log10(1 + f / 700)
def mel_to_hz(m): return 700 * (10 ** (m / 2595) - 1)

def mel_filterbank():
    mels = np.linspace(hz_to_mel(0), hz_to_mel(SR / 2), N_MELS + 2)
    bins = np.floor((N_FFT + 1) * mel_to_hz(mels) / SR).astype(int)
    fb = np.zeros((N_MELS, N_FFT // 2 + 1))
    for i in range(1, N_MELS + 1):
        l, c, r = bins[i - 1], bins[i], bins[i + 1]
        fb[i - 1, l:c] = (np.arange(l, c) - l) / max(c - l, 1)
        fb[i - 1, c:r] = (r - np.arange(c, r)) / max(r - c, 1)
    return fb

t = np.arange(SR) / SR                      # 1 second
wave = 0.5 * np.sin(2 * np.pi * 440 * t)    # 440 Hz test tone
frames = np.lib.stride_tricks.sliding_window_view(wave, N_FFT)[::HOP]
spec = np.abs(np.fft.rfft(frames * np.hanning(N_FFT), axis=1)) ** 2
mel = np.log10(np.maximum(spec @ mel_filterbank().T, 1e-10)).T
print("samples:", wave.shape[0])
print("frames x fft bins:", spec.shape)
print("log-mel shape (mels x frames):", mel.shape)
print("loudest mel band:", int(mel.mean(axis=1).argmax()))
실제 출력은 다음과 같습니다.
samples: 16000
frames x fft bins: (98, 201)
log-mel shape (mels x frames): (80, 98)
loudest mel band: 15
1초 분량의 16 kHz 오디오는 16,000개의 숫자로 표현됩니다. 신호에 별도의 패딩을 두지 않고 25 ms 창을 10 ms 간격으로 이동시키면 98개 프레임이 계산되며(Whisper는 입력 신호에 패딩을 적용해 30초당 3,000프레임, 즉 초당 100프레임을 맞춥니다), 각 프레임마다 80개의 멜 값이 도출되어 최종적으로 80×98 크기의 ‘소리 이미지’가 생성됩니다. 단일 주파수인 440 Hz 톤은 상대적으로 저주파 대역에 해당하는 15번 멜 밴드에서 에너지가 가장 크게 측정되었습니다.
STT 모델은 스펙트로그램을 어떻게 글자로 바꾸나요?
한 줄 답: Transformer 인코더가 멜 스펙트로그램을 음향 특징 벡터 열로 변환하고, 디코더가 이 특징과 이전에 생성된 토큰들을 종합하여 다음 텍스트 토큰을 하나씩 순서대로 예측합니다.
- 통합 sequence-to-sequence 모델: Whisper README는 “다국어 음성 인식, 음성 번역, 언어 식별, 음성 활동 감지를 포함한 여러 음성 처리 작업으로 Transformer sequence-to-sequence 모델을 학습하며, 이 작업들이 디코더가 예측할 토큰 열로 함께 표현되어 하나의 모델이 기존 음성 처리 파이프라인의 여러 단계를 대체할 수 있다”고 설명합니다(openai/whisper의 요지 번역).
- 인코더와 디코더의 역할: 인코더는 2D 로그 멜 스펙트로그램을 입력받아 고차원 음향 특징 벡터 열을 추출합니다. 디코더는 이 음향 특징과 직전 단계까지 생성한 텍스트 토큰을 참조하여 다음 토큰을 차례대로 예측합니다. 모델이 텍스트 조각을 다루는 기본 단위가 궁금하시다면 토큰과 컨텍스트 윈도우란? 글을 참고해 주시기 바랍니다.
- 전통적인 방식과의 차이점: HN 토론에 따르면, 과거에는 사전에 정의된 템플릿과 문법 규칙으로 범위를 제한하여 음성을 인식하는 방식이 주로 활용되었습니다(HN 스레드). 반면 최근의 End-to-End 모델은 하나의 단일 신경망이 소리 입력부터 텍스트 출력까지 직접 학습한다는 점에서 큰 차이가 있습니다.
클라우드 STT와 온디바이스 STT는 무엇이 다른가요?
한 줄 답: 클라우드 STT는 고성능 서버에서 대규모 모델로 음성을 처리하며, 온디바이스 STT는 기기 내에서 경량화 모델을 구동하여 지연 시간 단축, 개인정보 보호, 오프라인 사용성에서 장점을 갖는 대신 모델 크기와 연산 능력의 제약을 받습니다. 아래 비교는 정성적인 분석이며, 별도의 속도나 정확도 측정값을 의미하지는 않습니다.
- 지연 시간(Latency): 클라우드 STT는 오디오 데이터를 서버로 전송하고 결과를 수신하는 네트워크 왕복 시간이 필수적입니다. 반면 온디바이스 STT는 기기 자체에서 실시간으로 연산하므로 네트워크 지연이 발생하지 않습니다.
- 개인정보 보호(Privacy): 클라우드 STT는 사용자의 음성 데이터가 외부 서버로 전송됩니다. 온디바이스 STT는 모든 음성 데이터 처리가 기기 내부에서 완료되므로 데이터가 외부로 나가지 않습니다.
- 오프라인 동작(Offline): 온디바이스 STT는 인터넷 연결이 불가능한 환경에서도 정상 작동합니다. 반면 클라우드 STT는 안정적인 네트워크 접속이 반드시 필요합니다.
- 정확도와 모델 크기의 트레이드오프: 서버 인프라는 거대한 모델과 풍부한 메모리 자원을 활용할 수 있지만, 스마트폰이나 엣지 기기는 메모리, 배터리 소모, 발열 등의 하드웨어 제약으로 인해 모델 크기를 줄여야 합니다.
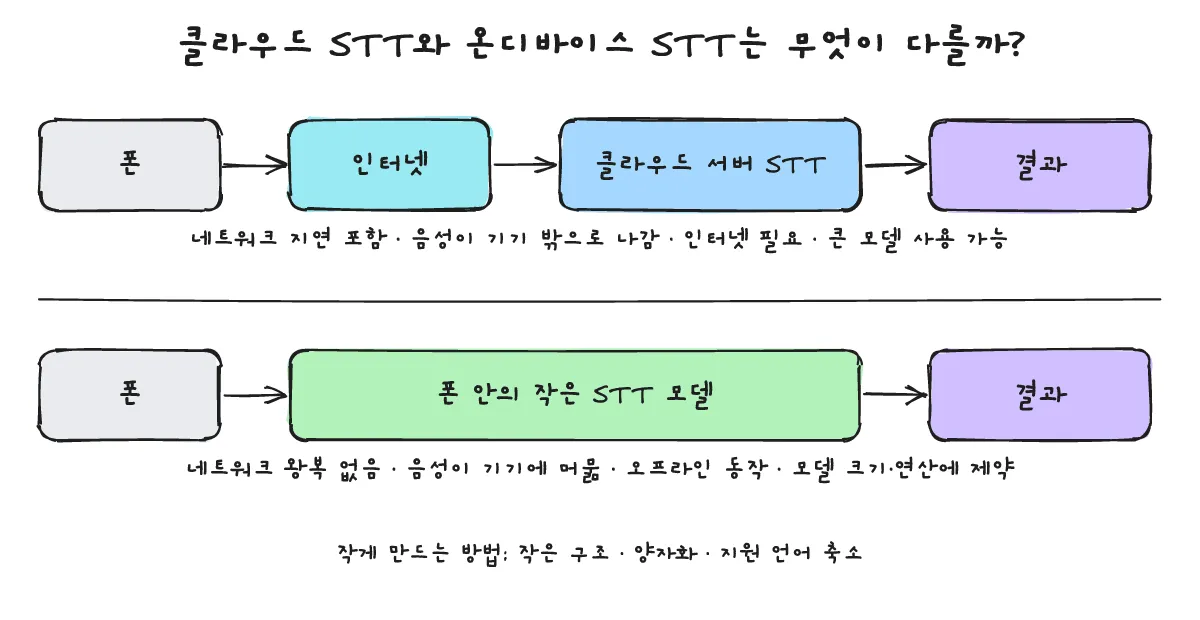
온디바이스 구동을 위해 모델 크기를 줄이는 방법은 크게 세 가지가 있습니다.
- 더 작은 모델 아키텍처 설계: 레이어 수와 임베딩 차원을 줄여 전체 파라미터 수를 축소합니다.
- 양자화(Quantization): 가중치 데이터를 더 적은 비트로 압축하여 메모리와 연산량을 줄입니다. 구체적인 동작 방식은 양자화란? 글을 확인해 보시기 바랍니다.
- 지원 언어 범위 축소: Whisper README에 명시된 영어 전용
.en모델(tiny.en, base.en, small.en, medium.en)처럼 특정 언어에만 집중하여 용량을 줄입니다.
모델 크기 감각을 파악할 수 있는 공개 수치는 다음과 같습니다. HN 게시물 “Whistle: Speech to Text in 16.9 MB”(961 points)의 제목에는 16.9 MB라는 경량화 크기가 제시되어 있습니다(HN 스레드). 또한 Whisper README에 공개된 공식 모델 규격 표는 다음과 같습니다.
- tiny: 39M 파라미터, 약 1 GB VRAM
- base: 74M 파라미터, 약 1 GB VRAM
- small: 244M 파라미터, 약 2 GB VRAM
- medium: 769M 파라미터, 약 5 GB VRAM
- large: 1550M 파라미터, 약 10 GB VRAM
- turbo: 809M 파라미터, 약 6 GB VRAM
README에 기재된 상대 속도는 A100 GPU 환경에서 영어를 받아쓰며 측정한 결과이며, README 자체에서도 “real-world speed may vary significantly”(실제 속도는 크게 다를 수 있음)라고 명시하고 있습니다. 따라서 이 수치를 스마트폰과 같은 온디바이스 기기에서의 실제 동작 속도로 직접 대입하시면 안 됩니다.
STT가 틀리는 이유와 사용할 때 주의할 점은 무엇인가요?
한 줄 답: 사용자 고유의 억양, 배경 소음, 낯선 전문 용어처럼 모델이 사전 학습한 데이터 분포와 실제 입력 신호가 다를 때 오류가 발생하기 쉬우며, 무음 구간에서는 존재하지 않는 문장이 허위로 생성되는 환각 현상이 나타나기도 합니다.
- 억양과 방언: 사전 학습 데이터에서 출현 빈도가 낮았던 독특한 발음 패턴일수록 인식 오차가 늘어날 수 있습니다.
- 배경 소음과 음향 잔향: 주변 소음이나 울림이 섞이면 멜 스펙트로그램의 고유 주파수 패턴이 왜곡되어 음향 특징을 정확하게 추출하기 어렵습니다.
- 전문 용어와 고유명사: 일반적인 학습 말뭉치에 드물게 등장하는 전문 단어나 인명, 지명 등은 유사한 다른 단어로 잘못 변환되기 쉽습니다.
- 언어별 성능 편차: Whisper README에 따르면 “Whisper’s performance varies widely depending on the language”(언어에 따라 성능 차이가 크게 나타남)라고 명시되어 있습니다. 단어 오류율(WER, Word Error Rate)은 전체 단어 중 인식 오류가 차지하는 비율을 측정하는 대표적인 평가 지표입니다.
Q1. 소리가 없는 구간인데 왜 “Thank you” 같은 문장이 나오나요?
HN 토론에 따르면, 무음 구간이나 단순 배경 소음만 존재하는 상태에서 “Thank you”와 같은 특정 문구가 반복적으로 출력되는 환각(hallucination) 현상을 겪었다는 언급이 있습니다. 다만 이러한 현상이 발생하는 기술적인 원인 규명은 본 글의 범위에서 다루지 않았습니다.
Q2. 한국어 음성 인식은 영어만큼 정확한가요?
지원 언어에 따라 인식 성능에 분명한 차이가 있습니다. Whisper README에서도 단어 오류율(WER)로 측정한 성능이 언어별로 크게 달라진다고 밝히고 있습니다. 다만 한국어와 영어 간의 구체적인 수치 비교는 본 글의 다룸 범위에 포함되지 않습니다.
Q3. 온디바이스 STT에는 어떤 한계가 있나요?
제한된 모델 크기와 기기 연산 자원의 한계가 가장 큽니다. 모바일 기기에 탑재하기 위해 모델을 경량화하면 동일 계열의 대규모 모델(예: Whisper large 1550M)에 비해 희귀 단어 인식이나 소음 환경 대처에서 정확도가 낮아질 수 있으며, 기기의 배터리 소모와 발열 문제도 함께 고려해야 합니다. 구체적인 성능 저하 폭은 적용 모델과 사용 환경에 따라 상이하므로 일반화된 수치로 제시하기는 어렵습니다.