핵심 요약
LLM 토큰은 모델이 텍스트를 처리하는 기본 단위이고, 컨텍스트 윈도우는 한 번의 요청에서 모델이 다룰 수 있는 토큰 수의 최대 한도입니다.
이 글은 SK하이닉스 AI 해커톤 1차 예선(10/17–18)을 준비하며 정리하는 AI 공부 노트 시리즈입니다. 지난 글에서 다룬 샘플링 방식(temperature·top-p)에 이어, 오늘은 모델이 텍스트를 다루는 가장 기본 단위인 토큰과, 그 토큰을 얼마나 많이 담을 수 있는지를 정하는 컨텍스트 윈도우를 정리합니다.
토큰이란? 단어·글자와 무엇이 다른가?
한 줄 답: LLM이 텍스트를 처리하는 단위이며, 글자·단어 조각·단어 전체·문장부호가 모두 토큰이 될 수 있습니다.
- 텍스트는 먼저 토큰 조각으로 쪼개지고, 각 조각은 숫자로 된 토큰 ID로 바뀝니다. 토큰 ID 다음 단계인 임베딩은 Day1 Self-Attention 글에서 다룹니다.
- 영어 기준 대략적인 추정치로 1토큰 ≈ 4글자 ≈ 단어 3/4개, 100토큰 ≈ 단어 75개 정도입니다. 이는 정확한 값이 아니라 추정치이며, 다른 언어는 이 관계가 다를 수 있습니다.
- 공백과 대소문자도 토큰 구분에 영향을 줍니다. 예를 들어
red,Red, 앞에 공백이 붙은red는 서로 다른 토큰으로 취급됩니다. - 토큰 수는 글자 수나 단어 수와 같지 않습니다. 같은 텍스트라도 모델, 인코딩, 언어에 따라 토큰 수가 달라질 수 있습니다.
토크나이저(BPE)는 문장을 어떻게 쪼개나? 한국어는 왜 토큰이 더 나올 수 있나?
한 줄 답: 자주 나오는 글자 조합은 하나의 토큰으로 묶고, 드물게 나오는 단어는 여러 조각으로 쪼개서 처리합니다.
- 서브워드 토큰화의 직관은 이렇습니다: 자주 등장하는 글자 묶음은 하나의 토큰으로 묶이고, 드물게 등장하는 단어는 여러 개의 작은 조각으로 쪼개집니다.
- BPE(Byte Pair Encoding)의 직관은 이렇습니다: 자주 붙어서 나오는 글자 쌍을 반복적으로 합쳐가며 어휘를 만듭니다.
- 한국어는 학습 데이터와 어휘 구성에 따라 같은 뜻이라도 영어보다 토큰이 더 많이 나올 수 있습니다. 다만 정확한 비율이나 배수는 모델과 인코딩마다 달라지므로 단정할 수 없습니다.
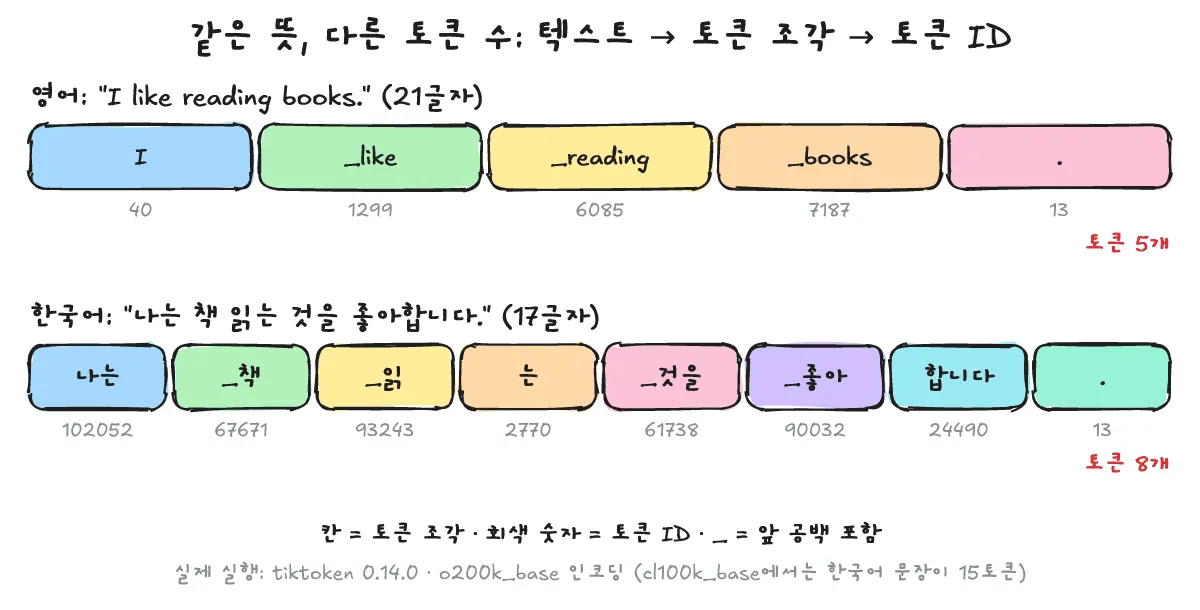
- 실제로 tiktoken으로 비교해 보면, o200k_base 인코딩 기준 “I like reading books.”는 5토큰, “나는 책 읽는 것을 좋아합니다.”는 8토큰으로 나옵니다. 아래는 이 비교를 직접 실행한 코드와 결과입니다.
# tiktoken으로 같은 뜻의 영어·한국어 문장과 공백/대소문자 예시를 실제로 토큰화합니다.
import importlib.metadata as md
import tiktoken

TEXTS = [
    "I like reading books.",
    "나는 책 읽는 것을 좋아합니다.",
    "red",
    "Red",
    " red",
]

def piece(enc, tid):
    b = enc.decode_single_token_bytes(tid)
    try:
        return repr(b.decode("utf-8"))
    except UnicodeDecodeError:
        return f"<bytes {b.hex(' ')}>"   # 글자 중간에서 잘린 바이트 조각

print("tiktoken", md.version("tiktoken"))
for name in ("o200k_base", "cl100k_base"):
    enc = tiktoken.get_encoding(name)
    print(f"\n== {name}")
    for t in TEXTS:
        ids = enc.encode(t)
        print(f"{t!r}: chars={len(t)} tokens={len(ids)}")
        print("  ids   :", ids)
        print("  pieces:", " | ".join(piece(enc, i) for i in ids))
tiktoken 0.14.0
== o200k_base
'I like reading books.': chars=21 tokens=5
ids : [40, 1299, 6085, 7187, 13]
pieces: 'I' | ' like' | ' reading' | ' books' | '.'
'나는 책 읽는 것을 좋아합니다.': chars=17 tokens=8
ids : [102052, 67671, 93243, 2770, 61738, 90032, 24490, 13]
pieces: '나는' | ' 책' | ' 읽' | '는' | ' 것을' | ' 좋아' | '합니다' | '.'
'red': chars=3 tokens=1
ids : [1291]
pieces: 'red'
'Red': chars=3 tokens=1
ids : [7805]
pieces: 'Red'
' red': chars=4 tokens=1
ids : [3592]
pieces: ' red'
== cl100k_base
'I like reading books.': chars=21 tokens=5
ids : [40, 1093, 5403, 6603, 13]
pieces: 'I' | ' like' | ' reading' | ' books' | '.'
'나는 책 읽는 것을 좋아합니다.': chars=17 tokens=15
ids : [61415, 16969, 3396, 109, 227, 17169, 121, 16969, 72208, 18359, 66799, 233, 54059, 61938, 13]
pieces: '나' | '는' | <bytes 20 ec> | <bytes b1> | <bytes 85> | <bytes 20 ec 9d> | <bytes bd> | '는' | ' 것' | '을' | <bytes 20 ec a2> | <bytes 8b> | '아' | '합니다' | '.'
'red': chars=3 tokens=1
ids : [1171]
pieces: 'red'
'Red': chars=3 tokens=1
ids : [6161]
pieces: 'Red'
' red': chars=4 tokens=1
ids : [2579]
pieces: ' red'같은 “나는 책 읽는 것을 좋아합니다.”라는 문장도 인코딩에 따라 o200k_base는 8토큰, cl100k_base는 15토큰으로 다르게 나옵니다. cl100k_base에서는 일부 토큰이 한글 한 글자를 이루는 UTF-8 바이트 조각 단위로 더 잘게 쪼개지기 때문입니다. 이 숫자는 일반화된 비율이 아니라 이번에 실행한 이 문장 하나의 예시로만 참고해야 합니다. 참고로 tiktoken.encoding_for_model("gpt-4o")는 o200k_base를, tiktoken.encoding_for_model("gpt-4")는 cl100k_base를 반환합니다.
컨텍스트 윈도우란? 입력+출력 토큰 한도는 언제 문제가 되나?
한 줄 답: 한 요청에서 모델이 볼 수 있는 토큰의 총량 한도이며, 출력 한도는 따로 정해집니다.
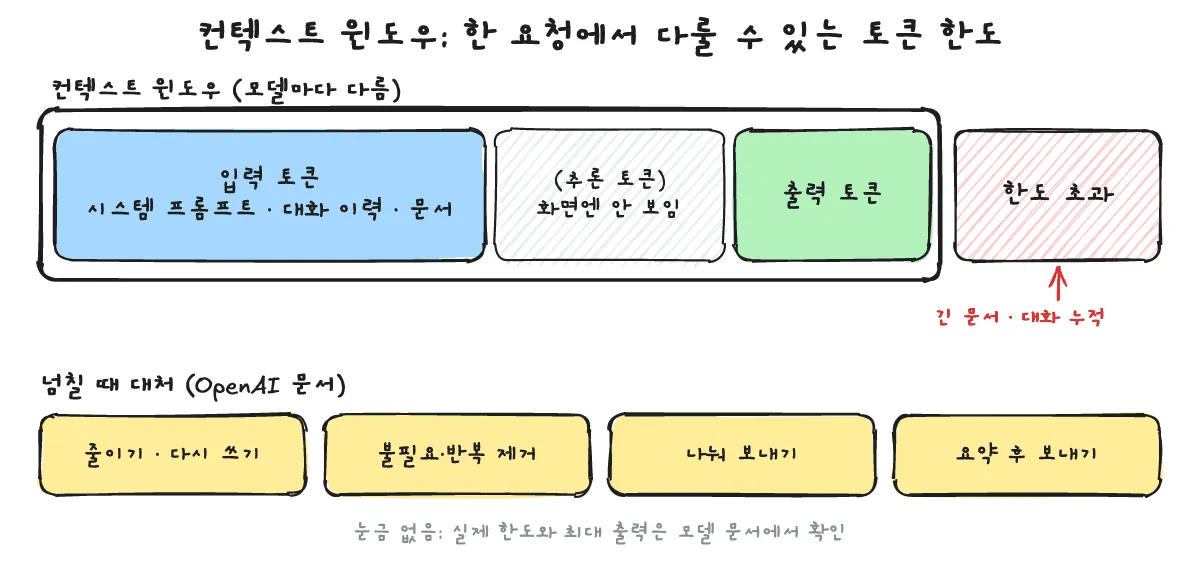
- 긴 문서를 통째로 넣거나 대화 기록이 계속 쌓이면 컨텍스트 윈도우 한도를 초과할 수 있습니다. 추론(reasoning) 모델의 경우 화면에 보이지 않는 추론 토큰도 출력 쪽 공간을 차지한다는 점에 유의해야 합니다.
- 한도에 걸릴 때의 대처법은 다음과 같습니다: 내용을 줄이거나 다시 표현하기, 불필요하거나 중복된 컨텍스트 제거하기, 여러 부분으로 나누어 보내기, 요약·전처리 후 보내기입니다(출처: OpenAI Help: Understanding and counting tokens).
- 시스템 프롬프트와 대화 이력을 컨텍스트 윈도우 안에 어떻게 배치하는지는 Day4 프롬프트 엔지니어링 글에서 다룹니다.
- 대화가 길어질수록 KV Cache 등 메모리 부담도 함께 커진다는 점은 Day3 KV Cache 글에서 다룹니다.
[시험용 한 줄] 토큰 = 텍스트 처리 단위(단어/글자 아님); 컨텍스트 윈도우 = 1회 요청 시 처리 한도. 넘치면 줄이기·반복 제거·나누기·요약으로 대처하고, 보이지 않는 추론 토큰도 공간을 차지합니다.
배운 내용을 퀴즈로 확인해 볼까요?
Q1. 영어 단어 100개와 한국어 단어 100개는 항상 같은 수의 토큰이 됩니까?
A1. 그렇지 않습니다. 토큰 수는 언어와 모델의 인코딩에 따라 달라질 수 있습니다.
Q2. red, Red, red는 모두 같은 토큰 ID를 가집니까?
A2. 아닙니다. 위 실행 결과에서 세 문자열은 각각 1토큰이지만 토큰 ID가 모두 다릅니다(o200k_base 기준 1291, 7805, 3592).
Q3. 추론 모델에서 화면에 보이는 답은 짧은데 출력 토큰 사용량이 더 많게 나오는 이유는 무엇입니까?
A3. 화면에 보이지 않는 추론 토큰도 출력 사용량에 포함되기 때문입니다(OpenAI Help 문서 기준).