A Tour of C++ 2.1–2.2|user-defined type과 struct Vector
Answer First
내장 타입은 하드웨어를 직접 비추는 저수준 도구이고, C++는 그 위에 추상화 장치를 얹어 user-defined type을 만들 수 있게 합니다. 새 타입의 첫 단계는 필요한 조각을struct로 모으는 것이며, *A Tour of C++*의 첫 번째 예시인Vector는elem과sz두 멤버, 그리고vector_init함수로 시작합니다.
built-in type과 user-defined type은 어떻게 다른가?
Stroustrup은 내장 타입(built-in types)을 다음 세 가지로 구성된다고 정의합니다.
- 기본 타입(fundamental types):
int,double,char,bool등 (§1.4) const수정자 (§1.6)- 선언 연산자(declarator operators):
*(포인터),&(참조),[](배열) (§1.7)
따라서 const int*, int&, double[10]은 새로운 이름이 붙은 타입이 아니라 모두 내장 타입의 범주에 속합니다. int에 const와 포인터 선언자를 조합한 것뿐입니다.
내장 타입은 왜 저수준인가?
책은 내장 타입이 “일부러 저수준(deliberately low-level)“이라고 표현합니다. 일반 컴퓨터 하드웨어의 능력을 직접·효율적으로 반영하도록 설계되었기 때문입니다. 그 결과 내장 타입과 연산의 집합은 풍부하지만, 프로그래머가 고수준 응용을 편하게 쓸 수 있게 해 주는 시설은 제공하지 않습니다.
예를 들어, CPU는 int를 레지스터에 올리는 방법을 압니다. 하지만 “센서 온도·습도·타임스탬프 세 값을 하나의 논리 단위로 묶어 다루라”는 개념은 하드웨어 수준에 없습니다. 그 간극을 메우는 것이 C++의 추상화 장치입니다.
C++ 추상화 장치의 목적 두 가지
C++는 내장 타입 위에 **추상화 장치(abstraction mechanisms)**를 얹습니다. 그 목적은 두 가지입니다.
- 프로그래머가 자기 타입을 설계·구현할 수 있게 합니다. 그 타입에는 알맞은 표현(representation)과 연산(operations)이 있습니다.
- 그런 타입을 단순하고 우아하게 사용할 수 있게 합니다.
이 장치로 조립한 타입을 **user-defined type(사용자 정의 타입)**이라 하며, 책은 이것들을 class와 enumeration이라고 부릅니다(union은 §2.5에서 다룹니다).
표준 라이브러리도 user-defined type이다
흔히 “내가 오늘 파일에 직접 적은 타입”만을 user-defined type으로 여기기 쉽습니다. 그러나 표준 std::string, std::vector<int>, std::optional<T>도 모두 user-defined type입니다. 이것들은 CPU에 맞게 언어에 미리 박아 둔 것이 아니라, C++의 타입 시스템으로 조립한 타입이기 때문입니다.
| 예시 | 분류 |
|---|---|
int | built-in (fundamental type) |
const int* | built-in (int + const + *) |
double[10] | built-in (double + []) |
std::string | user-defined (class로 조립) |
std::vector<int> | user-defined (class 템플릿으로 조립) |
사용자 정의 타입을 고르는 이유는 무엇인가?
책은 내장 타입 조합 대신 사용자 정의 타입을 선호하는 이유를 세 가지로 정리합니다.
- 쓰기 더 쉽습니다. 타입에 의미 있는 이름과 연산이 붙으면, 사용 코드에서 의도가 명확해집니다.
- 실수가 더 적습니다. 컴파일러가 타입을 기준으로 검사하므로 잘못된 사용을 조기에 걸러냅니다.
- 내장 타입을 직접 짜 맞추는 것만큼 빠르거나, 오히려 더 빠를 수 있습니다. 저수준을 직접 만지면 경계 검사 누락, 잘못된 수명 관리, 캐시에 맞지 않는 배치 등의 실수가 쌓입니다. 잘 설계된 타입은 그 실수를 방지하고, 인라이닝·이동 생성자 등으로 직접 짠 코드와 동등하거나 더 나은 기계어를 생성하기도 합니다.
현업 예시: Sample 구조체 vs 느슨한 파라미터
공부 노트의 예시를 보겠습니다. 내장 타입만으로 센서 로그를 다루면 다음과 같습니다.
void log(double t, double h, int ts);
log(21.5, 40.0, 1710000000);
이 시그니처는 순서만 바뀌어도 컴파일이 통과합니다. t가 온도인지 습도인지 파라미터 순서를 외워야만 알 수 있습니다.
한 타입으로 묶으면:
struct Sample {
    double temperature;
    double humidity;
    int    timestamp;
};

void log(const Sample& s);
이제 호출하는 쪽은 Sample만 알면 됩니다. temperature가 float로 바뀌거나 필드가 늘어도, 고쳐야 할 지점은 Sample 정의 한 곳으로 모입니다. 같은 이유로, 좌표는 double x, y 대신 Point, 금액과 통화는 long + string 대신 Money, 버퍼는 char* + int 대신 std::vector<std::byte>로 올립니다. 이것이 책이 말하는 “쓰기 쉽고, 실수 적고, 보통 그만큼 빠르다”의 실제 모습입니다.
Don’t Panic — 2장의 위치
책은 Douglas Adams의 표어를 빌려 “Don’t Panic!”을 내세웁니다. 지금 당장 std::vector 수준의 타입을 만들 필요는 없습니다. 장치를 하나씩 붙여 가면 됩니다.
- 2장: 타입을 만드는 최소 장치 —
struct,class,enum,union - 4–8장: 추상화의 본편 — 에러 처리, 클래스 계층, 연산자, 템플릿
- 9–17장: 표준 라이브러리 — 그 장치로 만들 수 있는 것의 예
1장이 레고 블록이라면, 2장부터는 블록으로 부품을 설계하는 법을 배웁니다.
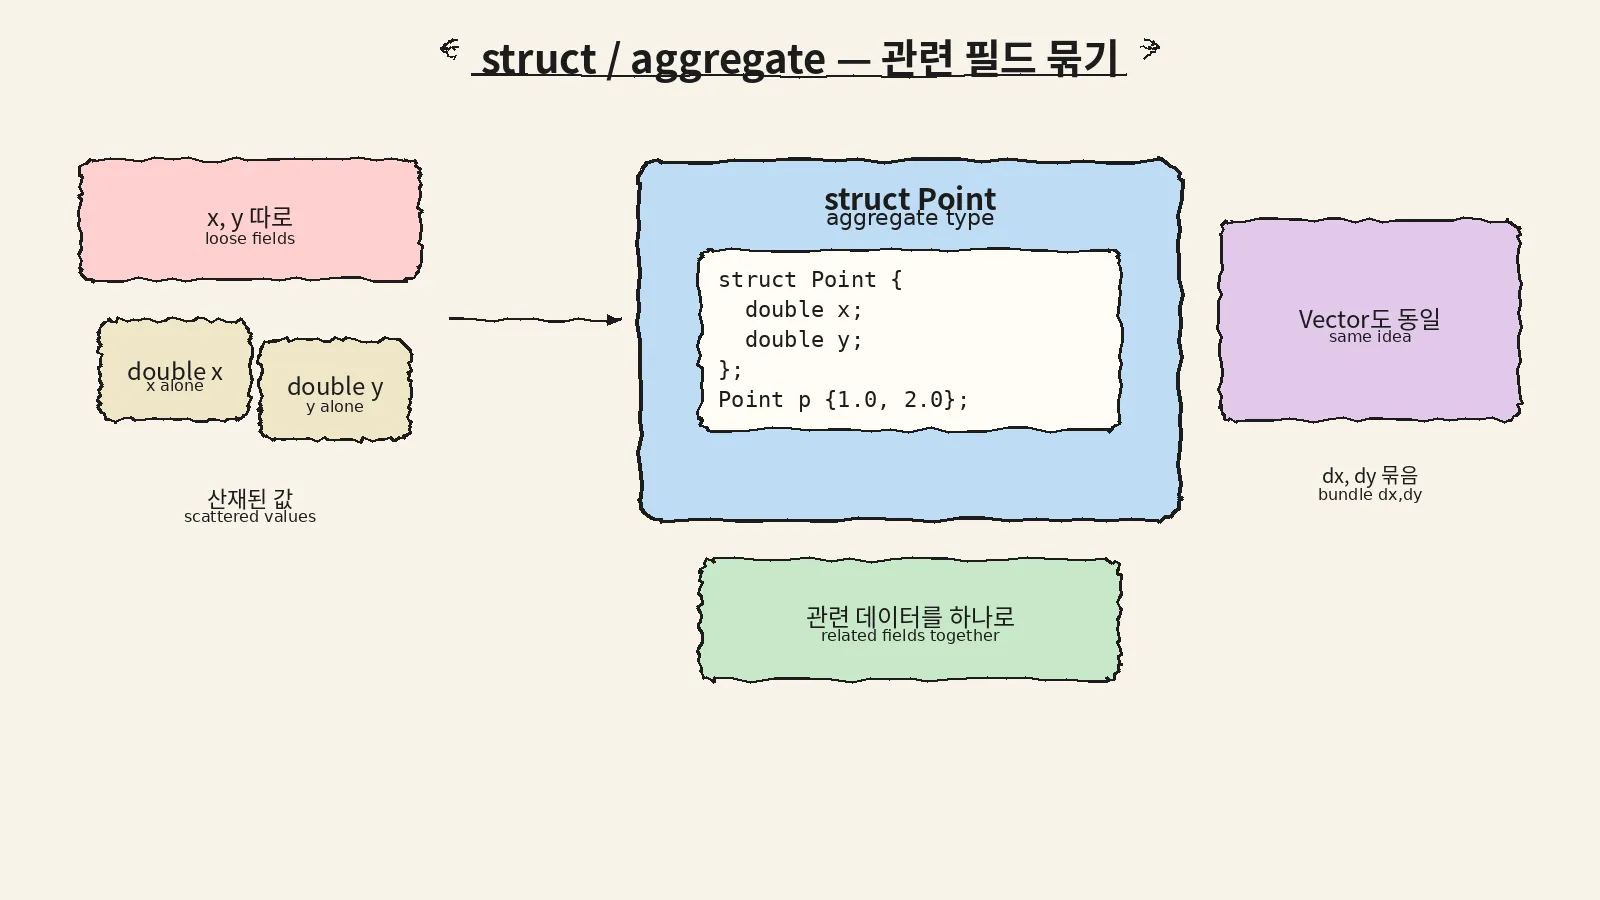
struct Vector는 무엇을 담나?
struct가 묶는 데이터
사용자 정의 타입을 만드는 첫 단계는 필요한 조각을 struct로 모으는 것입니다. 책의 첫 번째 예시는 다음과 같습니다.
struct Vector {
    double* elem;  // pointer to elements
    int sz;        // number of elements
};Vector는 double* 하나와 int 하나로 구성됩니다. elem은 원소 배열을 가리키는 포인터이고, sz는 원소 개수입니다.
선언만으로는 쓸 수 없다
Vector v; // 상자만 생김. elem은 어디도 가리키지 않음이 선언은 Vector 크기만큼의 스택 공간을 만들지만, elem이 유효한 배열을 가리키지 않습니다. 이 상태에서 v.elem[0] = 1.0;을 실행하면 미정의 동작(undefined behavior)이 발생합니다.
대문자 Vector vs 소문자 vector
책은 설계·구현을 보여 주기 위해 만드는 타입을 대문자 Vector로 표기합니다. 실제 코드에서는 표준 라이브러리 std::vector를 직접 다시 만들지 말고 사용하십시오. 표준 라이브러리 타입은 소문자입니다. 이 구분을 염두에 두고 나머지 예시를 읽으면 혼란이 줄어듭니다.
vector_init에서 참조(&)와 new는 왜 필요한가?
Vector v; 선언 이후 원소를 붙이려면 초기화 함수가 필요합니다.
void vector_init(Vector& v, int s)
{
    v.elem = new double[s];  // allocate an array of s doubles
    v.sz = s;
}
&(비const 참조)가 필요한 이유
Vector& v에서 &는 **비const 참조(non-const reference)**입니다(§1.7). 이렇게 받으면 vector_init은 호출한 쪽의 Vector 객체를 직접 수정할 수 있습니다.
만약 &를 빼고 void vector_init(Vector v, int s)로 정의하면:
- 함수는 호출한 쪽의
Vector를 복사해서 받습니다. v.elem = new double[s]는 복사본의elem만 초기화합니다.- 함수가 반환되면 복사본은 사라지고, 호출한 쪽 원본의
elem은 여전히 아무것도 가리키지 않는 빈 포인터로 남습니다.
참조를 써서 별명(alias)으로 받아야만 원본을 고칠 수 있습니다.
new와 free store
new double[s]는 free store(dynamic memory, heap이라고도 합니다)에서 메모리를 할당합니다. 여기서 만든 객체는 만든 스코프와 독립적이며, delete로 해제할 때까지 살아 있습니다(§5.2.2). 현재 Vector에는 해제 코드가 없습니다. 이것은 의도적인 미완성이며, destructor는 §5.2.2에서 다룹니다.
new vs malloc (짧게)
malloc | new | |
|---|---|---|
| 단위 | 바이트 | 타입 객체 |
| 초기화 | 없음 (생성자 없음) | 생성자 호출 |
| 해제 | free | delete / delete[] |
| 반환 타입 | void* (캐스트 필요) | T* |
new double[s]는 double s개짜리 배열을 할당하며 결과가 double*이므로 elem에 저장할 수 있습니다. 반면 new Vector는 Vector 상자 하나를 할당하여 결과가 Vector*가 되므로 elem(double*)에 넣으면 타입 불일치입니다. new와 free, malloc과 delete는 절대 혼용하지 않습니다.
vector_init(v, 3) 이후 메모리 그림
vector_init(v, 3) 이후

v (스택)
┌─────────────┬──────┐
│ elem ───────┼──┐   │  sz = 3
└─────────────┴──┼───┘
                 ▼
          (free store)
          [ ? | ? | ? ]
           [0]  [1]  [2]
read_and_sum 사용 예
아래는 Vector와 vector_init을 활용한 교육용 예시입니다.
double read_and_sum(int s)
    // read s integers from cin and return their sum; s is assumed to be positive
{
    Vector v;
    vector_init(v, s);

    for (int i = 0; i != s; ++i)
        cin >> v.elem[i];

    double sum = 0;
    for (int i = 0; i != s; ++i)
        sum += v.elem[i];
    return sum;
}
이 코드는 v.elem과 sz를 외부에서 직접 접근합니다. 표현(representation)이 공개되어 있어 아직 우아하지 않습니다. 2.3 Classes에서 생성자와 캡슐화로 이 문제를 해결합니다.
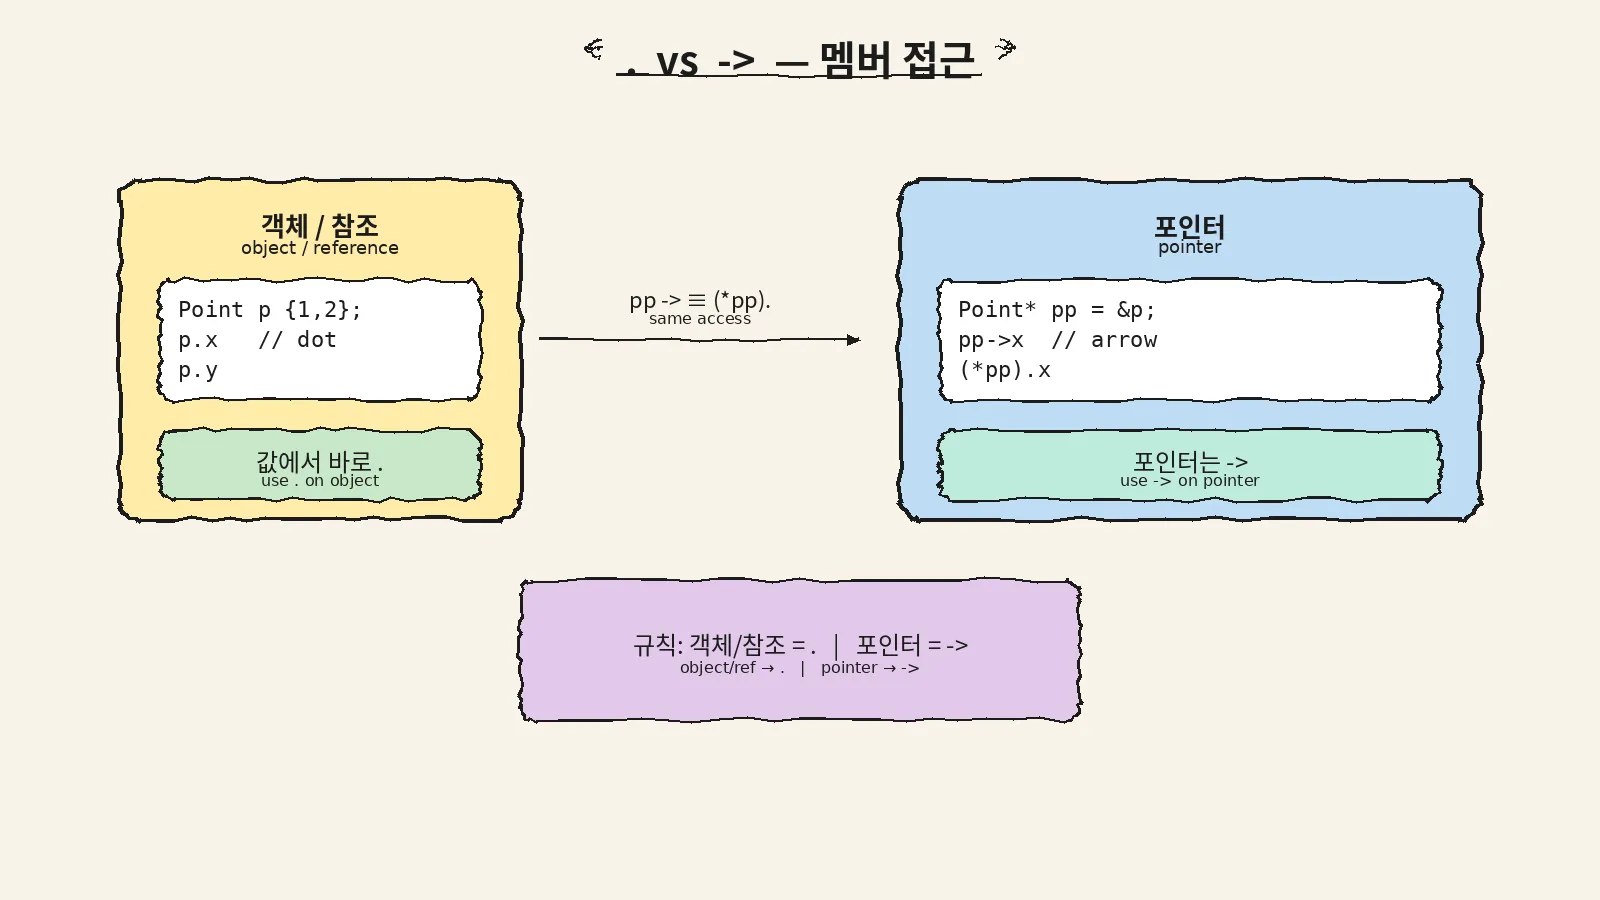
.과 -> 멤버 접근은 어떻게 다른가?
. vs -> 멤버 접근
Vector의 멤버에 접근하는 방법은 변수의 종류에 따라 달라집니다.
void f(Vector v, Vector& rv, Vector* pv)
{
    int i1 = v.sz;    // v는 객체 — 점(.)으로 접근
    int i2 = rv.sz;   // rv는 참조 — 점(.)으로 접근
    int i3 = pv->sz;  // pv는 포인터 — 화살표(->)로 접근
}| 변수 종류 | 접근 연산자 | 예시 |
|---|---|---|
| 객체 (이름) | . | v.sz |
| 참조 | . | rv.sz |
| 포인터 | -> | pv->sz |
-> 는 (*p). 의 축약형
pv->sz는 (*pv).sz와 완전히 동일합니다. 포인터를 역참조한 뒤 멤버에 접근하는 두 단계를 -> 하나로 표기한 것입니다.
pv.sz처럼 포인터 변수에 .을 직접 사용하면 컴파일 에러가 발생합니다. pv는 Vector* 타입이므로 .sz라는 멤버가 없습니다.
FAQ
Q. const int*는 built-in인가요, user-defined인가요?
A. built-in입니다. int(기본 타입)에 const 수정자와 포인터 선언자 *를 결합한 형태입니다. 새 이름이 붙은 타입을 정의하지 않았으므로 user-defined가 아닙니다.
Q. std::string은 built-in 타입인가요?
A. 아닙니다. 표준 라이브러리가 제공하지만, 언어의 클래스 장치로 조립된 user-defined type입니다. 언어 규격에서 string을 기본 타입으로 하드코딩하지 않습니다. “내가 오늘 작성한 타입”만이 user-defined가 아님을 기억하십시오.
Q. vector_init 함수에서 &를 제거하면 어떻게 되나요?
A. 함수는 호출한 쪽의 Vector를 복사해서 받습니다. new double[s]로 할당된 배열 주소는 복사본의 elem에만 저장됩니다. 함수가 반환되면 복사본은 사라지고, 호출한 쪽의 원본 Vector는 elem이 여전히 초기화되지 않은 상태로 남습니다.
Q. Vector v; 선언 직후 v.elem[0] = 1.0;을 실행하면 왜 위험한가요?
A. elem 포인터가 아직 유효한 배열을 가리키지 않습니다. 초기화되지 않은 포인터를 역참조하는 것은 **미정의 동작(undefined behavior)**이며, 크래시, 잘못된 메모리 접근, 예측 불가능한 결과를 일으킬 수 있습니다.
Q. std::vector를 직접 다시 구현해도 되나요?
A. 표준 std::vector와 std::string은 다시 만들지 말고 사용하십시오. 책의 대문자 Vector는 언어 장치를 설명하기 위한 교육용 타입입니다. 실제 코드에서는 수십 년간 검증된 표준 라이브러리를 그대로 쓰는 것이 올바릅니다.
출처
- Bjarne Stroustrup, A Tour of C++, 3rd ed. (2022), §§2.1–2.2
- cppreference — 클래스/구조체 (user-defined types)
- cppreference — new 표현식 / free store
- A Tour of C++ 공식 도서 페이지: https://www.stroustrup.com/Tour.html
다음 편 예고 — A Tour of C++ Ch.2 part 2/2: Classes
2.3 Classes에서는 이번 편에서 수동으로 호출했던vector_init을 **생성자(constructor)**가 대체합니다. 생성자를 통해 타입의 표현(representation)을 인터페이스 뒤로 숨기는 캡슐화의 첫걸음을 살펴볼 예정입니다. 클래스 계층, 소멸자 등 풍부한 추상화 장치는 4–8장에서 본격적으로 다룹니다.
Disclaimer: 이 글은 Bjarne Stroustrup, A Tour of C++ (3rd ed.) §§2.1–2.2와 공부 노트를 기준으로 한 학습 정리이며, 표준·구현·컴파일러에 따라 세부 동작은 달라질 수 있습니다. 표준 std::vector/std::string을 다시 만들지 말고 사용하십시오.