규정 PDF, 마스터 표, 원본 로그 같은 파일 여러 개를 LLM 채팅에 붙이고 서술형 질문에 답하는 연습을 한동안 했습니다. 조건에 맞는지 판정하고, 건수를 세고, 금액을 계산하는 문제들이었습니다.
처음에는 AI가 알아서 잘 해 줄 거라고 생각했습니다. 막상 해 보니 결과를 가른 건 AI 실력이 아니었습니다. 내가 뭘 어떻게 시키느냐였습니다. 계산은 맞는데 조건 하나를 빠뜨려서 틀리고, 긴 표에서 한 줄을 잘못 읽어서 틀리고, 검산한다고 했는데 실제로는 같은 숫자를 다시 더한 것뿐이었던 적도 있습니다.
이 글은 그렇게 틀려 가면서 정리한 접근법입니다. 실무형 AI 활용 문제를 연습하는 분들께 도움이 되면 좋겠습니다.
목차
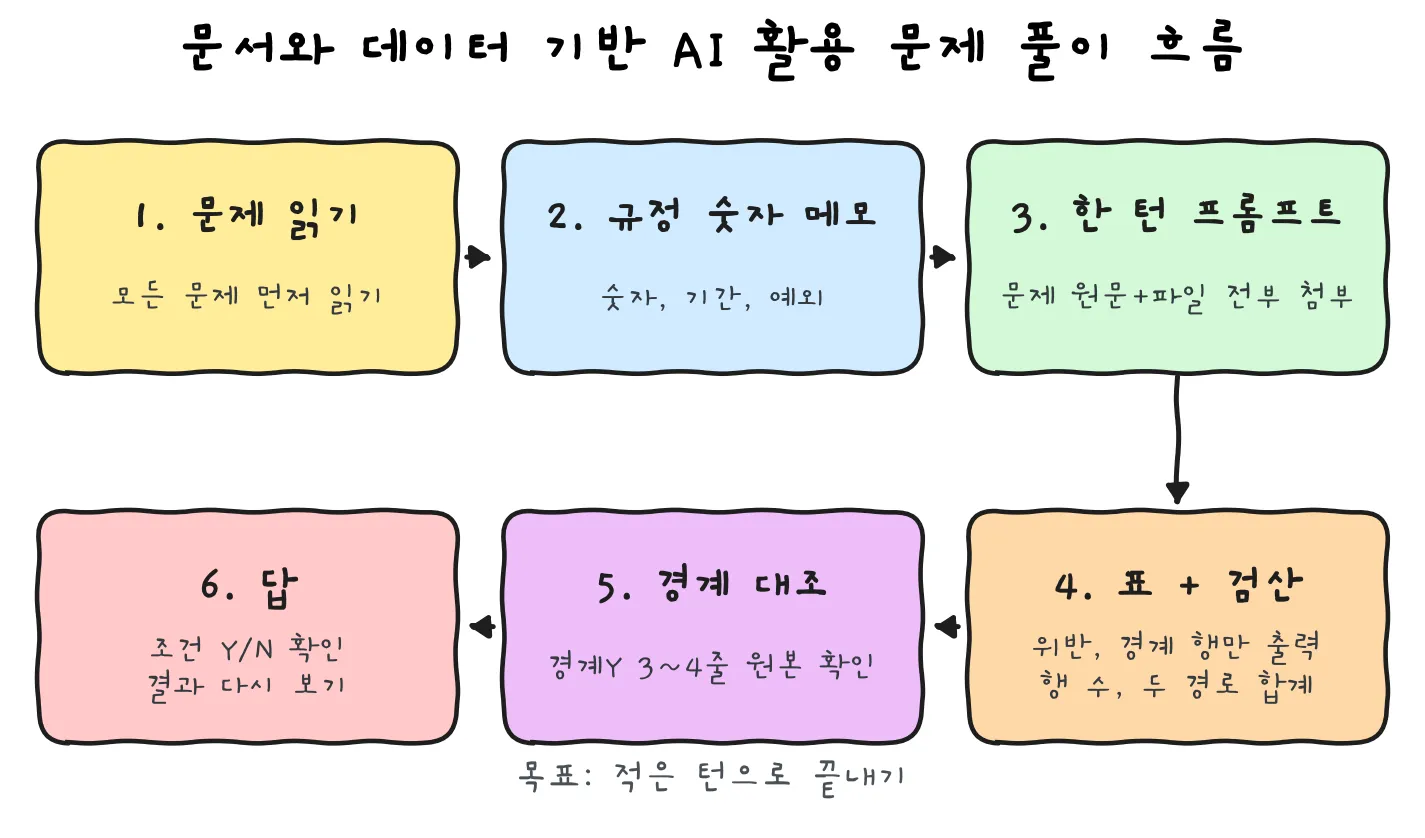
- 어떤 순서로 접근할까요? 먼저 읽고, 메모하고, 한 번에 시킨다
- 프롬프트 한 턴 공식은 무엇일까요?
- 마스터 표와 출력은 어떻게 줄일까요?
- 검산은 얼마나 구체적으로 시켜야 할까요?
- 경계 사례는 무엇을 확인해야 할까요?
- 첨부와 맥락은 어떻게 관리할까요?
- 4D 관점으로 다시 보면 어떻게 정리될까요?
- 예시 프롬프트는 어떻게 생겼을까요? (가상의 출장비 규정 예시)
- 마치며, 무엇부터 바꿔 볼까요?
어떤 순서로 접근할까요? 먼저 읽고, 메모하고, 한 번에 시킨다
AI에게 바로 질문을 던지고 싶어지지만, 처음에 잠깐 준비하면 전체 시간이 오히려 줄어듭니다.
- 모든 질문을 먼저 읽습니다. 어떤 질문이 어떤 파일을 쓰는지, 겹치는 계산이 뭔지 먼저 봅니다.
- 규정 PDF에서 숫자, 기간, 예외만 빠르게 뽑아 메모장에 적습니다. 한도 금액, 기준 시간, 적용 기간, 제외 대상 같은 것들입니다. 조문 전체를 정리할 필요는 없습니다.
- 문제마다 표에 필요한 열을 메모합니다. “1번은 판정 Y/N, 3번은 손실 합계”처럼 적습니다.
- 프롬프트 하나로 여러 문제를 한 번에 풉니다. 적은 턴으로 끝내는 게 목표입니다.
💡 질문을 하나씩 따로 물으면 턴도 시간도 질문 수만큼 듭니다. 같은 파일로 같은 판정을 하는 질문이라면 한 번에 묶는 게 훨씬 효율적입니다.
프롬프트 한 턴 공식은 무엇일까요?
여러 번 고쳐 쓰다가 자리 잡은 순서는 이렇습니다.
질문 정리 → 필요한 파일 전부 첨부 → 규정 숫자와 경계 기준 명시
→ 처리 순서 → 표 열 → 검산 → 마지막 줄 답 형식
순서마다 지킬 점이 있습니다.
문제 문장은 요약하지 말고 그대로 붙인다
제일 아프게 배운 부분입니다. 가상의 예로 설명하면, 질문에 “국외 출장은 제외” 라는 조건이 있는데 질문을 요약해서 옮기다가 이 조건이 빠지는 식입니다. AI는 시킨 대로 정확하게 계산하고, 답은 틀립니다. AI 답에 그 건이 국외 출장이라고 적혀 있어도 놓치기 쉽습니다.
“제외”, “초과”, “이상”, “단,” 같은 말 한 마디가 답을 바꿉니다. 문제 문장은 원문 그대로 붙여 넣습니다.
말투는 ‘시키는 말’로 쓴다
처음 제 프롬프트는 이랬습니다. “규정 PDF가 필요하다”, “표로 작성해야한다”. 제 생각을 적은 메모 말투입니다. AI 입장에서는 무엇을 하라는 건지 애매합니다.
문장 끝을 AI가 할 동작으로 바꾸면 훨씬 분명해집니다.
| 메모 말투 (X) | 시키는 말 (O) |
|---|---|
| 이상 판정 규정이 필요하다 | 첨부한 규정으로 행마다 이상 여부를 판정해. |
| 데이터를 표로 작성해야한다 | 아래 열로 표를 만들어. |
| B 파일 기준으로 진행한다 | 3번은 B 파일 행만 합산해. |
요령은 하나입니다. 문장을 “~해”, “~만들어”, “~계산해”, “~표시해”로 끝냅니다.
설계 질문은 넣지 않는다
“추가로 필요한 데이터를 정리해줘” 같은 질문은 넣지 않습니다. 뭐가 필요한지는 문제를 읽은 내가 이미 알고 있습니다. 이런 질문은 답을 하나 받는 대신 턴만 낭비합니다. 필요한 파일을 처음부터 다 붙이고 바로 풀게 합니다.
마스터 표와 출력은 어떻게 줄일까요?
판정은 전부, 출력은 일부만
AI에게는 모든 행을 판정하게 하되, 화면에 출력하는 건 위반 행과 경계 행만 받습니다. 나머지는 건수만 받으면 됩니다.
이게 속도 때문만은 아닙니다. 정확도와도 바로 이어집니다. 가상의 예로, 출장자 15명의 숙박비를 정산한다고 해 보겠습니다. 14명은 1원까지 맞았는데, 1명의 한 줄을 잘못 읽어서 18,000원 차이가 납니다(숙박비 80,000원을 98,000원으로 읽음). 규칙은 다 맞게 적용했는데, 긴 표 중간에서 한 줄을 잘못 읽은 것입니다. 출력이 길어질수록 이런 실수가 생길 확률도 올라갑니다.
파일 하나를 붙였으면, 그 파일로 풀 수 있는 열을 전부 채운다
파일을 붙인 턴에서는 그 파일로 풀 수 있는 모든 문제의 열을 한꺼번에 채우게 합니다. 한 번은 다른 문제에 쓸 비교 열을 빼먹었습니다. 나중에 그 값이 필요해졌을 때는 이미 맥락이 흐려져서 오답이 났습니다.
검산은 얼마나 구체적으로 시켜야 할까요?
“검산해”라고만 쓰면 AI는 대개 자기가 낸 숫자를 다시 훑어보고 “일치합니다”라고 합니다. 무엇을 어떻게 맞춰 볼지까지 써 줘야 합니다.
| 검산 방법 | 프롬프트에 넣을 문장 예시 |
|---|---|
| 행 수 검산 | “원본 행 수 = 제외 행(기간 밖·중복·취소) + 남은 행인지 확인해.” |
| 줄 단위 계산식 열 | “각 행에 실근로 = 퇴근 − 출근 − 휴게 계산식을 그대로 적어.” |
| 합계를 두 경로로 비교 | “날짜별 합계와 직원별 합계를 따로 구해서 같은지 확인해.” |
| 조건 재확인 | “문제의 모든 조건을 다시 나열하고, 답이 각 조건을 만족하는지 Y/N으로 확인해.” |
계산식 열은 특히 효과가 좋습니다. 식이 그대로 보이면 휴게 시간을 빼먹은 줄이 바로 눈에 띄기 때문입니다.
⚠️ 같은 숫자를 다시 더하는 건 검산이 아니다
앞에서 든 가상의 18,000원 사례에서 “합계를 검산해”라고 했더니, AI는 이미 틀린 직원별 숫자를 차례로 다시 더하고 이렇게 답했습니다. “표의 합계와 재합산 결과가 일치합니다.” 당연히 일치합니다. 같은 숫자를 다시 더했기 때문입니다. 덧셈 실수는 잡을 수 있어도, 값 자체가 틀린 건 못 잡습니다.
진짜 검산은 원본 파일을 다시 첨부해서 다른 경로로 다시 계산하는 것입니다. 예를 들어 금액이 큰 직원 2~3명을 골라 날짜별로 처음부터 다시 계산하게 하고, 이전 값과 다른 줄만 보여 달라고 하면 됩니다.
경계 사례는 무엇을 확인해야 할까요?
틀리는 문제는 대부분 경계에서 나옵니다. 규정을 읽을 때 아래 항목이 있는지부터 확인합니다.
- ☐ 기준값과 정확히 같은 값. ‘초과’인지 ‘이상’인지
- ☐ 기간의 첫날과 마지막 날
- ☐ 자정을 넘긴 시간
- ☐ 중복 제출
- ☐ 정정·취소된 건
- ☐ 예외 대상 (제외 직군, 특수 근무 형태 등)
- ☐ 발효일 당일에 새 기준을 쓰는지 옛 기준을 쓰는지
표에 경계 Y/N 열을 두게 합니다. 그리고 경계 Y인 줄 서너 개는 원본 파일에서 직접 대조합니다. 다 볼 필요는 없습니다. 몇 줄만 봐도 AI가 기준을 제대로 적용했는지 금방 알 수 있습니다.
첨부와 맥락은 어떻게 관리할까요?
- 대화가 길어지면 규칙 파일과 원본 파일을 다시 첨부하는 게 안전합니다. 검산할 때도 마찬가지입니다. 앞에서 만든 표만 이어서 쓰면, 그 표에 오류가 있을 때 오류까지 그대로 따라갑니다.
- AI가 ‘확인 불가’라고 하면 그 답은 쓰지 않습니다. 필요한 파일을 다시 붙여서 다시 물어봅니다.
- 다음 프롬프트는 메모장에 미리 써 둡니다. 그러면 흐름이 끊기지 않습니다.
- 마지막에 최종 결과를 다시 확인합니다. 계산이 맞아도 옮겨 적는 과정에서 값이 빠지거나 틀어질 수 있습니다.
4D 관점으로 다시 보면 어떻게 정리될까요?
AI 활용 역량을 흔히 4D로 나눠 설명하는데, 위 전략을 여기에 맞춰 보면 이렇게 정리됩니다. 위임(Delegation) 은 무엇을 AI에게 맡기고 무엇을 내가 할지 정하는 것입니다. 전수 판정과 계산은 AI에게 맡기고, 조건을 뽑는 일과 경계 행 대조는 내가 합니다. 설명(Description) 은 그 일을 분명하게 시키는 것입니다. 질문 원문, 규정 숫자, 처리 순서, 표 열, 답 형식을 시키는 말로 적습니다. 분별(Discernment) 은 AI 답을 그대로 믿지 않는 것입니다. ‘확인 불가’나 같은 숫자를 다시 더한 ‘검산’을 걸러내고, 다른 경로로 다시 계산합니다. 책임(Diligence) 은 최종 답이 내 책임이라는 걸 잊지 않는 것입니다. 조건별 Y/N을 확인하고, 경계 행을 원본과 대조하고, 최종 결과까지 다시 봅니다.
예시 프롬프트는 어떻게 생겼을까요? (가상의 출장비 규정 예시)
가상의 출장비 규정 예시로 공식을 적용해 보겠습니다. 아래 규정과 숫자는 모두 가상입니다.
- 규정: 일비는 1일 10만 원 한도, 숙박비는 1박 8만 원 한도, 주말 출장은 사전승인 필요
- 데이터: 출장내역 40건
- 질문: 3개
[필요한 파일 첨부: 규정.pdf, 직원마스터.xlsx, 출장내역.csv]
출장내역 40건을 전수 검사해 아래 질문 세 개에 답해.
위반 기준: ① 일비 > 100,000 ② 숙박비 > 80,000 ③ 토·일이면서 사전승인=N. 한도와 같은 값은 위반 아님.
위반 금액: ①② 한도 초과분, ③ 전액.
순서: 사번으로 부서 매칭 → 건별 판정 → 표
표는 위반 행과 경계 행만: |사번|부서|요일|일비|숙박비|사전승인|위반①②③|위반금액|경계Y/N|
검산: 위반 + 비위반 = 40, 부서별 위반 합 = 위반 건수, 조건별 Y/N 재확인
마지막 줄: 질문1=N건 / 질문2=N원 / 질문3=부서명
각 줄이 공식의 어느 단계인지 짚어 보면 이렇습니다.
- 첫 줄: 필요한 파일 전부 첨부
- 위반 기준: 규정 숫자와 경계 기준. “한도와 같은 값은 위반 아님”이 핵심입니다.
- 순서: 처리 순서. 마스터 매칭을 먼저 하라고 못 박습니다.
- 표: 위반 행과 경계 행만 출력하고, 경계 Y/N 열을 둡니다.
- 검산: 행 수 검산, 두 경로 합계, 조건 재확인
- 마지막 줄: 답 형식을 고정해서 그대로 옮겨 적기만 하면 되게 합니다.
마치며, 무엇부터 바꿔 볼까요?
연습을 반복하면서 느낀 건, AI가 계산을 틀리는 경우보다 내가 조건을 빠뜨리거나 확인을 건너뛰는 경우가 훨씬 많다는 것입니다. 그래서 이 공식의 절반은 AI에게 시키는 법이고, 나머지 절반은 내가 확인하는 법입니다.
한 줄로 줄이면 이렇습니다.
문제는 원문 그대로, 판정은 전부, 출력은 위반·경계만, 검산은 다른 경로로, 경계는 내 눈으로.
다음 연습에서 한 가지만 바꿔 본다면 검산 줄을 구체적으로 쓰는 것부터 해 보시기 바랍니다. 그것만으로도 결과가 달라집니다.