핵심 요약
임베디드 리눅스에서 프로그램이 Segmentation fault(SIGSEGV)로 죽었을 때는 gdb core dump 분석으로 사후 메모리 상태를 점검하거나, 보드에서 gdbserver를 띄우고 호스트 PC의 gdb에서 target remote 보드IP:포트로 연결해 실시간으로 디버깅합니다. core dump 파일은 디버그 심볼이 포함된 동일 빌드 바이너리와 함께 gdb로 열어 bt로 죽은 위치를 확인합니다. gdbserver에는 자체 보안 기능이 전혀 없으므로 반드시 사설 격리망에서만 연결해야 합니다.
보드에서 동작하던 프로그램이 갑자기 Segmentation fault를 내며 종료되면 콘솔 로그만으로는 원인 위치를 특정하기 어렵습니다. 이번 글에서는 gdb core dump 분석과 gdbserver 두 가지 방법을 중심으로 크래시 원인을 어떻게 찾아내는지, 실제 크래시 예제를 빌드하고 실행한 결과를 있는 그대로 살펴보며 정리합니다.
보드에서 죽은 프로그램, core dump로 어디서 죽었는지 보려면?
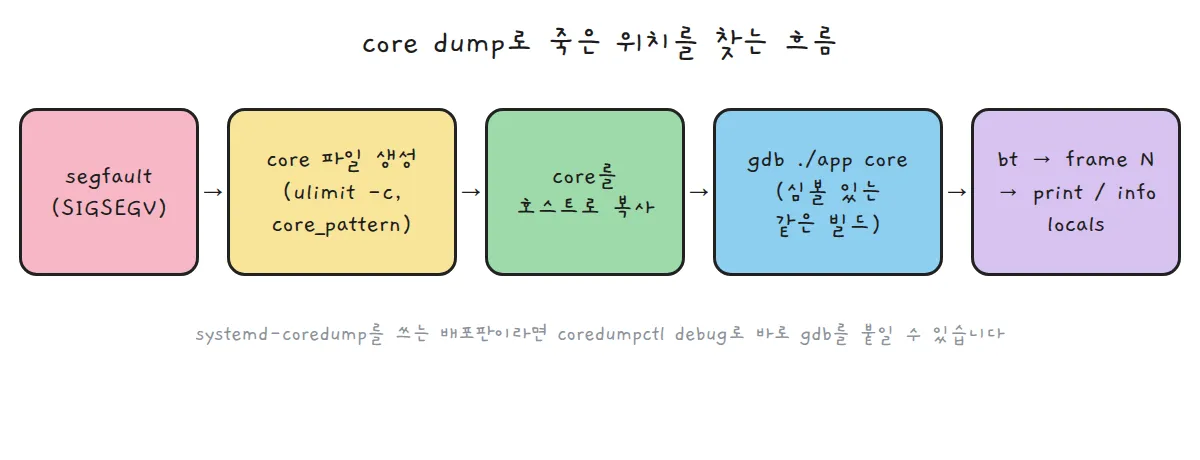
한 줄 답: core 파일 생성을 활성화한 뒤, 디버그 심볼이 포함된 동일 바이너리와 core를 gdb로 함께 열어 gdb core dump 분석을 수행하고 bt로 죽은 위치를 확인합니다.
-
리눅스에서 프로세스가 Segmentation fault(SIGSEGV, 시그널 11) 등으로 비정상 종료할 때, 운영체제가 그 순간의 프로세스 메모리 상태를 파일로 기록하는 것을 core dump라고 합니다. core 파일이 생성되려면 셸의 리소스 제한인
ulimit -c가 0이 아니어야 하며,core(5)규격에 따르면RLIMIT_CORE가 0으로 설정되어 있으면 core 파일이 생성되지 않습니다. 코어 파일의 저장 위치와 이름 패턴은 커널 매개변수/proc/sys/kernel/core_pattern에 정의되며, 기본값은core이고%지시자가 치환되며 앞에|가 붙으면 코어가 지정된 프로그램으로 전달됩니다. systemd 기반 배포판에서는systemd-coredump가 코어를 저널에 보관하므로,coredumpctl debug명령 하나로 마지막에 발생한 크래시의 코어 덤프에 바로 디버거(기본값 gdb)를 붙일 수 있습니다. -
성공적인 gdb core dump 분석의 전제조건은 ‘동일한 빌드 바이너리’와 디버그 심볼(
-g)의 확보입니다. 보드에는 플래시와 RAM이 제한적이므로 심볼을 제거(strip)한 바이너리를 배포하더라도, 개발 호스트 PC에는 같은 빌드에서 나온 심볼 포함 바이너리를 반드시 보관해야 합니다. gdb의 기본 명령인break,run,print등은 gdb 기본 사용법을 참고하시기 바라며, 본문에서는 중복 설명을 생략합니다. 메모리 오염을 사전에 잡아내는 방법으로는 AddressSanitizer(ASan) 같은 도구도 함께 활용할 수 있습니다. -
센서 구조체의 버퍼 포인터 할당을 빠뜨려 NULL 포인터에 값을 쓰려다 죽는 작은 C 예제입니다.
/* 일부러 NULL 포인터에 쓰는 작은 크래시 예제 */
#include <stdio.h>
#include <string.h>

struct sensor {
    const char *name;
    int *buf;
};

static void fill(struct sensor *s, int n) {
    for (int i = 0; i < n; i++)
        s->buf[i] = i * 10;          /* buf가 NULL이면 여기서 죽습니다 */
}

int main(void) {
    struct sensor s = { "temp", NULL };   /* 버퍼 할당을 빠뜨림 */
    printf("start: %s\n", s.name);
    fflush(stdout);
    fill(&s, 4);
    printf("done\n");
    return 0;
}
빌드는 gcc -g -O0 -Wall -Wextra crash.c -o crash로 경고 없이 성공합니다. 아래는 x86_64 박스에서 실제로 실행한 결과입니다. root 셸에서 ulimit -c unlimited를 적용한 뒤 ./crash; echo exit=$?로 실행했고, 둘째 줄은 bash가 출력한 메시지이며 PID 값은 실행마다 달라집니다.
start: temp
bash: line 1: 2774473 Segmentation fault      (core dumped) ./crash
exit=139
콘솔에 start: temp가 출력된 직후 셸이 Segmentation fault (core dumped)를 출력하며 종료 코드 139(128 + SIGSEGV)로 끝나는 것을 확인할 수 있습니다. 참고로 이 x86_64 박스에서는 일반 사용자의 core 하드 한계가 0으로 설정되어 있어 root 권한으로 ulimit -c unlimited를 적용했으며, 이 박스의 core_pattern은 /tmp/core.%e.%p.%t로 설정되어 있었습니다(보드마다 경로 설정은 다를 수 있습니다).
- core 파일을 생성한 뒤에는
gdb ./crash core.crash로 core 파일을 바이너리와 함께 열거나(Invoking GDB매뉴얼 근거), gdb 프롬프트에서core-file core.crash를 실행해도 같습니다 (Commands to Specify Files). 아래는 이 x86_64 박스에서 실제 실행한 결과이며, 주소값은 ASLR 등으로 실행마다 달라집니다.
[New LWP 2774473]
[Thread debugging using libthread_db enabled]
Using host libthread_db library "/lib/x86_64-linux-gnu/libthread_db.so.1".
Core was generated by `./crash'.
Program terminated with signal SIGSEGV, Segmentation fault.
#0  fill (s=0x7ffc741c3a70, n=4) at crash.c:12
12	        s->buf[i] = i * 10;          /* buf가 NULL이면 여기서 죽습니다 */
#0  fill (s=0x7ffc741c3a70, n=4) at crash.c:12
#1  0x000055ebcc1f11f7 in main () at crash.c:19
#0  fill (s=0x7ffc741c3a70, n=4) at crash.c:12
12	        s->buf[i] = i * 10;          /* buf가 NULL이면 여기서 죽습니다 */
$1 = {name = 0x55ebcc1f2004 "temp", buf = 0x0}
$2 = (int *) 0x0
$3 = 0
#1  0x000055ebcc1f11f7 in main () at crash.c:19
19	    fill(&s, 4);
s = {name = 0x55ebcc1f2004 "temp", buf = 0x0}
bt (Backtraces)로 호출 스택이 #0 fill → #1 main () at crash.c:19로 이어짐을 확인하고, frame 0 (Selecting a Frame)으로 이동해 print *s를 실행하면 buf = 0x0, 즉 NULL 포인터임이 바로 드러납니다. print i가 0이므로 첫 번째 루프 반복에서 바로 죽었다는 것도 알 수 있고, frame 1로 올라가 info locals (Information About a Frame)를 보면 main의 s 역시 같은 상태로 호출되었음을 재확인할 수 있습니다.
- 로컬에서 바로 재현할 수 있다면 core 파일을 디스크에 남기지 않고
gdb -batch -ex run -ex bt ./crash로 빠르게 백트레이스만 뽑아낼 수도 있습니다. 아래는 같은 x86_64 박스에서 실제 실행한 결과이며, 주소값은 실행마다 달라집니다.
[Thread debugging using libthread_db enabled]
Using host libthread_db library "/lib/x86_64-linux-gnu/libthread_db.so.1".
start: temp

Program received signal SIGSEGV, Segmentation fault.
fill (s=0x7fffffffe180, n=4) at crash.c:12
12	        s->buf[i] = i * 10;          /* buf가 NULL이면 여기서 죽습니다 */
#0  fill (s=0x7fffffffe180, n=4) at crash.c:12
#1  0x00005555555551f7 in main () at crash.c:19
프로그램이 SIGSEGV를 만나는 즉시 멈추고 백트레이스를 표준 출력으로 바로 보여주므로, CI 파이프라인이나 로컬 셸에서 신속하게 확인할 때 유용합니다.
gdbserver로 보드 프로그램을 호스트 PC에서 원격 디버깅하려면?
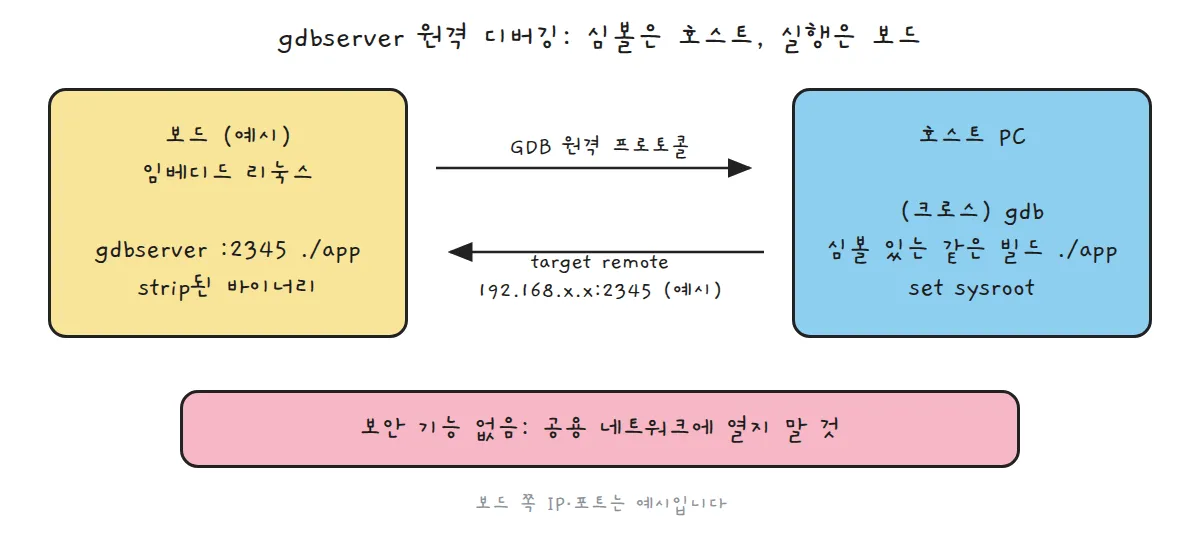
한 줄 답: 보드에서 gdbserver로 프로그램을 띄우고, 호스트 PC의 (크로스) gdb에서 target remote 보드IP:포트로 연결하여 원격 디버깅합니다.
-
보드와 호스트 PC는 역할이 나뉩니다. 보드 쪽에는 가벼운 데몬인
gdbserver만 상주하면서 프로세스 제어와 메모리 접근 중계만 담당합니다. GDB 공식 매뉴얼(Server.html)은 이렇게 설명합니다: “gdbserver does not need your program’s symbol table, so you can strip the program if necessary to save space. GDB on the host system does all the symbol handling.” 즉 gdbserver는 프로그램의 심볼 테이블을 필요로 하지 않으므로 보드에 올라가는 바이너리를 완전히 strip해도 무방하며, DWARF 심볼 해석과 소스 코드 매핑은 호스트의 GDB가 전담합니다. -
gdbserver 보안 경고 (GDB 공식 매뉴얼 원문)
“gdbserver does not have any built-in security. Do not run gdbserver connected to any public network; a GDB connection to gdbserver provides access to the target system with the same privileges as the user running gdbserver.”
gdbserver에는 비밀번호 인증이나 암호화 등 자체 보안 기능이 전혀 구현되어 있지 않습니다. gdbserver가 열려 있는 포트에 연결하는 사람은 그 gdbserver를 실행한 사용자와 동일한 권한을 그대로 갖게 되므로, 절대로 공용 인터넷망에 연결해서는 안 되며 폐쇄된 사설망이나 호스트-타깃 1:1 직결 환경에서만 운용해야 합니다 (Using the gdbserver Program).
- 보드와 호스트 간 연결 절차입니다. 아래 명령은 모두 예시이며, 실제 환경의 포트와 IP는 각자 다릅니다.
보드 측 실행 (예시):
# 예시 (보드 쪽, 포트 2345는 예시 포트)
gdbserver :2345 ./app
포트 2345는 예시 포트입니다. 매뉴얼에 따르면 대상 시스템에서 이미 쓰고 있는 TCP 포트와 겹치지 않으면 어떤 번호든 쓸 수 있고, host:2345 형식의 host 부분은 현재 무시됩니다.
호스트 PC 측 실행 (예시):
크로스 아키텍처 환경에서는 호스트 네이티브 gdb 대신 <toolchain-prefix>-gdb (크로스 툴체인 접두어의 일반적인 예시로 aarch64-linux-gnu-gdb) 또는 다중 아키텍처 지원 패키지인 gdb-multiarch를 사용합니다. 크로스 빌드 환경 구성은 aarch64 크로스 컴파일 CMake를 참고하시기 바랍니다.
# 예시 (호스트 쪽, 192.168.x.x는 예시 IP)
gdb-multiarch
(gdb) file ./app
(gdb) set sysroot <보드 루트 파일시스템 사본 경로>
(gdb) target remote 192.168.x.x:2345
(gdb) continue
file ./app로 호스트에 보관된 심볼 포함 바이너리를 지정하고, set sysroot (Commands to Specify Files)로 타깃 공유 라이브러리 심볼 경로를 지정합니다. target remote 192.168.x.x:2345 (Connecting to a Remote Target)에서 192.168.x.x는 타깃 보드의 예시 IP이며, 이후 continue로 타깃 프로세스를 계속 실행하다가 크래시가 나면 bt로 위치를 확인합니다.
- 보드 환경이 아닌 이 x86_64 박스에서, 로컬 루프백(
localhost:2345)으로 strip 바이너리와 심볼 바이너리의 분리 동작을 실제로 검증했습니다(“x86_64 박스에서 실제 실행”). 심볼이 포함된 바이너리(crash)는 18,848바이트, strip을 적용한 바이너리(crash.stripped)는 14,488바이트였고,nm crash.stripped를 실행하면nm: crash.stripped: no symbols가 출력되어 심볼이 완전히 제거되었음을 확인할 수 있습니다.
gdbserver 쪽(보드 역할, 실제로는 같은 박스) 출력입니다. x86_64 박스에서 실제 실행한 결과이며, PID와 접속해 온 쪽의 포트 번호는 실행마다 달라집니다.
Process ./crash.stripped created; pid = 2774960
Listening on port 2345
Remote debugging from host ::1, port 58264
start: temp
호스트 gdb 쪽(target remote localhost:2345 접속) 출력입니다. 역시 x86_64 박스에서 실제 실행한 결과이며, 주소값은 실행마다 달라집니다.
Reading /lib64/ld-linux-x86-64.so.2 from remote target...
warning: File transfers from remote targets can be slow. Use "set sysroot" to access files locally instead.
Reading /lib64/ld-linux-x86-64.so.2 from remote target...
0x00007ffff7fe42c0 in ?? () from target:/lib64/ld-linux-x86-64.so.2
Reading /lib/x86_64-linux-gnu/libc.so.6 from remote target...

Program received signal SIGSEGV, Segmentation fault.
fill (s=0x7fffffffe210, n=4) at crash.c:12
12	        s->buf[i] = i * 10;          /* buf가 NULL이면 여기서 죽습니다 */
#0  fill (s=0x7fffffffe210, n=4) at crash.c:12
#1  0x00005555555551f7 in main () at crash.c:19
warning: File transfers from remote targets can be slow. Use "set sysroot" to access files locally instead. 경고는 원격 타깃에서 네트워크로 라이브러리를 직접 전송받는 과정이 비효율적임을 보여주며, 왜 호스트에 set sysroot로 로컬 사본을 지정해야 하는지를 그대로 증명합니다. 서버 쪽은 심볼이 전혀 없는 crash.stripped를 실행했음에도, 호스트 gdb에 로드된 심볼 덕분에 크래시 지점이 fill (...) at crash.c:12로 정확히 복원되는 것도 확인할 수 있습니다.
bt가 ?? 로 나오거나 줄 번호가 안 보일 때는 무엇을 확인하나요?
한 줄 답: 빌드 시 -g 디버그 심볼 포함 여부, 호스트와 타깃 바이너리·공유 라이브러리 일치(set sysroot), 컴파일러 최적화(-O2) 여부를 순서대로 점검합니다.
-
백트레이스가 깨지는 원인은 보통 다음 다섯 가지 중 하나입니다.
- 호스트 바이너리와 보드 바이너리가 정확히 같은 빌드인가: 소스를 조금만 고쳐 다시 빌드한 바이너리를 열면 줄 번호와 메모리 오프셋이 실제 타깃 실행 환경과 어긋나 백트레이스가 엉뚱한 줄을 가리키거나 심볼 해석에 실패합니다. ELF의
.note.gnu.build-id해시가 호스트와 타깃 간에 일치하는지 확인해야 합니다. -g옵션을 빠뜨리지 않았는가:-g가 없으면 DWARF 디버그 정보가 생성되지 않아 함수 이름은 보이더라도 소스 파일명과 줄 번호는 표시되지 않습니다.set sysroot및 공유 라이브러리 경로가 올바른가: 크래시가 공유 라이브러리 내부에서 발생했는데 호스트 gdb가 타깃 공유 라이브러리 심볼을 찾지 못하면0x... in ?? () from target:/lib/...처럼 물음표로 표시됩니다.info sharedlibrary로 심볼이 정상 로드되었는지 확인하고, 누락되었다면set sysroot <타깃 루트fs 경로>또는set solib-search-path <경로>를 지정합니다 (Commands to Specify Files).- 호스트 gdb가 타깃 아키텍처를 지원하는가: 호스트의 기본 x86_64 gdb로 다른 아키텍처의 core나 gdbserver 연결을 열면 아키텍처 불일치로 레지스터 프레임을 해석하지 못합니다. 크로스 툴체인의
<toolchain-prefix>-gdb또는gdb-multiarch를 사용해야 합니다. - 컴파일러 최적화로 변수나 함수가 사라졌는가:
-O2,-O3에서는 함수가 인라인되어 스택 프레임에서 사라지거나, 변수가 레지스터 재배치로 인해<optimized out>으로 표시되어print로 값을 볼 수 없습니다. 디버깅할 때는 가급적-O0으로 빌드합니다.
- 호스트 바이너리와 보드 바이너리가 정확히 같은 빌드인가: 소스를 조금만 고쳐 다시 빌드한 바이너리를 열면 줄 번호와 메모리 오프셋이 실제 타깃 실행 환경과 어긋나 백트레이스가 엉뚱한 줄을 가리키거나 심볼 해석에 실패합니다. ELF의
-
정리하면, 현장 보드에서 간헐적으로 발생하는 크래시는 core 파일과 동일 빌드의 심볼 바이너리를 수거해 호스트에서
gdb ./app core로 사후 분석하는 것이 효과적이고, 재현 가능한 결함은 보드에 gdbserver를 띄우고 호스트에서 원격 연결해 브레이크포인트와 변수 변화를 실시간으로 추적하는 것이 빠릅니다.
[시험용/면접 핵심 한 줄] 보드에는 strip 바이너리를 배포하더라도 호스트 PC에 동일 빌드(Build ID 일치)의 심볼 바이너리를 보관해 두면, core dump는 gdb ./app core로 사후 분석하고 실시간 디버깅은 gdbserver와 target remote로 원격 분석하여 bt로 원인 줄을 찾을 수 있습니다.
면접 답변 템플릿: “임베디드 리눅스에서 프로그램이 SIGSEGV로 죽었을 때는 core dump 사후 분석과 gdbserver 원격 디버깅 두 가지 방법을 씁니다. 보드에는 저장공간 절약을 위해 strip된 바이너리를 올리더라도 호스트 PC에 디버그 심볼(-g)이 포함된 동일 빌드 바이너리와 타깃 루트 파일시스템 사본(set sysroot)을 준비해 두면, core 파일을 가져와 bt로 죽은 지점을 확인하거나 gdbserver를 통해 실시간으로 호출 스택과 변수 값을 추적할 수 있습니다. gdbserver는 자체 보안 기능이 전혀 없으므로 공용 네트워크에는 절대 연결하지 않고 사설 격리망에서만 사용해야 합니다.”
실무에서 자주 묻는 질문은 무엇인가요?
Q1. Segmentation fault가 발생했는데 core dump 파일이 생성되지 않습니다. 무엇을 확인해야 하나요?
A1. 먼저 셸의 ulimit -c 값을 확인하십시오. 0이면 core 파일이 기록되지 않으므로 ulimit -c unlimited로 바꿔야 합니다. 다음으로 /proc/sys/kernel/core_pattern에 지정된 경로가 실제 존재하는 디렉터리인지, 그 경로에 쓰기 권한이 있는지 확인하십시오. systemd 기반 환경이라면 코어가 파일 대신 저널에 보관될 수 있으므로 coredumpctl list와 coredumpctl debug도 확인하십시오.
Q2. 호스트 PC에서 gdbserver로 target remote 192.168.x.x:2345를 실행했는데 연결이 되지 않거나 타임아웃이 발생합니다.
A2. 먼저 보드의 방화벽에서 해당 포트(위 예시의 2345는 예시 포트입니다)의 인바운드 트래픽이 허용되어 있는지 확인하십시오. 다음으로 보드의 gdbserver가 Listening on port 2345를 출력한 채 대기 중인지, 그 포트를 다른 서비스가 쓰고 있지 않은지 확인하십시오. 마지막으로 호스트와 보드 사이에 ping이 정상적으로 오가는지 네트워크 구성을 점검하십시오.
Q3. 크래시를 디버깅할 때 strace와 gdb는 언제 나누어 써야 하나요?
A3. strace는 프로세스와 커널 사이의 시스템 콜 경계를 추적하는 도구여서 설정 파일 누락, 권한 거부, 라이브러리 로드 실패 같은 외부 리소스 문제를 볼 때 유용합니다. 반면 gdb(core dump, gdbserver)는 프로세스 내부의 메모리 상태, 호출 스택, 로컬 변수, 잘못된 포인터 참조를 코드 줄 단위로 추적하는 도구입니다. “어떤 시스템 호출에서 실패했는가”는 strace로, “코드의 어느 줄에서 어떤 메모리를 잘못 건드렸는가”는 gdb로 확인합니다.
이 글의 내용은 어디서 확인했나요?
- GDB 매뉴얼: Using the gdbserver Program
- GDB 매뉴얼: Connecting to a Remote Target
- GDB 매뉴얼: Commands to Specify Files
- GDB 매뉴얼: Backtraces
- GDB 매뉴얼: Selecting a Frame
- GDB 매뉴얼: Information About a Frame
- GDB 매뉴얼: Invoking GDB
- Linux 커널 문서: core_pattern
- core(5) 매뉴얼 페이지
- coredumpctl(1) 매뉴얼 페이지
실행 결과는 모두 x86_64 박스(gcc 14.2.0, GNU gdb·gdbserver 16.3)에서 실제로 실행한 출력입니다. 보드 쪽 명령과 192.168.x.x는 예시입니다.