핵심 요약
map unordered_map 차이는 내부 구조에 있습니다: std::map은 키를 정렬된 상태로 유지하는 트리로 탐색·삽입·삭제에 O(log n)을 보장하고, std::unordered_map은 해시 버킷을 사용해 평균 O(1)이지만 순서가 없습니다. 정렬이나 범위 검색이 필요하면 map을, 단건 조회 위주이고 순서가 무관하면 unordered_map을 선택합니다.
코딩테스트와 면접, 실무에서 std::map과 std::unordered_map 중 무엇을 선택해야 할지 고민될 때가 많습니다. 이 글에서는 두 연관 컨테이너의 내부 구조, 시간복잡도, 순회 순서, 메모리 특성을 기준으로 선택 기준을 정리합니다.
map vs unordered_map 차이: 내부 구조(레드블랙 트리 vs 해시 테이블)는?
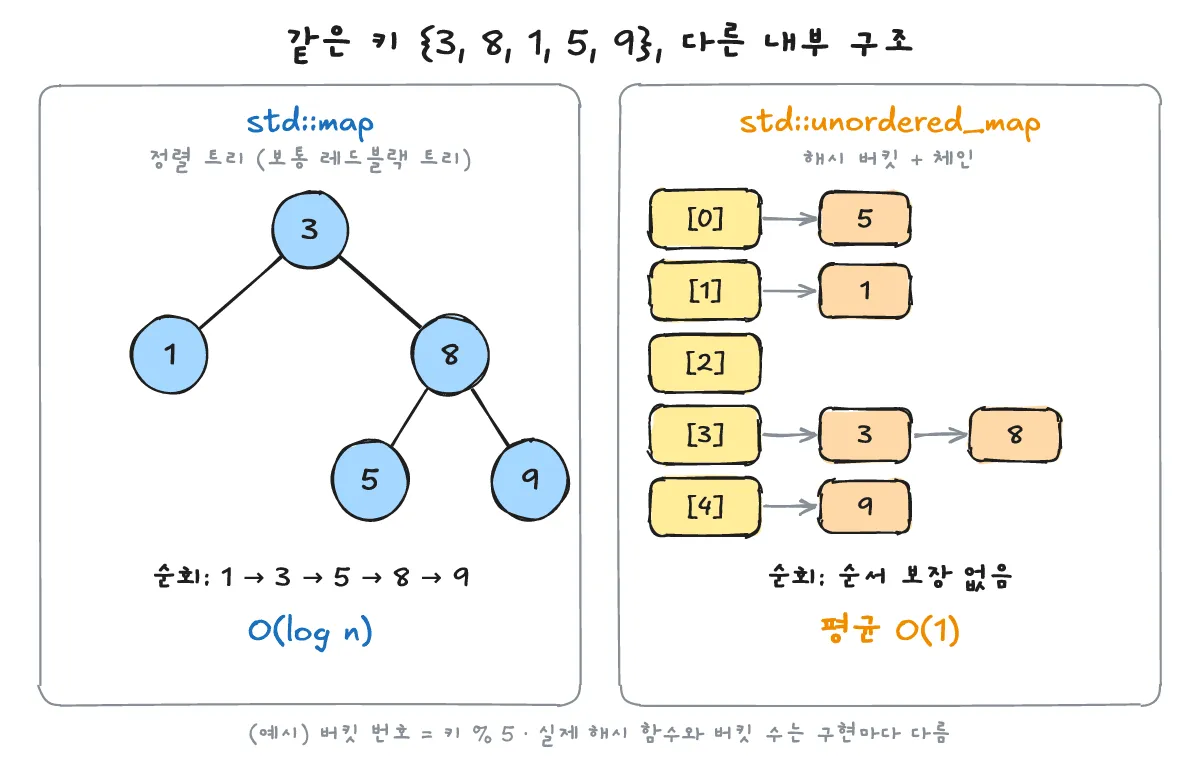
한 줄 답: map = 키 정렬 유지 트리, unordered_map = 해시 버킷입니다.
-
구조: std::map은 키를 정렬된 상태로 유지하는 트리 구조로, 보통 레드블랙 트리로 구현합니다(표준은 복잡도·동작만 규정하고 레드블랙 트리를 강제하지 않습니다). std::unordered_map은 키의 해시값으로 버킷을 정해 원소를 담는 해시 테이블입니다. (출처: std::map, std::unordered_map)
-
키 요구사항: map은 키 비교(operator< 또는 Compare, 기본 std::less)가 필요하고, unordered_map은 해시(std::hash 또는 Hash)와 같음 비교(operator==, 기본 std::equal_to)가 필요합니다.
-
사용법은 거의 같습니다. 아래 코드의 출력은 정확히 두 줄 “map: 3”과 “unordered_map: 3”입니다.
#include <iostream>
#include <map>
#include <string>
#include <unordered_map>

int main() {
    std::map<std::string, int> m;
    std::unordered_map<std::string, int> um;

    m["apple"] = 3;
    m.insert({"banana", 5});
    um["apple"] = 3;
    um.insert({"banana", 5});

    if (auto it = m.find("apple"); it != m.end())
        std::cout << "map: " << it->second << '\n';
    if (auto it = um.find("apple"); it != um.end())
        std::cout << "unordered_map: " << it->second << '\n';
}- C++20부터는
find(key) != end()대신m.contains(3)처럼contains(key)로도 존재 여부를 확인할 수 있습니다. 위 코드는 C++17 기준입니다.
#include <iostream>
#include <map>

int main() {
    std::map<int, char> m{{3, 'c'}};
    if (m.contains(3))  // C++20
        std::cout << "found\n";
}
시간복잡도 O(log n) vs 평균 O(1), 최악의 경우는?
한 줄 답: map은 탐색·삽입·삭제 모두 O(log n)을 보장하고, unordered_map은 평균 O(1)이지만 해시 충돌 시 최악 O(n)이 될 수 있습니다.
-
map: 탐색·삽입·삭제 모두 O(log n)(logarithmic)입니다.
-
unordered_map: 평균 O(1)이지만, 해시 충돌이 한 버킷에 몰리면 최악 O(n)(컨테이너 크기에 선형)이 될 수 있습니다.
-
rehash: 원소가 늘어 load factor(버킷당 평균 원소 수)가 max_load_factor를 넘으면 버킷을 늘려 원소를 재배치(rehash)합니다. 이때 모든 반복자가 무효화되지만, 원소를 가리키는 참조·포인터는 그 원소를 지우기 전까지 유지됩니다.
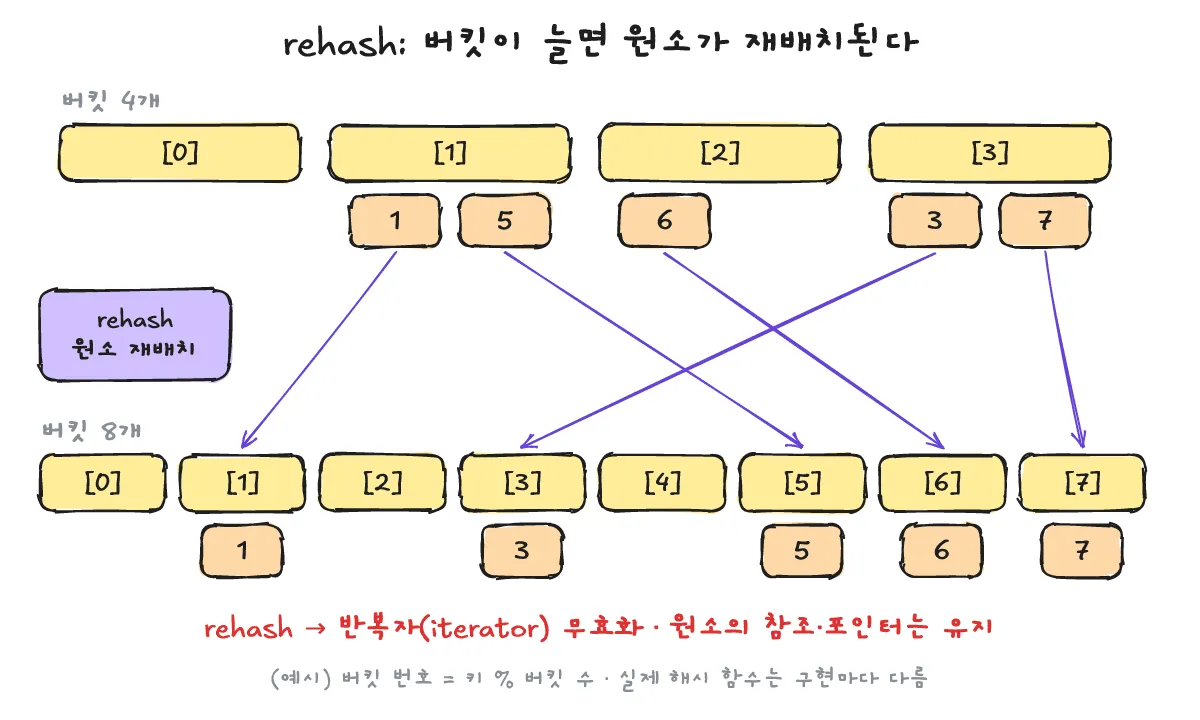
- reserve(n)로 n개까지는 rehash 없이 넣을 수 있게 버킷을 미리 확보할 수 있고, max_load_factor로 기준을 조절할 수 있습니다. 아래 코드의 첫 출력 줄은 1000입니다.
#include <iostream>
#include <unordered_map>

int main() {
    std::unordered_map<int, int> um;
    um.reserve(1000);  // 원소 1000개까지는 rehash 없이 넣을 수 있도록 버킷을 미리 확보

    for (int i = 0; i < 1000; ++i)
        um[i] = i * i;

    std::cout << um.size() << '\n';           // 1000
    std::cout << um.max_load_factor() << '\n'; // 버킷당 평균 원소 수의 상한
}
정렬된 순회·키 범위 검색·메모리가 필요할 때 기준은?
한 줄 답: 정렬된 순회와 키 범위 검색이 필요하면 map을, 단건 조회가 많고 순서가 무관하면 unordered_map을 씁니다.
-
순회 순서: map은 항상 키 오름차순(Compare 기준)으로 순회하지만, unordered_map은 순서가 보장되지 않습니다(구현·버킷 수에 따라 다르고 rehash 후 바뀔 수 있습니다).
-
범위 검색: lower_bound/upper_bound(키 순서 기반)는 map에만 있습니다. 아래 코드에서 map의 출력은 “1 3 5 8 9”와 “5 8”입니다. unordered_map 루프는 순서 보장이 없으므로 샘플 출력을 제시하지 않습니다.
#include <iostream>
#include <map>
#include <unordered_map>

int main() {
    std::map<int, char> m{{3, 'c'}, {8, 'h'}, {1, 'a'}, {5, 'e'}, {9, 'i'}};

    for (const auto& [k, v] : m)
        std::cout << k << ' ';   // 1 3 5 8 9 (항상 키 오름차순)
    std::cout << '\n';

    // 키가 4 이상 8 이하인 원소만 순회
    for (auto it = m.lower_bound(4); it != m.upper_bound(8); ++it)
        std::cout << it->first << ' ';   // 5 8
    std::cout << '\n';

    std::unordered_map<int, char> um(m.begin(), m.end());
    for (const auto& [k, v] : um)
        std::cout << k << ' ';   // 순서 보장 없음 (구현·버킷 수에 따라 다름)
    std::cout << '\n';
}- 커스텀 키: unordered_map은 std::hash 특수화나 해시 함수 객체 + operator==가 필요하지만, map은 operator<(또는 Compare)만 있으면 됩니다. 아래 코드의 해시 조합은 설명용 간단한 예시이며, 권장되는 고품질 해시가 아닙니다. 출력은 1입니다.
#include <cstddef>
#include <functional>
#include <iostream>
#include <string>
#include <unordered_map>

struct Point {
    int x;
    int y;
    bool operator==(const Point& o) const { return x == o.x && y == o.y; }
};

struct PointHash {
    std::size_t operator()(const Point& p) const {
        std::size_t h1 = std::hash<int>{}(p.x);
        std::size_t h2 = std::hash<int>{}(p.y);
        return h1 ^ (h2 << 1);  // 설명용 간단한 조합
    }
};

int main() {
    std::unordered_map<Point, std::string, PointHash> names;
    names[{1, 2}] = "A";
    std::cout << names.count({1, 2}) << '\n';  // 1
}-
메모리(정성): map은 원소마다 트리 노드(자식·부모 연결 정보 포함)를 갖고, unordered_map은 버킷 배열 + 원소 노드를 갖습니다. 어느 쪽이 더 적게 쓰는지는 구현과 load factor에 따라 달라 단정하지 않습니다.
-
결정 표:
| 상황 | 선택 |
|---|---|
| 정렬된 순회·키 범위 검색이 필요 | map |
| 단건 조회가 많고 순서 무관 | unordered_map |
| 키의 해시 함수를 만들기 어렵고 비교만 가능 | map |
| 최악의 경우에도 O(log n) 보장이 필요 | map |
[면접용 2문장] map은 키를 정렬된 트리로 관리해 탐색·삽입·삭제가 O(log n)으로 보장되고 정렬 순회·범위 검색이 됩니다. unordered_map은 해시 테이블이라 평균 O(1)로 빠르지만 순서가 없고 충돌이 몰리면 최악 O(n)이므로, 정렬·범위가 필요 없고 단건 조회가 많을 때 고릅니다.
이해했는지 Q&A로 확인해 볼까요?
Q1. map의 내부 구조는 무조건 레드블랙 트리입니까?
A1. 아닙니다. C++ 표준은 복잡도와 동작(O(log n) 보장 등)만 규정하며 특정 자료구조를 강제하지 않습니다. 다만, 이를 만족하기 위해 보통 레드블랙 트리로 구현합니다.
Q2. unordered_map에서 원소가 늘어 재배치(rehash)가 발생하면 어떻게 됩니까?
A2. 버킷 배열이 재할당되면서 모든 반복자(iterator)는 무효화됩니다. 하지만 원소를 가리키는 참조(reference)나 포인터는 원소를 직접 지우기 전까지 유지됩니다.
Q3. 데이터가 아주 적을 때도 unordered_map이 항상 빠릅니까?
A3. 아닙니다. 평균 O(1)은 데이터가 늘어날 때의 경향을 말할 뿐이고, 데이터가 적을 때는 해시 계산 같은 고정 비용의 비중이 커지므로 어느 쪽이 빠른지는 실제 환경에서 측정해 봐야 합니다.