핵심 요약
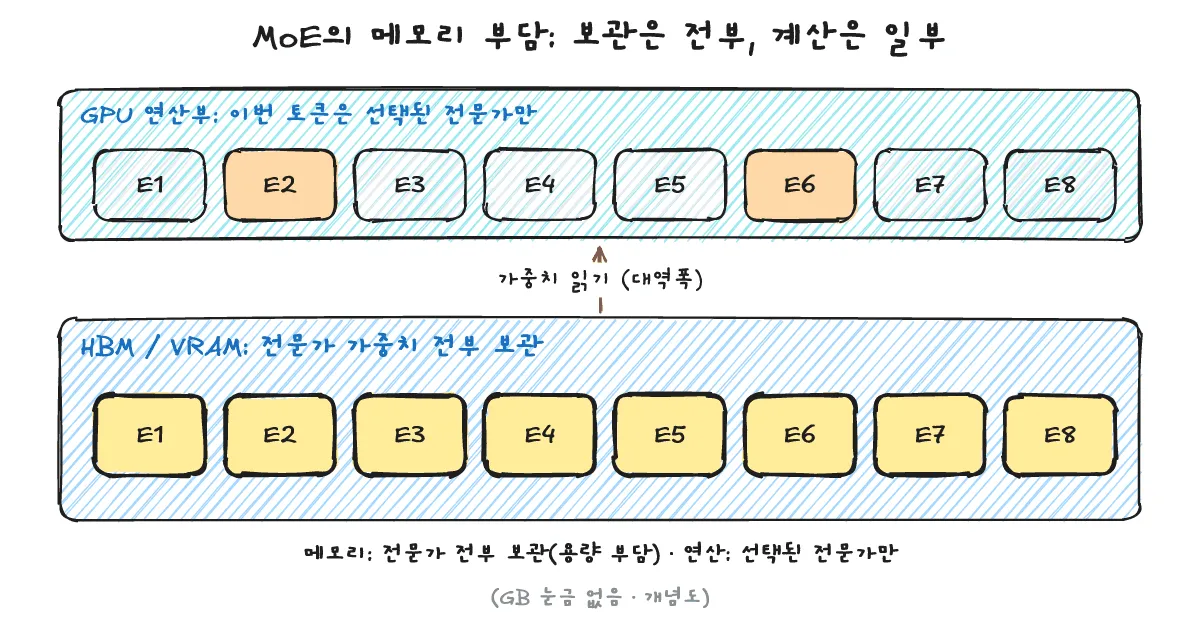
MoE란 FFN 하나 대신 여러 전문가 FFN을 두고, 라우터가 토큰마다 일부(top-k) 전문가만 골라 계산하는 구조입니다. 토큰당 연산은 일부 전문가만 하지만 모든 전문가를 메모리에 올려 둬야 해 용량 부담이 큽니다.
이 글은 SK하이닉스 AI 해커톤 1차 예선(10/17–18)을 준비하며 정리하는 AI 공부 노트 시리즈입니다. 지난 글에서 토큰과 컨텍스트 윈도우를 정리했고, 오늘은 MoE(Mixture of Experts) 구조와 메모리 부담을 정리합니다.
MoE란? 토큰마다 일부 전문가만 쓰는 구조는?
한 줄 답: FFN 하나 대신 여러 전문가 FFN을 두고, 라우터가 토큰마다 일부(top-k)만 골라 계산하는 구조입니다.
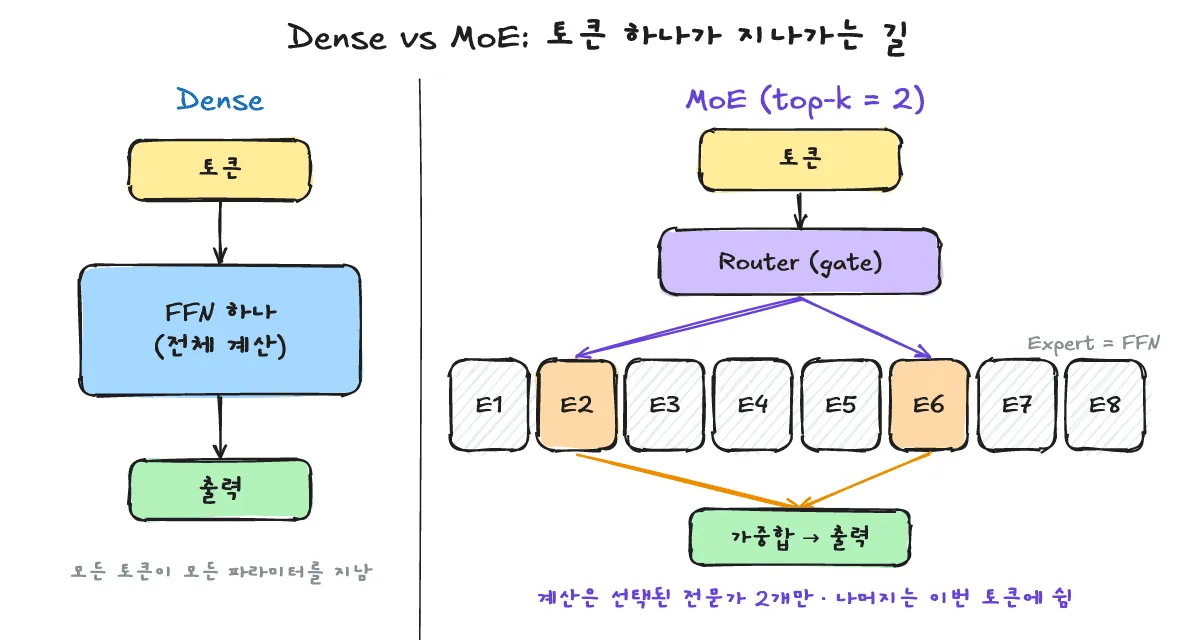
- 트랜스포머 블록에서 FFN이 자리하던 위치가 MoE 레이어로 바뀌는 지점은 Day2 트랜스포머 블록 글에서 다룹니다.
- 라우터(Gate network/router)는 학습되는 작은 네트워크로, 토큰이 어느 전문가로 갈지 결정합니다. 토큰은 하나 이상의 전문가(top-k)로 보내질 수 있으며, Switch Transformers는 1개의 전문가로만 라우팅합니다.
- [비유] 종합병원 접수처(라우터)가 증상(토큰)에 맞는 진료과(전문가) 2곳으로만 안내하는 것과 비슷합니다.
- ST-MoE 저자들이 다국어 설정으로 학습해 관찰한 결과, 전문가가 특정 언어나 주제별로 깔끔하게 나뉘지 않는 것으로 나타났습니다(“there is no single expert specialized in any given language”, Hugging Face Blog). 대신 인코더 전문가는 구두점이나 고유명사 같은 얕은 개념(shallow concepts) 단위로 특화되는 경향이 있습니다.
Dense vs MoE 차이: 연산량과 전체 파라미터 수가 왜 따로 노나?
한 줄 답: 총 파라미터는 거대하지만, 토큰당 실제 연산에 참여하는 활성 파라미터는 소수의 전문가 분량이기 때문입니다.
- Dense 모델에서는 모든 토큰이 모든 파라미터를 지나가므로, 파라미터 수가 곧 토큰당 연산 규모와 같습니다.
- MoE 모델에서는 “총 파라미터”와 “활성 파라미터”를 구분해야 하며, Sparse 모델과 Dense 모델의 파라미터 수는 직접 비교할 수 없습니다(“one cannot directly compare the number of parameters”, Hugging Face Blog).
- Hugging Face 블로그는 Mixtral 8x7B를 예로 듭니다. 8x7B가 56B가 아니라 47B 파라미터를 갖는 이유는 “only the FFN layers are treated as individual experts, and the rest of the model parameters are shared”이기 때문입니다. top-2를 쓰면 14B 파라미터가 쓰이지만, attention 등이 공유되므로 “the actual number of used parameters is 12B”입니다(Hugging Face Blog).
- 장비가 많고 처리량(throughput)이 높은 환경은 MoE가 유리하지만, VRAM이 적고 처리량이 낮은 환경은 Dense 모델이 더 낫습니다. 또한 Sparse 모델은 과적합에 더 취약해(“Sparse models are more prone to overfitting”, Hugging Face Blog) 역사적으로 파인튜닝이 어려운 편이었습니다.
| 구분 | 파라미터 활용 (활성 파라미터) | 메모리 요구 (VRAM) | 토큰당 연산 속도 | 파인튜닝/학습 특성 |
|---|---|---|---|---|
| Dense | 전체 파라미터 모두 연산에 참여 | 파라미터 수에 비례 | 파라미터 전체만큼 계산 | 기준 |
| MoE (Sparse) | 소수의 선택된 전문가 분량만 활성화 | 큼 (모든 전문가 상주 필요) | 동일 파라미터 대비 훨씬 빠름 | 과적합(overfitting)에 더 취약 |
MoE가 메모리 용량·대역폭(HBM)에 주는 부담은?
한 줄 답: 계산은 일부 전문가만 하더라도 모든 전문가의 가중치를 메모리에 올려 둬야 하므로 용량 부담이 큽니다.
- 계산에 쓰지 않는 전문가까지 모든 파라미터를 메모리에 올려야 합니다(“all parameters need to be loaded in RAM, so memory requirements are high”, Hugging Face Blog).
- 특정 전문가로 토큰이 쏠리는 것을 막기 위해 보조 손실(load balancing auxiliary loss)을 두어 “encourage giving all experts equal importance”하도록 유도합니다(Hugging Face Blog). Expert capacity를 초과한 토큰은 잔차 연결(residual connections)로 다음 레이어로 넘어가거나 버려질 수 있으며, 전문가를 여러 장치에 나눠 두는 방식을 expert parallelism이라고 부릅니다.
- 연산 대비 메모리 용량이 큰 구조이다 보니 HBM 용량과 대역폭이 특히 중요해지는데, 이 메모리 바운드 관점은 Day3 메모리 바운드 글에서 다룹니다.
- MoE의 메모리 부담을 줄이기 위한 양자화(Quantization) 연구도 있습니다. 자세한 내용은 「양자화(Quantization)란? FP16·INT8·INT4 차이와 LLM 메모리가 줄어드는 이유」 글에서 다룹니다.
[시험용 한 줄] MoE는 FFN을 여러 전문가로 나누고 라우터를 통해 토큰을 분배하여 추론 효율을 높입니다. 단, 활성화되지 않은 가중치도 메모리에 올려야 해 메모리 용량 부담이 크고(HBM 용량·대역폭이 중요), 파인튜닝 시 과적합에 더 취약합니다.
배운 내용을 퀴즈로 확인해 볼까요?
Q1. Mixtral 8x7B는 연산할 때도 47B 파라미터 전체를 사용합니까?
A1. 아닙니다. Hugging Face 블로그에 따르면 top-2에서 실제 사용 파라미터는 12B이지만, 메모리에는 47B 전체를 올려 두어야 합니다.
Q2. MoE에서는 한국어, 영어처럼 언어마다 전담 전문가가 깔끔하게 생깁니까?
A2. 아닙니다. ST-MoE 관찰 결과 언어별 전담 전문가는 없었고, 인코더 전문가는 언어나 주제별로 깔끔하게 나뉘기보다는 구두점, 고유명사 같은 얕은 개념(shallow concepts) 단위로 나뉘는 경향이 있습니다.
Q3. 한 전문가에게 토큰이 지나치게 몰리면 어떻게 됩니까?
A3. Expert capacity(전문가 용량)를 초과한 토큰은 다음 레이어로 넘어가거나(residual connections) 버려질 수 있습니다. 이를 막기 위해 보조 손실(auxiliary loss)로 균등한 분배를 유도합니다.