핵심 요약
NPU GPU 차이를 한마디로 하면 설계 초점의 차이입니다. GPU는 수많은 코어가 같은 연산을 병렬로 돌리는 범용 병렬 프로세서이고, NPU는 신경망의 곱셈-누산(MAC) 연산에 맞춰 만든 전용 가속기입니다. 이 글에서는 구조, 학습과 추론, 전력과 용도를 초보자와 임베디드 개발자 눈높이로 비교합니다.
한 줄 답: GPU는 유연한 범용 병렬 프로세서이고 NPU는 MAC 배열 중심의 신경망 전용 가속기입니다. 차이는 “GPU는 행렬곱을 못 한다”가 아니라, 유연성 대 고정된 데이터 흐름·온칩 메모리·전력이라는 설계 초점입니다.
NPU와 GPU는 각각 무엇인가요?
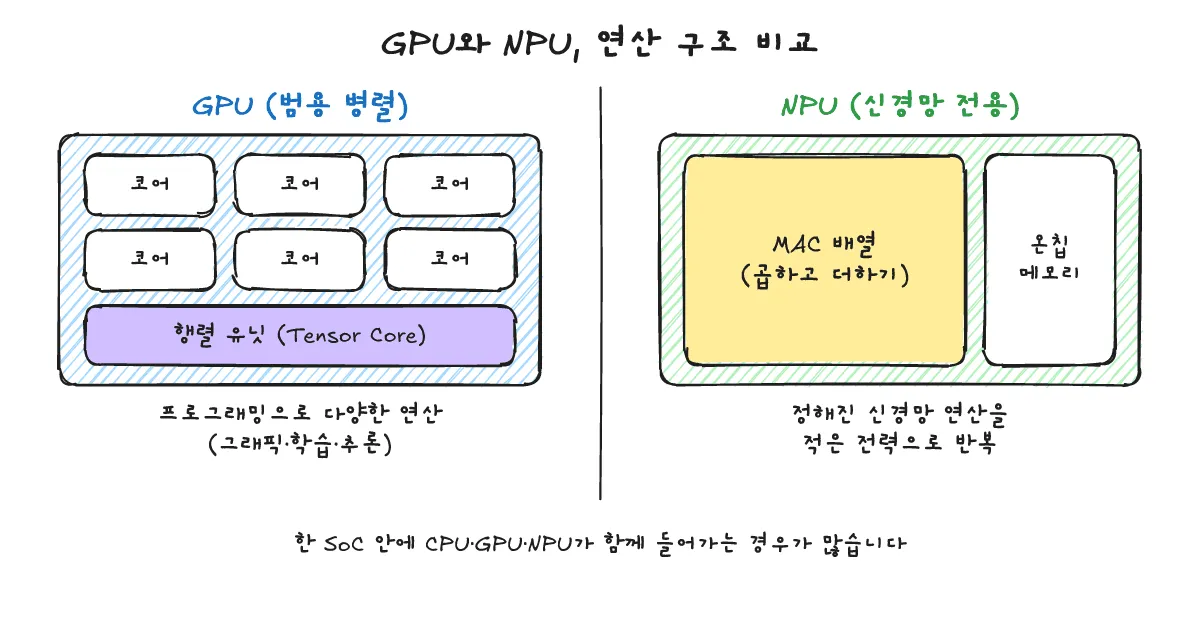
한 줄 답: NPU GPU 차이의 출발점은 GPU가 원래 그래픽용으로 만들어진 범용 병렬 프로세서이고, NPU는 행렬곱·합성곱의 곱셈-누산(MAC)에 맞춘 신경망 전용 가속기라는 점입니다.
GPU는 원래 그래픽 처리를 위해 만들어졌습니다. 수많은 코어가 같은 연산을 동시에 병렬로 돌리는 구조이며, CUDA 같은 프로그래밍 모델 덕분에 그래픽 외에도 다양한 연산을 올릴 수 있습니다.
NPU는 신경망 연산에 맞춰 만든 전용 가속기입니다. 신경망의 대부분을 차지하는 행렬곱과 합성곱은 결국 곱하고 더해 누적하는 MAC 연산의 반복이고, NPU는 이 연산을 효율적으로 처리하도록 설계됩니다.
한 칩(SoC) 안에 CPU, GPU, NPU가 함께 들어 있는 경우도 흔합니다. 그래서 “무엇이 더 좋은가”보다 “어떤 일을 어디에 맡기는가”로 보면 이해하기 쉽습니다.
구조는 어떻게 다르고, 행렬곱·MAC 배열은 무엇인가요?
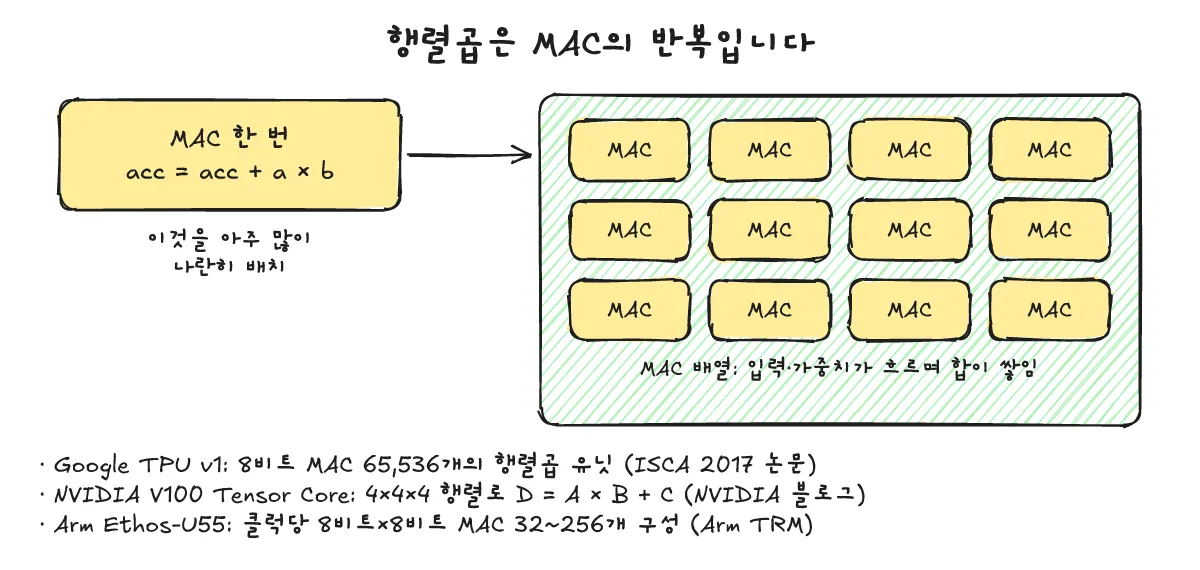
한 줄 답: MAC은 곱하고 더해 누적하는 연산(acc += a×b)이고 행렬곱은 MAC의 반복입니다. NPU는 MAC을 배열로 깔고 온칩 메모리와 묶는 반면, GPU도 이제 행렬 유닛(Tensor Core)을 갖고 있어 차이는 정도와 설계 초점입니다.
MAC(Multiply-Accumulate)은 두 값을 곱해서 누적값에 더하는 연산입니다. 행렬곱은 이 연산을 아주 많이 반복한 것입니다.
// 개념 예시(실행 안 함)
acc += a * b;
TPU v1: Google TPU v1 논문(Jouppi et al., ISCA 2017)은 “the heart of the TPU is a 65,536 8-bit MAC matrix multiply unit”이라고 설명하며, 최대 성능은 92 TOPS, 소프트웨어가 관리하는 온칩 메모리는 28 MiB라고 합니다. 데이터센터에는 2015년부터 배치되었고 추론 단계를 가속하는 장치입니다. 또 CPU와 GPU의 시간에 따라 달라지는 최적화(캐시, 비순차 실행, 멀티스레딩 등)와 달리 결정적(deterministic) 실행 모델을 쓴다고 설명합니다. TPU 자체는 TPU 글에서 따로 다룹니다.
NVIDIA Tensor Core: NVIDIA 기술 블로그(Programming Tensor Cores in CUDA 9)에 따르면 V100의 Tensor Core 하나는 4x4x4 행렬 처리 배열로 D = A * B + C를 수행합니다. A, B는 FP16이고 C, D는 FP16 또는 FP32입니다. 워프(warp)는 이를 묶어 WMMA API로 16x16x16 행렬 곱셈-누산(MMA)에 사용합니다. 또 Turing 튜닝 가이드(NVIDIA Turing Tuning Guide)에 따르면 Turing Tensor Core는 8비트, 4비트, 1비트 입력의 정수 행렬곱을 추가했고 누산은 32비트 정수로 합니다.
Arm Ethos-U55: Arm 기술 참조 설명서(Arm Ethos-U55 NPU TRM 102420)에 따르면 Ethos-U55 microNPU는 클록당 32~256개의 MAC을 구성할 수 있고, 각 MAC은 8비트 x 8비트입니다. MAC 유닛이 합성곱, 벡터 곱, 풀링의 곱셈-누산을 처리하며, Cortex-M과 함께 쓰도록 설계되었습니다.
정리하면 GPU도 Tensor Core라는 행렬 유닛을 갖고 있으므로 “GPU는 행렬 연산을 못 한다”는 말은 맞지 않습니다. 차이는 범용 프로그래밍 가능성과 행렬 유닛을 함께 가진 GPU, 그리고 MAC 배열과 온칩 메모리를 중심으로 데이터 흐름이 대부분 고정된 NPU라는 설계 초점에 있습니다.
학습과 추론에서는 어떻게 쓰임이 나뉘나요?
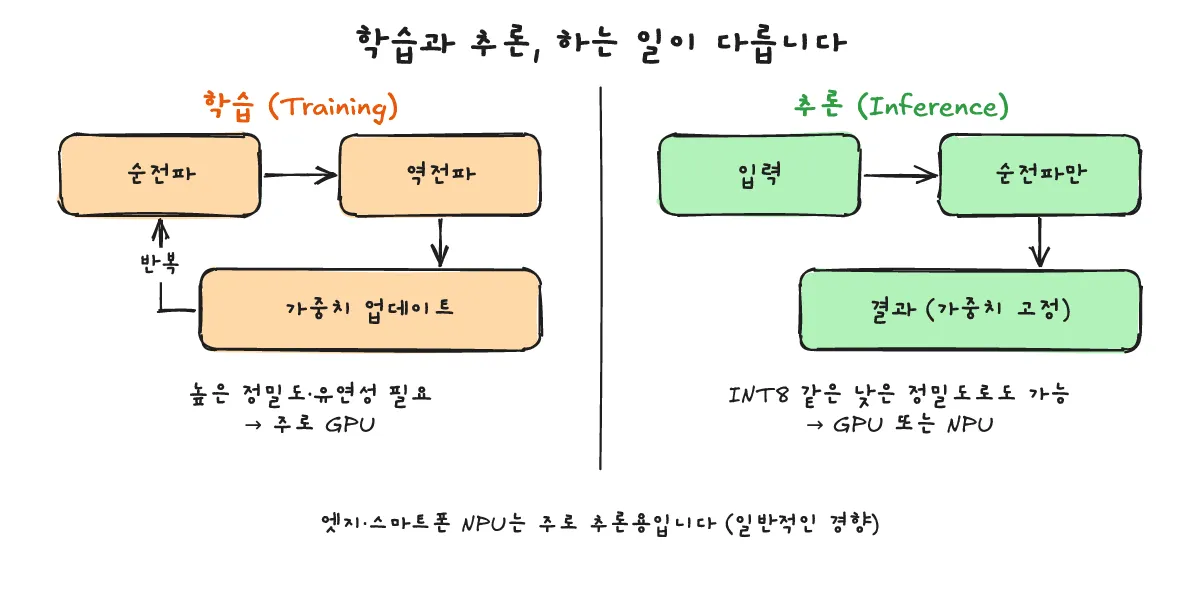
한 줄 답: 학습(순전파+역전파+가중치 갱신을 여러 번 반복)은 높은 정밀도와 유연성이 필요해 GPU를 흔히 쓰고, 추론(가중치를 고정한 순전파)은 많은 NPU가 목표로 하는 영역입니다.
학습은 순전파, 역전파, 가중치 갱신을 아주 많이 반복합니다. FP16, BF16, FP32 같은 부동소수점 정밀도가 주로 쓰이고 연산 종류도 다양해서, 일반적으로 GPU가 많이 쓰입니다.
추론은 가중치를 고정한 채 순전파만 수행하므로 INT8 같은 낮은 정밀도를 쓸 수 있습니다. 그래서 스마트폰과 엣지 SoC의 많은 NPU가 추론을 목표로 합니다. 앞서 본 Ethos-U55는 8비트 MAC을 쓰고(Arm TRM), Rockchip RV1126B NPU는 “3 TOPS @ INT8”로 소개됩니다(Forlinx 제품 페이지). 자세한 내용은 아래 전력·용도 항목에서 다룹니다. TPU v1 역시 추론 가속기였습니다(TPU v1 논문).
이후의 데이터센터 가속기 중에는 학습까지 맡는 것도 있습니다. 세부 사양은 여기서 다루지 않으니 TPU 글을 참고하십시오. 양자화는 깊이 설명하지 않으며, LLM 추론 쪽은 AI 스터디 Day3 LLM 추론·KV 캐시 글을 참고하십시오.
전력과 용도로 보면 무엇을 고르면 되나요?
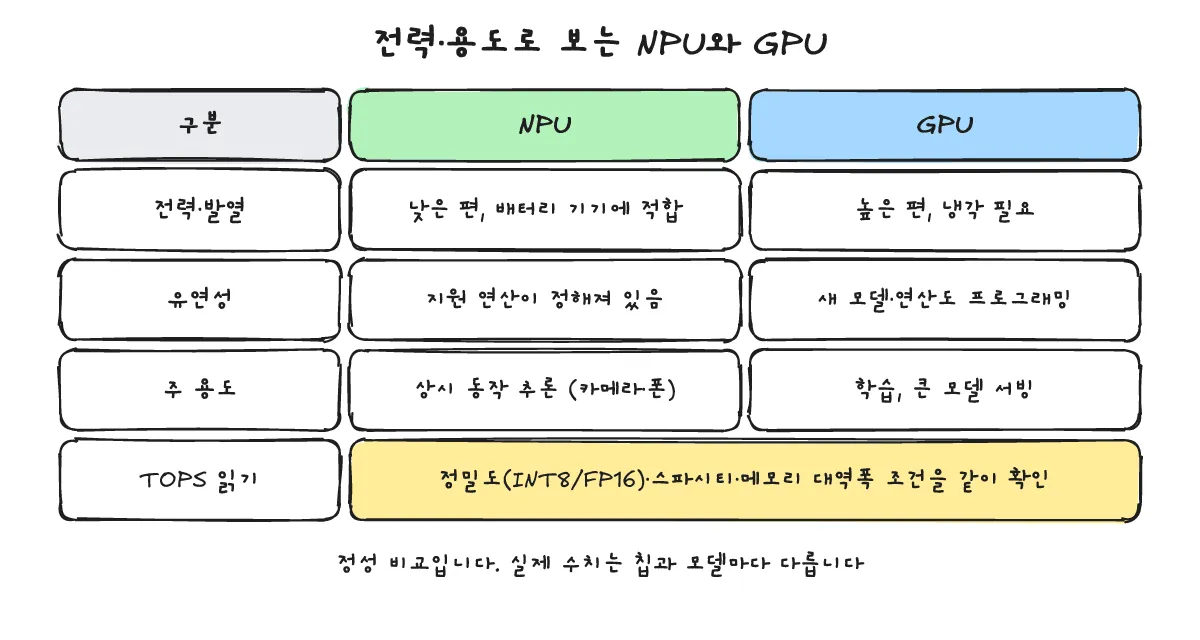
한 줄 답: 저전력·상시 동작·배터리·엣지에서 고정된 모델을 돌리면 NPU, 유연성·학습·큰 모델·새 연산이 필요하면 GPU(전력과 발열은 더 큼)를 고르면 됩니다.
| 구분 | NPU | GPU |
|---|---|---|
| 목적 | 신경망 연산 전용 가속 | 범용 병렬 처리(그래픽, 다양한 연산) |
| 연산 단위 | MAC 배열 + 온칩 메모리 | 다수의 코어 + 행렬 유닛(Tensor Core) |
| 정밀도(주로) | INT8 등 낮은 정밀도 중심 | FP16/BF16/FP32 등 폭넓게 지원 |
| 프로그래밍 유연성 | 지원 연산이 제한적, 컴파일러 의존 | 높음(CUDA 같은 프로그래밍 모델) |
| 전력·발열(정성) | 낮은 편 | 높은 편, 냉각 필요 |
| 대표 용도 | 엣지·모바일 추론, 상시 동작 | 학습, 대형 모델, 새 연산 실험 |
전력 효율 수치로는 TPU 논문(Jouppi et al., 2017)의 주장이 자주 인용됩니다. 평균적으로 당시 GPU(Nvidia K80)나 CPU(Haswell)보다 약 15X30X 빠르고, TOPS/Watt는 약 30X80X 높았다고 합니다. 다만 이것은 2017년 논문에서 2015년 무렵의 특정 칩과 Google 자체 워크로드를 비교한 결과이며, 일반적인 법칙이 아닙니다.
엣지 예시로 Rockchip RV1126B NPU는 Forlinx FET1126Bx-S 제품 페이지(Forlinx FET1126Bx-S)에 “3 TOPS @ INT8”로 나와 있습니다. 이 3 TOPS 수치에 스파시티 조건이 붙는다는 점은 임베디드 비전용 3TOPS급 NPU SoM 글에서 정리했습니다. 또 다른 엣지 NPU 보드는 MediaTek 10TOPS급 AIoT 보드 글에서 볼 수 있습니다.
TOPS를 볼 때는 주의가 필요합니다. 같은 TOPS라도 정밀도(INT8인지 FP16인지), 스파시티 조건, 메모리 대역폭에 따라 달라지며, 최대(peak) 수치가 실제 처리량과 같지는 않습니다. 메모리 대역폭은 HBM과 GPU 메모리 대역폭 글과 HBM5·TSMC CoWoS 검증 글에서 이어서 볼 수 있습니다.
자주 묻는 질문은 무엇인가요?
한 줄 답: NPU와 GPU는 역할이 다르며, 엣지 NPU는 보통 추론용이고, TOPS만으로 속도를 판단할 수는 없습니다.
NPU가 있으면 GPU가 필요 없나요?
아니요, 역할이 다릅니다. NPU가 지원하지 않는 연산은 CPU나 GPU로 넘어가는 경우가 있습니다. Ethos-U55 TRM(Arm TRM)에 따르면 컴파일러가 그래프의 어느 부분을 NPU에서 실행할지 정하고, 나머지는 Cortex-M에서 실행됩니다.
NPU로 학습할 수 있나요?
엣지 NPU는 보통 추론용입니다. 데이터센터 가속기 중에는 학습용도 있으며, 자세한 내용은 TPU 글을 참고하십시오.
TOPS가 높으면 항상 더 빠른가요?
아니요. 정밀도, 스파시티 조건, 메모리 대역폭, 지원 연산에 따라 달라집니다. 메모리 대역폭은 HBM과 GPU 메모리 대역폭 글을 참고하십시오.
함께 보면 좋은 글은 무엇인가요?
한 줄 답: 엣지 NPU 보드, 메모리 대역폭, TPU 글을 이어서 보면 좋습니다.
- MediaTek 10TOPS급 AIoT 보드 글
- 임베디드 비전용 3TOPS급 NPU SoM 글
- HBM과 GPU 메모리 대역폭 글
- HBM5·TSMC CoWoS 검증 글
- TPU 글
- 삼성 파운드리와 HBM 글
- AI 스터디 Day3 LLM 추론·KV 캐시 글
출처는 어디인가요?
한 줄 답: TPU 논문, NVIDIA 문서, Arm 기술 참조 설명서, Forlinx 제품 페이지이며, 2026-10-21에 확인했습니다.