링 버퍼(원형 버퍼, circular buffer)는 임베디드 면접에서 UART 수신 버퍼를 어떻게 구현할지 물을 때 단골로 등장하는 자료구조입니다. 이 글에서는 리눅스 커널 공식 문서의 원형 버퍼 설명과 gcc (Debian 14.2.0-19) 14.2.0으로 확인한 C 예제 코드를 바탕으로 head·tail 이동 원리, 가득 참 판정과 빔 판정 방법, 인터럽트 서비스 루틴(ISR)과 함께 사용할 때의 주의점을 정리합니다.
핵심 요약
링 버퍼는 고정 크기 배열의 끝과 처음을 이어 붙인 것처럼 쓰는 큐입니다. 쓰는 위치(head)와 읽는 위치(tail) 두 개만 움직이고, 끝에 닿으면 0으로 돌아갑니다. head == tail이면 비어 있고, 한 칸을 비워 두는 방식에서는 head 다음 칸이 tail이면 가득 찬 것이라 크기 8이면 7개까지 들어갑니다. UART 수신 인터럽트(생산자)와 메인 루프(소비자)가 하나씩일 때 락 없이 쓰기 좋습니다.
링 버퍼란 무엇입니까?
한 줄 답: 링 버퍼는 고정 크기 배열의 끝과 시작을 이어 붙여, 데이터를 앞으로 당기지 않고 쓰기 위치(head)와 읽기 위치(tail) 인덱스만 이동하는 큐 구조입니다.
일반적인 선형 배열 큐에서 앞쪽 데이터를 꺼낸 뒤 나머지 원소들을 매번 앞으로 한 칸씩 당기면 불필요한 복사 작업이 발생합니다. 반면 링 버퍼(원형 버퍼, circular buffer)는 배열의 원소를 제자리에 그대로 둔 채 두 개의 인덱스만 전진시킵니다.
head: 생산자(producer)가 새 항목을 넣는(쓰는) 위치입니다.tail: 소비자(consumer)가 항목을 꺼내는(읽는) 위치입니다.
면접에서 한 문장으로 답할 때는 “고정 크기 배열의 끝을 지날 때 0번 인덱스로 되돌아가며, 데이터 이동 없이 head와 tail 인덱스만 갱신하는 FIFO 큐입니다”라고 정리할 수 있습니다.
head와 tail은 어떻게 움직입니까?
한 줄 답: 데이터를 넣을 때 head를, 꺼낼 때 tail을 한 칸씩 전진시키며, 버퍼 크기가 2의 거듭제곱이면 나머지 연산 대신 비트 AND 연산(& (SIZE - 1))으로 끝에서 0번 칸으로 되돌립니다.
리눅스 커널의 원형 버퍼 문서에 따르면, 버퍼 크기를 2의 거듭제곱으로 잡으면 인덱스가 배열 끝을 넘어갈 때 나눗셈이 수반되는 나머지 연산 대신 비트 AND 연산(& (SIZE - 1))으로 감싸기(wrap)를 처리할 수 있습니다.
아래 ringbuf.c 예제는 동시성 처리가 전혀 없는 순수 개념 확인용 코드입니다. x86_64 환경의 gcc (Debian 14.2.0-19) 14.2.0에서 gcc -std=c11 -Wall -Wextra ringbuf.c -o ringbuf 명령으로 경고 없이 컴파일하고 실행한 결과입니다.
ringbuf.c:
/* 링 버퍼: 크기 8(2의 거듭제곱), "한 칸 비워 두기" 방식. 단일 생산자/단일 소비자 가정, 동시성 처리 없음(개념 확인용) */
#include <stdio.h>
#include <stdint.h>
#define SIZE 8u
#define MASK (SIZE - 1u)
static uint8_t buf[SIZE];
static unsigned head = 0, tail = 0;            /* head: 쓰기 위치, tail: 읽기 위치 */
static int is_empty(void) { return head == tail; }
static int is_full(void)  { return ((head + 1u) & MASK) == tail; }
static int put(uint8_t c) { if (is_full()) return 0; buf[head] = c; head = (head + 1u) & MASK; return 1; }
static int get(uint8_t *c) { if (is_empty()) return 0; *c = buf[tail]; tail = (tail + 1u) & MASK; return 1; }
int main(void) {
    int n = 0;
    for (uint8_t c = 'A'; c <= 'J'; c++) { if (put(c)) n++; else { printf("put('%c') failed: full\n", c); break; } }
    printf("stored=%d (SIZE=%u, one slot always empty)\n", n, SIZE);
    uint8_t c; printf("read 3: ");
    for (int i = 0; i < 3 && get(&c); i++) printf("%c", c);
    printf("\n");
    put('X'); put('Y'); put('Z');                 /* 끝을 지나 0번 칸으로 돌아감 */
    printf("head=%u tail=%u (head wrapped)\n", head, tail);
    printf("read all: ");
    while (get(&c)) printf("%c", c);
    printf("\nempty=%d\n", is_empty());
    return 0;
}
실행 출력:
put('H') failed: full
stored=7 (SIZE=8, one slot always empty)
read 3: ABC
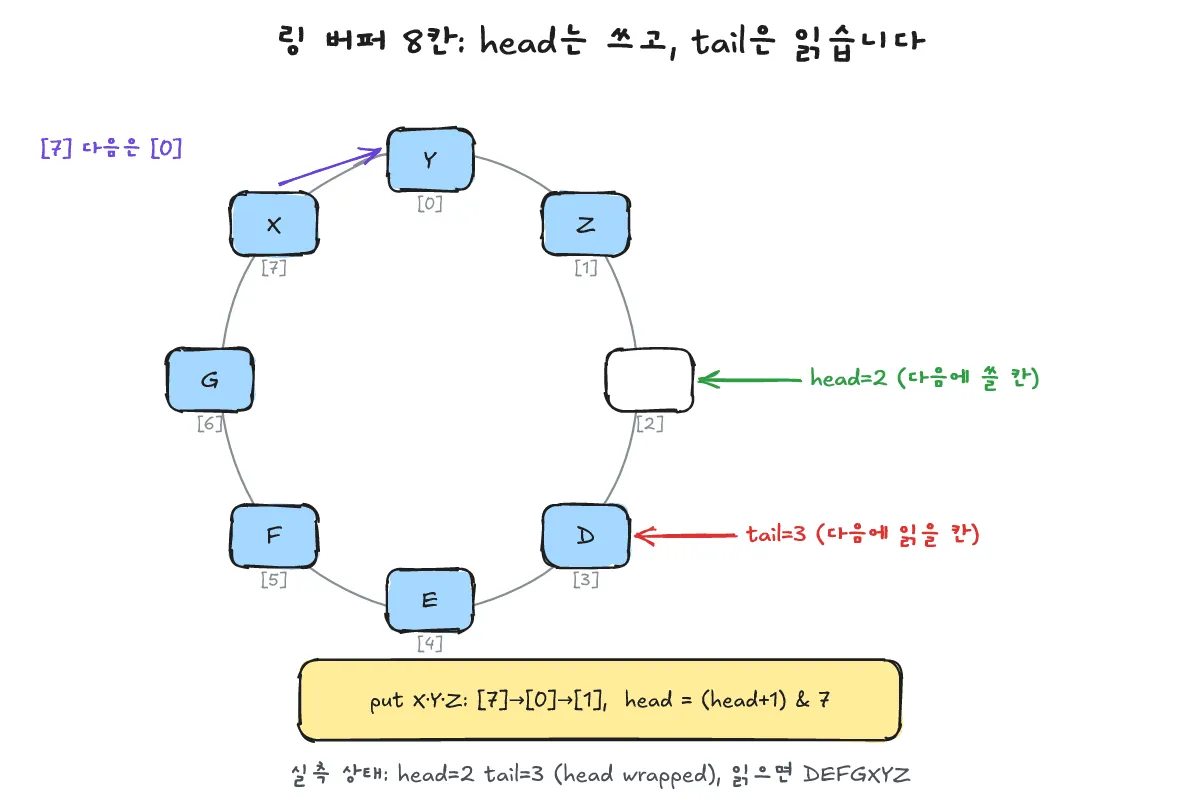
head=2 tail=3 (head wrapped)
read all: DEFGXYZ
empty=1
코드와 출력의 흐름을 단계별로 따라가면 다음과 같습니다.
'A'부터'G'까지 7개의 문자가 들어가고,'H'를 넣으려 할 때는head다음 칸이tail과 같아져 가득 참으로 판정되므로 거절됩니다(stored=7).- 3개를 읽으면
ABC가 순서대로 나오고tail은3으로 이동합니다. - 이어서
'X','Y','Z'를 넣으면head가 배열 끝을 지나 다시0,1,2번 칸으로 돌아가므로head=2가 되어tail=3보다 작은 값을 가리킵니다(head wrapped). - 남은 데이터를 모두 읽으면 넣은 순서 그대로
DEFGXYZ가 출력되고, 다시head == tail상태가 되어 버퍼가 비게 됩니다(empty=1).
가득 참과 빔은 어떻게 구분합니까?
한 줄 답: head == tail을 비어 있음으로 두고 한 칸을 항상 비워 두어 ((head + 1) & MASK) == tail로 가득 참 판정을 하거나, 별도의 count 변수를 두어 구분합니다.
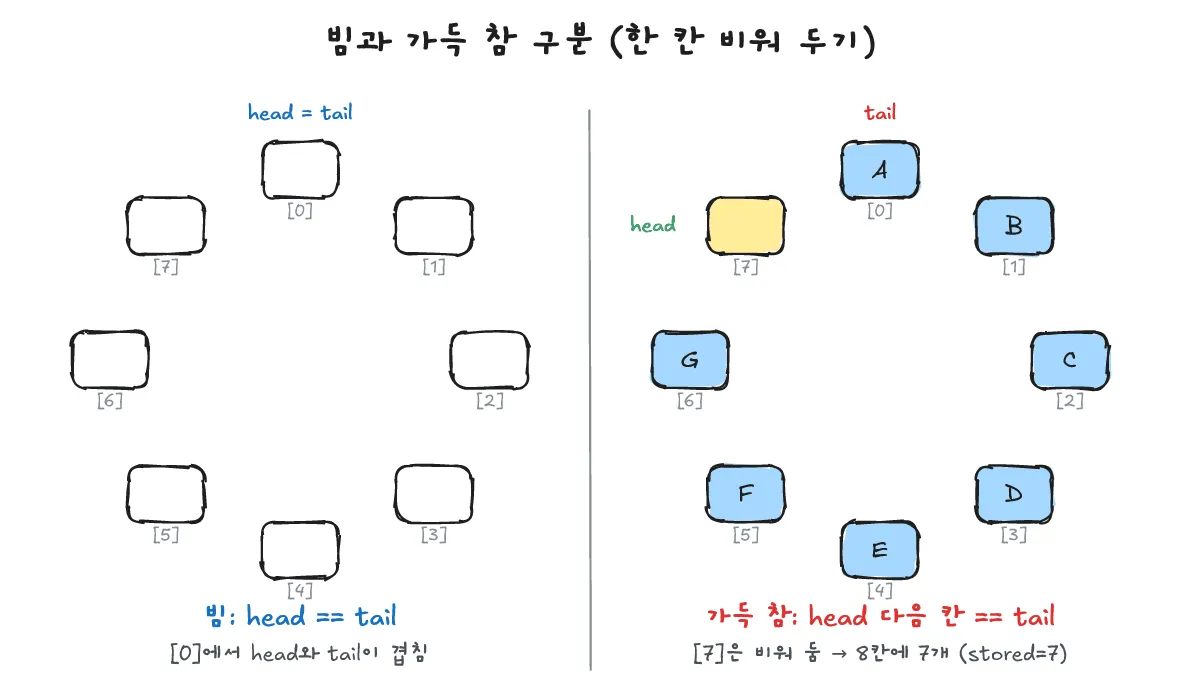
만약 배열의 모든 칸을 끝까지 다 채우면 가득 찬 상태에서도 head == tail이 되어 비어 있는 상태와 구분할 수 없게 됩니다. 이를 해결할 때는 대표적으로 두 가지 방식을 사용합니다.
- 한 칸 비워 두기 방식: 리눅스 커널 원형 버퍼 문서와 위 예제에서 사용한 방식으로,
head == tail이면 비어 있음(empty)이고head가tail바로 한 칸 뒤(즉head의 다음 칸이tail)이면 가득 참(full)으로 판정합니다. 항상 한 칸을 비워 두므로 크기8인 버퍼에는 최대7개까지 저장됩니다. - 별도의
count변수 두기 방식: 현재 저장된 원소 개수를 세는 변수를 따로 두어 배열의 모든 칸을 다 쓰는 방식입니다. 단, 생산자와 소비자가 모두 동일한count변수를 수정하므로 ISR과 함께 쓸 때는 별도의 동기화 주의가 필요합니다.
| 구분 | 한 칸 비워 두기 방식 | 별도 count 변수 방식 |
|---|---|---|
| 비어 있음(Empty) 판정 | head == tail | count == 0 |
| 가득 참(Full) 판정 | ((head + 1) & MASK) == tail (다음 칸이 tail) | count == SIZE |
| 사용 가능한 슬롯 | 항상 한 칸을 비워 둠 (SIZE - 1칸 사용) | 모든 슬롯 사용 가능 (SIZE칸 모두 사용) |
| ISR 동시성 특성 | 생산자는 head만, 소비자는 tail만 수정함 | count 변수를 양쪽이 함께 수정하므로 추가 주의가 필요함 |
UART 인터럽트와 같이 쓸 때 무엇을 조심합니까?
한 줄 답: 단일 생산자(ISR)와 단일 소비자(메인 루프) 조건을 지키면서 ISR은 head만, 메인 루프는 tail만 수정하고, 데이터를 먼저 쓴 뒤 인덱스를 갱신하며, 버퍼가 가득 찼을 때의 정책을 정해야 합니다.
임베디드 시스템에서 수신 대기 방식을 고를 때의 기준은 인터럽트와 폴링, 임베디드 면접에서 어떻게 고르나? 글에서 다룬 것처럼 상황마다 다르며, 직렬 통신 자체의 특징 비교는 I2C vs SPI vs UART 차이: 임베디드 면접에서 어떻게 비교하나? 글에서 확인할 수 있습니다. UART 수신 인터럽트(ISR)가 바이트를 받아 링 버퍼에 넣고 메인 루프가 꺼내 가는 구조를 설계할 때는 다음 원칙을 지켜야 합니다.
- 단일 생산자·단일 소비자 조건 명시: 리눅스 커널 문서에 따르면 생산자와 소비자가 각각 정확히 하나씩일 때만 메모리 배리어와 순서가 보장된 인덱스 접근(커널 문서의
smp_store_release/READ_ONCE형태 접근)을 통해 락 없이 사용할 수 있습니다. 따라서 면접에서는 “언제나 락 없이 안전하다”고 단정하지 말고 단일 생산자·단일 소비자 조건을 분명히 밝혀야 합니다. - 수정하는 인덱스 분리: 생산자인 ISR은 오직
head만 수정하고, 소비자인 메인 루프는 오직tail만 수정합니다. - 데이터를 먼저 쓰고 인덱스는 나중에 갱신: 생산자는 버퍼 슬롯에 데이터를 먼저 기록한 뒤에
head를 갱신해야 소비자가 아직 쓰이지 않은 쓰레기 값을 읽지 않습니다. - 상대방 인덱스 읽기 시 컴파일러 캐싱 방지: 한쪽이 다른 쪽의 인덱스를 반복해서 읽을 때 컴파일러가 레지스터에 값을 캐시해 두지 않도록 C에서는
volatile이나 원자적 접근을 사용하고, C++에서는 원자적 타입을 활용합니다(C++의 원자적 연산과 데이터 레이스 방지는 C++ std::atomic, 데이터 레이스를 막는 법 글을 참고할 수 있습니다). - 가득 찼을 때의 처리 정책 결정: 소비자가 제때 읽지 못해 버퍼가 가득 찼을 때 새로 들어온 데이터를 버릴지(drop), 아니면 가장 오래된 데이터를 덮어쓸지(overwrite) 시스템 요구사항에 맞춰 정해야 합니다. 수신 처리 지연으로 하드웨어 수신 버퍼 자체가 넘치는 현상은 mcp251xfd FIFO overflow, can0에서 RX가 떨어질 때 먼저 볼 것 글의 사례에서도 볼 수 있습니다.
면접 꼬리 질문은 무엇입니까?
한 줄 답: 생산자가 여럿일 때의 동기화 방법, 버퍼 크기를 2의 거듭제곱으로 맞추는 이유, 그리고 DMA 수신과 결합할 때의 인덱스 관리 차이를 자주 묻습니다.
생산자가 여럿이면 어떻게 합니까?
생산자가 둘 이상이면 여러 실행 흐름이 동시에 head를 읽고 수정하려다 충돌하므로, 락을 사용해 생산자들의 접근을 직렬화(serialize)해야 합니다. 임베디드·커널 환경에서 스핀락과 뮤텍스를 구분하는 기준은 스핀락은 뮤텍스 대신 언제 쓰나? 임베디드·커널 면접 기준 글에서 확인할 수 있습니다.
크기를 2의 거듭제곱으로 하는 이유는 무엇입니까?
버퍼 크기가 2의 거듭제곱이면 인덱스가 끝에 도달해 0번으로 돌아갈 때 나눗셈이 수반되는 나머지 연산 대신 비트 AND 연산(& (SIZE - 1))으로 감싸기(wrap)를 처리할 수 있기 때문입니다.
DMA와 같이 쓸 때는 무엇이 다릅니까?
ISR이 바이트마다 깨어나 head를 직접 올리는 대신 DMA 컨트롤러가 생산자가 되어 메모리의 원형 버퍼 영역에 직접 데이터를 기록하며, 소프트웨어는 하드웨어가 가리키는 전송 위치(또는 남은 카운트)를 읽어 어디까지 새 데이터가 들어왔는지 파악합니다. CPU 복사와 DMA의 기본 차이는 DMA란? CPU 복사와 차이, 임베디드·펌웨어 면접에서 어떻게 답하나? 글에서 다룹니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 인터럽트와 폴링, UART 통신 비교, DMA, 스핀락과 뮤텍스, 하드웨어 FIFO 오버플로, C++ 원자적 연산을 다룬 관련 글입니다.
- 인터럽트와 폴링, 임베디드 면접에서 어떻게 고르나?
- I2C vs SPI vs UART 차이: 임베디드 면접에서 어떻게 비교하나?
- DMA란? CPU 복사와 차이, 임베디드·펌웨어 면접에서 어떻게 답하나?
- 스핀락은 뮤텍스 대신 언제 쓰나? 임베디드·커널 면접 기준
- mcp251xfd FIFO overflow, can0에서 RX가 떨어질 때 먼저 볼 것
- C++ std::atomic, 데이터 레이스를 막는 법
출처는 어디입니까?
한 줄 답: 리눅스 커널 공식 문서의 원형 버퍼 가이드와 직접 실행한 GCC 결과입니다.
- Linux Kernel Documentation — Circular Buffers (확인 2026-10-28)
- 직접 실행 환경:
gcc (Debian 14.2.0-19) 14.2.0,x86_64(확인 2026-10-28 KST)