핵심 요약
LLM의 temperature와 top-p는 모델이 다음 토큰을 선택하는 방식을 조절하는 파라미터입니다. 모델은 다음 토큰 확률 분포를 내고, temperature는 그 분포의 모양을, top-p·top-k는 후보 범위를 조절합니다. 따라서 샘플링 방식을 사용하면 같은 질문에도 답이 달라질 수 있습니다.
이 글은 SK하이닉스 AI 해커톤 1차 예선(10/17–18)을 준비하며 정리하는 AI 공부 노트 시리즈입니다. 앞서 살펴본 모델의 추론 과정에 이어, 오늘은 출력된 확률 분포를 바탕으로 실제 토큰을 어떻게 선택하는지 정리합니다.
LLM은 다음 토큰을 어떻게 고르나? greedy vs 샘플링 차이
한 줄 답: 모델은 다음 토큰 확률 분포를 내고, 그중 무엇을 고를지는 별도의 규칙(디코딩 전략)이 정합니다.
- 모델은 다음 토큰의 확률 분포를 출력하고, 그중 무엇을 고를지는 별도의 규칙(디코딩 전략)이 정합니다.
- Decode 단계는 한 토큰씩 생성하므로 매 스텝마다 “고르기”가 일어납니다(Day3 Decode 과정 글 참고).
- greedy: 항상 가장 높은 확률의 토큰을 선택합니다. 일관적이지만 반복적이고 단조로울 수 있습니다.
- 샘플링: 확률에 비례해 무작위로 토큰을 뽑습니다. 이것이 같은 질문에도 답변이 매번 달라지는 이유입니다.
Temperature란? 확률 분포를 뾰족하게·평평하게 만드는 원리
한 줄 답: Softmax를 통과하기 전의 점수(logit)를 T로 나누어, 확률 분포가 얼마나 뾰족한지를 조절합니다.
- Softmax에 넣기 전에 점수(logit)를 T로 나눕니다(Softmax 개념 자체는 Day1 Self-Attention 글에서 다루었으므로 여기서는 다시 설명하지 않습니다). 공식으로 나타내면 p_i = softmax(z_i / T) 입니다.
- T를 낮추면(0에 가까울수록) 분포가 뾰족해집니다. 1등 토큰에 확률이 몰려 greedy 방식에 가까워집니다.
- T를 높이면 분포가 평평해집니다. 다양한 표현이 가능해지지만, 엉뚱한 답이 나올 가능성도 커집니다.
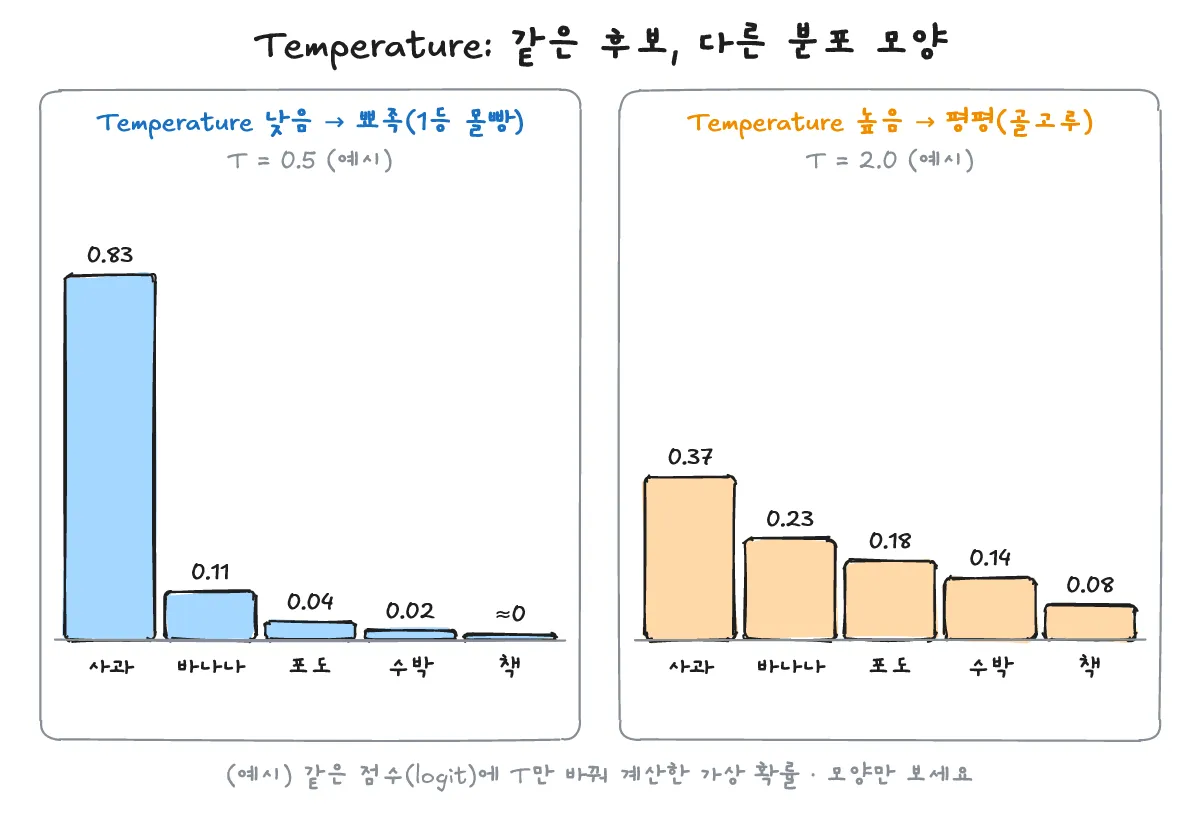
- 예시(설명용 가상값): 임의로 정한 로짓 2.0/1.0/0.5/0/-1.0을 가지고 계산하면, T가 낮을 때(0.5)의 확률은 약 0.83/0.11/0.04/0.02/0.00이고, T가 높을 때(2.0)의 확률은 약 0.37/0.23/0.18/0.14/0.08입니다. 이 수치는 실제 모델 값이 아니라 분포의 모양 변화를 보여주기 위한 가상(예시) 값이며, 분포의 모양만 참고하면 됩니다. 다만 T=0(또는 greedy)이면 거의 같은 답이 나오지만, 구현·배치 처리 방식에 따라 미세한 차이가 생길 수 있어 항상 같다고 단정할 수는 없습니다.
Top-k vs Top-p 차이: 정확한 답·창의적 답에서 언제 무엇을 낮추나?
한 줄 답: Top-k는 후보 개수를 고정하고, Top-p는 누적 확률이 p 이상이 될 때까지 후보를 유동적으로 남깁니다.
- Top-k: 확률이 높은 상위 k개의 후보만 남기고 그 안에서 샘플링합니다.
- Top-p(nucleus sampling): 확률이 높은 순으로 누적 확률이 p 이상이 될 때까지의 최소 후보 집합만 남기고 그 안에서 샘플링합니다(출처: Holtzman et al., 2019, “The Curious Case of Neural Text Degeneration”).
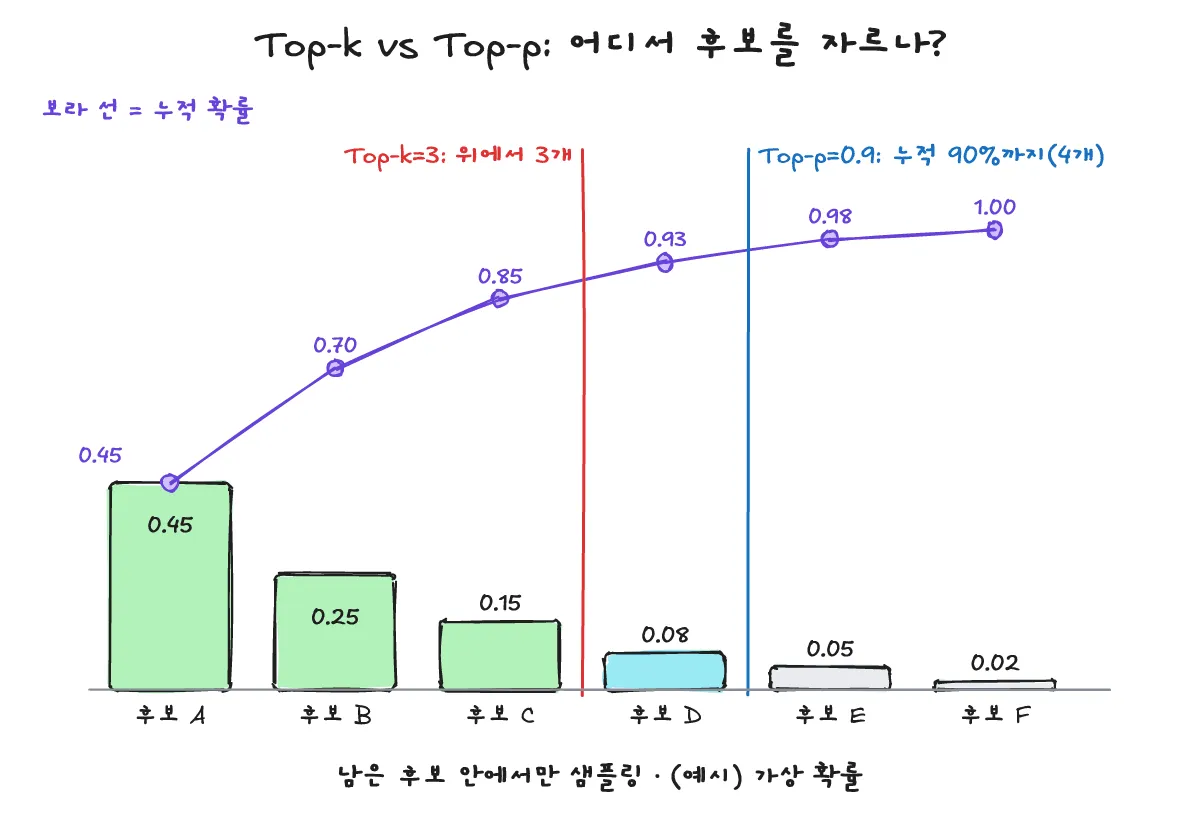
- 차이: k는 후보 개수가 고정되어 있고, p는 분포 모양에 따라 후보 수가 늘었다 줄었다 합니다(분포가 뾰족하면 후보가 적고, 평평하면 후보가 많아집니다). 예시(가상값)로 확률이 0.45/0.25/0.15/0.08/0.05/0.02라면, Top-k=3은 상위 3개만 남기고, Top-p=0.9는 누적 확률이 0.93이 되는 상위 4개까지 남깁니다.
- 실전 가이드(정성적 기준): 코드나 사실 기반 답변처럼 정확성이 중요한 경우에는 temperature나 top-p를 낮게 설정하고, 아이디어나 문장 생성처럼 다양성이 필요한 경우에는 높게 설정합니다.
- 보통 temperature와 top-p를 동시에 크게 바꾸기보다는 둘 중 하나만 조정하는 것이 일반적으로 권장되는 방식입니다.
[시험용 한 줄] temperature = 분포 모양(뾰족/평평), top-k·top-p = 후보 범위(개수/누적확률); 낮추면 일관적이고 정확해지며, 높이면 다양해집니다.
배운 내용을 퀴즈로 확인해 볼까요?
Q1. 모델이 동일한 프롬프트에 대해 거의 같은 답변을 출력하도록 만들려면 어떻게 해야 합니까?
A1. Temperature를 0에 가깝게 설정하거나(또는 greedy 방식을 사용하거나) Top-k=1 등으로 후보를 제한합니다. 다만 구현이나 환경에 따라 미세한 차이가 생길 수 있습니다.
Q2. Top-p=0.9일 때, 모델이 출력하는 토큰 후보의 개수는 항상 같습니까?
A2. 아닙니다. Top-p는 분포의 모양에 따라 후보 수가 동적으로 변합니다. 확률 분포가 뾰족하면 적은 수의 후보만 남고, 평평하면 많은 후보가 남습니다.
Q3. Temperature가 높아지면 확률 분포는 어떻게 변합니까?
A3. 확률 분포가 더 평평해져, 확률이 낮았던 후보 토큰들도 선택될 가능성이 커지므로 더 다양한 답변이 나옵니다.
입력 쪽 설계(프롬프트)는 Day4 프롬프트 엔지니어링 글에서 다룹니다.