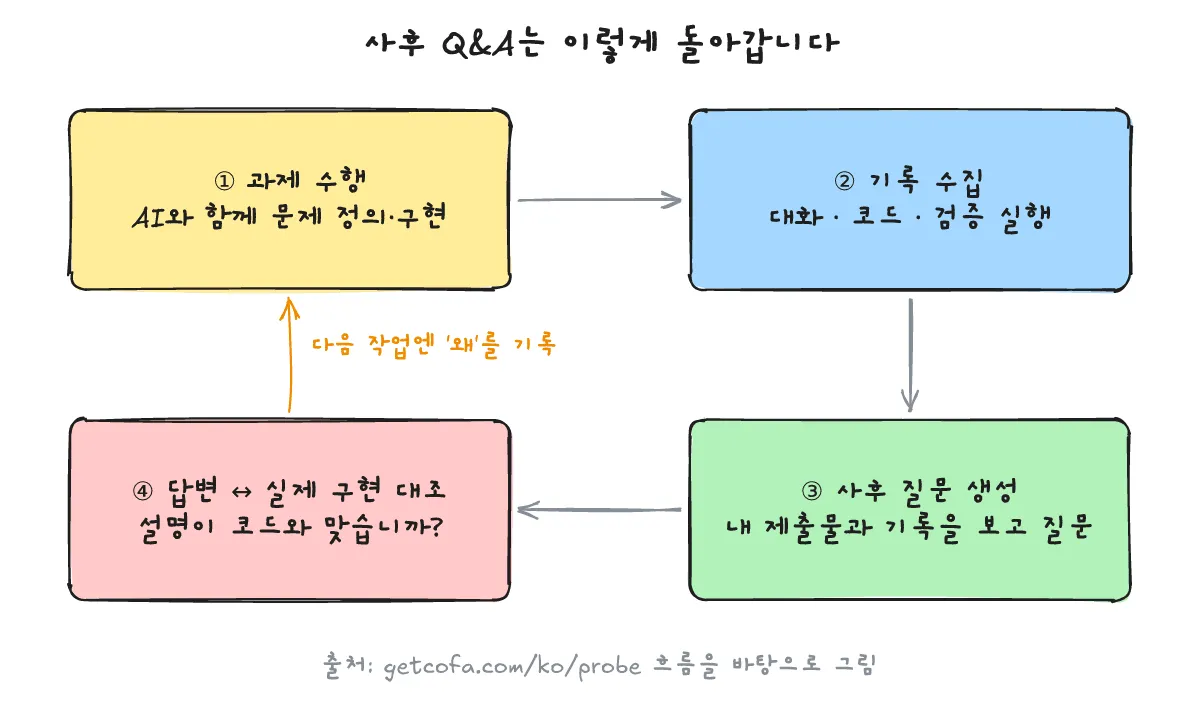
AI 역량 평가 사후 Q&A는 지원자가 과제를 마친 뒤 자신의 결과물과 판단 근거를 직접 설명하고, 그 설명이 실제 구현과 일치하는지 확인하는 단계입니다. SK하이닉스 뉴스룸 공지에 따르면 SK하이닉스 AI 해커톤 2026 온라인 예선에서도 크래프톤의 AI 네이티브 채용·평가 솔루션인 ‘Cofa-Probe’ 등 다양한 AI 활용 역량 평가 도구로 문제 정의, AI 활용, 결과 검증 과정 등을 종합적으로 살펴볼 예정입니다. 이런 방식의 평가는 채용과 대회에서도 쓰이고 있습니다.
핵심 요약
사후 Q&A는 내 제출물과 작업 기록을 바탕으로 질문하고, 내 설명이 실제 구현과 맞는지 대조합니다. 주로 작동 원리와 실패 가능성을 설명할 수 있는지(인지)를 봅니다. 대비는 ‘왜’를 기록해 두고, 약점→위험→다음 검증 순서로 답하는 연습입니다.
AI 역량 평가 사후 Q&A란 무엇입니까?
한 줄 답: 과제 제출물과 프롬프트·대화·검증 실행 기록을 바탕으로 결과물과 판단 근거를 묻고, 지원자의 설명이 실제 구현 및 코드 위치와 일치하는지 대조하는 단계입니다.
Cofa 공식 Probe 소개 페이지에 따르면 평가는 네 단계로 이어집니다. 먼저 실전 환경에서 과제를 시작하고(01), 작업하는 동안 “산출물과 함께 프롬프트, 도구 설정, AI 대화와 검증 실행 기록을 자동 수집합니다”(02). 이어지는 사후 Q&A 단계(03)에서는 지원자가 “자신의 결과물과 판단 근거를 설명합니다. 답변이 실제 구현과 일치하는지 확인합니다.” 마지막으로 평가 리포트·면접 지원 단계(04)로 연결됩니다.
같은 공식 페이지는 리포트 단계에서 “후보자의 설명을 실제 구현과 대조합니다” 그리고 “판단의 근거가 된 코드와 해당 위치를 직접 확인합니다”라고 설명합니다. 또한 자주 묻는 질문 항목을 통해 “도구 사용법뿐 아니라 문제를 정의하고, AI에 일을 맡기고, 결과를 검증·설명하는 역량을 함께 평가합니다”라고 밝히고 있습니다.
머니투데이 김평화 기자의 기사 역시 “과제 종료 후에는 지원자가 결과물과 의사결정 과정을 설명하는 사후 Q&A를 진행하며, 시스템은 이를 종합해 평가 결과와 면접 참고 리포트를 만든다”고 보도했습니다.
기술·의도·인지 중 사후 Q&A는 어느 축과 가장 가깝습니까?
한 줄 답: 세 평가 축 가운데 결과물의 작동 원리와 실패 가능성을 본인 산출물 기준으로 설명할 수 있는지를 보는 인지 관리 축과 가장 가깝습니다.
Cofa 공식 Probe 페이지는 “산출물과 소스코드, 프롬프트와 작업 기록, 사후 Q&A를 함께 확인합니다. 기술·의도·인지의 기준으로 판단하고 그 근거를 리포트에 담습니다”라고 안내합니다. 머니투데이 기사에 따르면 이 솔루션은 7월 30일 펍지성수에서 크래프톤과 CJ올리브영이 공동 개최한 ‘Cofathon: AI Native Battlegrounds’에 적용되었으며, 평가 기준인 기술 관리(Technique), 의도 관리(Intent), 인지 관리(Cognition) 세 축을 통해 “AI에 목표와 제약을 정확하게 전달했는지, AI가 만든 결과를 직접 검증하고 수정했는지, 결과의 작동 원리와 실패 가능성을 설명할 수 있는지를 함께 살펴본다”고 설명합니다.
즉, 세 축 가운데 결과의 작동 원리와 실패 가능성을 설명할 수 있는지를 살피는 축이 바로 인지 관리입니다. 해당 행사의 공개 후기인 브런치 글쓴이 Luka의 「크래프톤 FDE 코파톤 후기」에서도 인지 관리를 “왜 이 구조인지·어떻게 동작하는지·어디서 깨지는지를 본인 산출물 기준으로 설명할 수 있는가?”로 정리하며, 글쓴이에 따르면 그 행사에서 “참가자 전원이 가장 낮았던 축”이었다고 전합니다.
실제로 어떤 질문이 나왔습니까?
한 줄 답: 코파톤 공개 후기 기준으로 특정 부분을 왜 그렇게 구현했는지와 장애가 발생하면 어떻게 대응할 것인지 등을 산출물 기반으로 즉석에서 물었습니다.
브런치 글쓴이 Luka가 작성한 그 행사의 공개 후기(「크래프톤 FDE 코파톤 후기」)에 따르면, 해당 행사에서는 과제를 제출한 뒤 산출물을 보고 즉석에서 생성된 확인 문제에 직접 답변하는 절차가 진행되었습니다.
후기 글쓴이 Luka가 소개한 질문 예시는 “특정 부분을 왜 그렇게 만들었나”, “장애가 발생하면 어떻게 대응하나”와 같은 형태였습니다. 글쓴이는 직접 겪은 소감으로 “조리 있게 설명하기가 참 어렵더군요.”라고 남겼습니다. AI 코딩 도구의 도움을 받아 기능을 빠르게 구현하더라도, 본인 산출물의 세부 구조와 예외 대응 방식을 스스로 소화하지 못하면 즉석에서 논리적으로 답하기 어렵다는 점을 보여 줍니다.
사후 Q&A는 어떻게 대비하면 좋습니까?
한 줄 답: 아래는 제 의견이며, 작업 중 결정 이유를 한 줄로 남기고 약점·위험·다음 검증 순서로 답하며 대체값 표시와 테스트·커밋 기록을 남기는 다섯 가지 습관이 도움이 됩니다.
아래는 제 의견입니다. 평소 과제를 수행할 때 다음 다섯 가지 습관을 들여 두면 사후 Q&A에서 내 구현과 일치하는 설명을 조리 있게 제시하는 데 도움이 됩니다. 작업 중 생기는 부채를 줄이는 배경이 궁금하다면 AI 코딩 에이전트에 일을 맡길 때 생기는 세 가지 부채 글도 함께 참고하시기 바랍니다.
- 단계마다 ‘왜 이렇게 했나’를
DECISIONS.md에 한 줄 기록하기: 구현 단계마다 무엇을 선택했고 왜 그렇게 판단했는지를DECISIONS.md파일에 한 줄씩 적어 둡니다. 과제가 끝난 뒤 기억에 의존하지 않고도 내 의사결정 근거를 바로 떠올릴 수 있습니다. - 약점 → 위험 → 다음 검증 순서로 답하기: 브런치 후기 글쓴이 Luka는 확인 문제의 모범 답안이 “내 코드의 구체적인 약점 지점을 지목하고, 그게 왜 위험한지 파급을 설명하고, 다음에 뭘 검증·개선할지 계획을 제시하는 순서”였다고 관찰했습니다. 한계를 숨기기보다 약점과 파급 위험, 후속 검증 계획을 순서대로 짚는 연습이 유효합니다.
- 대체값·추정값을 실제 결과와 구분해 표시하기(예: 플래그 열): 결측치나 오류를 메우기 위해 넣은 대체값·추정값은 별도의 플래그 열 등으로 실제 정상 결과와 명확히 구분해 표시합니다. 어떤 데이터를 제외하거나 대체했는지 투명하게 드러나므로 설명이 쉬워집니다.
- 검증을 테스트 실행과 커밋 로그로 남기기: Cofa 공식 Probe 페이지에서 밝히듯 평가 과정에서는 “검증 실행 기록”을 자동 수집합니다. 눈으로만 대충 확인하고 넘어가기보다 테스트 실행과 정돈된 커밋 로그로 검증 흔적을 남겨 두면 내 설명을 뒷받침하는 근거가 됩니다.
- 질문의 전제가 내 구현과 다르면 그렇다고 먼저 말하기: 공식 페이지 안내처럼 사후 Q&A는 “답변이 실제 구현과 일치하는지 확인”하고 “후보자의 설명을 실제 구현과 대조합니다.” 만약 질문이 내 실제 코드와 다른 전제를 담고 있다면 질문에 끌려가며 말을 맞추지 말고, 실제로는 어떻게 구현했는지부터 먼저 바로잡아 설명해야 합니다.
답변 예시는 어떤 모습입니까?
한 줄 답: 판단과 근거를 먼저 밝힌 뒤, 내 구현의 한계(약점)와 그로 인한 파급(위험), 이어서 확인·개선할 계획을 순서대로 제시하는 구조입니다.
아래는 제 연습용 예시입니다. 앞서 살펴본 원칙을 적용해 가상의 질문과 답변을 구성하면 다음과 같습니다.
질문(예시): “센서 온도 값 -9999를 왜 그렇게 처리했습니까?”
“-9999는 실제 온도가 아니라 센서가 값을 못 읽었을 때 들어가는 결측 표시로 판단했습니다. 그래서 평균 계산에서는 빼고, 해당 행에는 is_missing 플래그를 붙여 보고서에 몇 행이 빠졌는지 함께 적었습니다. 약점은 -9999가 아닌 다른 이상값(예: 순간적으로 튄 값)은 걸러지지 않는다는 점입니다. 이 값이 평균을 끌어올리면 보고서 결론이 틀어질 수 있습니다. 다음에는 정상 범위를 담당자에게 확인하고, 범위 밖 값에 대한 테스트를 추가하겠습니다.”
이 답변은 먼저 왜 그렇게 처리했는지 판단과 근거(-9999를 결측 표시로 판단해 평균에서 제외하고 is_missing 플래그와 누락 행 수를 기록함)를 밝히고, 이어서 현 구현의 약점(다른 이상값은 걸러지지 않음)과 위험(평균이 왜곡되어 보고서 결론이 틀어질 수 있음), 그리고 다음 검증(정상 범위 확인 및 범위 밖 값 테스트 추가) 순서로 짜여 있습니다.
사후 Q&A 대비의 핵심을 정리하면 무엇입니까?
한 줄 답: 그럴듯한 결과물 자체보다 내가 왜 그렇게 판단하고 검증했는지를 코드와 기록으로 설명할 수 있는지가 핵심입니다.
AI 코딩 도구를 쓰면 돌아가는 결과물은 빠르게 만들 수 있지만, 평가가 확인하는 지점은 후보자가 자기 코드의 선택 이유와 한계를 정확히 알고 있는지입니다. 따라서 완성도 높은 화면이나 코드만 남기는 데 그치지 않고, 작업하는 순간마다 ‘왜 그렇게 했는지’를 설명할 수 있는 기록과 검증 흔적을 함께 남기는 습관이 가장 확실한 대비책입니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 사후 Q&A 중 도구 사용 규칙 확인, 기록 분량 조절, 모르는 질문이 나왔을 때의 대처법을 정리합니다.
사후 Q&A 답변에 AI 코딩 도구를 써도 됩니까?
일반 원칙으로 말씀드리면 평가마다 허용 규칙이 다르므로, 응시하는 평가의 공식 안내를 반드시 확인하고 그 규칙을 따르시기 바랍니다.
기록을 너무 많이 남기면 오히려 손해입니까?
제 의견으로는 긴 줄글 문서를 쓰느라 구현 시간을 뺏기면 손해입니다. DECISIONS.md에는 각 단계에서 무엇을 왜 골랐는지 한 줄 메모만 남겨 두어도 사후 Q&A에서 기억을 되살리기에 충분합니다.
모르는 질문이 나오면 어떻게 합니까?
제 의견으로는 아는 척하며 추측성 답변을 지어내지 않는 것이 좋습니다. 사후 Q&A는 답변을 실제 구현 및 코드와 대조하므로, 아직 확인하지 못한 부분이라면 그 사실을 솔직히 밝히고 어떤 위험이 있을지, 다음에 어떤 방법으로 확인할 것인지를 말씀하시기 바랍니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: AI 코딩 에이전트 협업 시 쌓이는 세 가지 부채와 프롬프트·컨텍스트·하네스 엔지니어링 개념 정리 글을 함께 살펴보시기 바랍니다.
출처는 어디입니까?
한 줄 답: Cofa-Probe 공식 소개 페이지, 머니투데이 기사, 코파톤 참가 공개 후기, SK하이닉스 뉴스룸 공지를 참고했습니다.
- Cofa 공식 Probe 소개 페이지: https://www.getcofa.com/ko/probe (확인 2026-10-27)
- 머니투데이 김평화 기자, 「크래프톤, ‘AI 협업’ 평가 솔루션 ‘Cofa-Probe’ 현장 검증」, 2026-08-28 (확인 2026-10-27)
- Luka, 「크래프톤 FDE 코파톤 후기」, 브런치, 2026-08-02 (확인 2026-10-27)
- SK하이닉스 뉴스룸, 「AI 해커톤 2026」 (확인 2026-10-27)