지금까지 공부한 내용을 글 한 편에 모았습니다. 개념 요약, 자주 틀리는 함정, 문서·데이터를 AI로 다루는 문제의 풀이 순서, 그리고 연습하면서 제가 반복한 실수까지 넣었습니다. 내일 아침에는 이 글과 맨 아래 링크만 보면 되도록 정리했습니다.
목차
- 이 글 사용법 (아침 30~40분)
- 핵심 개념 한 장 요약
- 자주 틀리는 함정 10개 (O/X)
- 문서·데이터 AI 활용 문제 풀이 요약
- 나의 실수 체크리스트
- 마무리와 관련 글
이 글은 어떻게 쓰면 될까요? (아침 30~40분)
| 시간 | 할 일 |
|---|---|
| 0~10분 | 2. 핵심 개념 한 장 요약을 처음부터 끝까지 읽습니다. ★ 표시가 붙은 비교 포인트는 소리 내서 한 번씩 말해 봅니다. |
| 10~15분 | 3. 함정 10개를 풉니다. 정답을 가리고 O/X를 먼저 정한 다음 확인합니다. 틀린 건 2번으로 돌아가서 다시 봅니다. |
| 15~25분 | 시간이 남으면 예상 문제 1편이나 2편에서 틀렸던 주제 문제만 골라 다시 풉니다. 새 문제를 많이 푸는 것보다 헷갈렸던 걸 확실히 하는 게 낫습니다. |
| 25~35분 | 4. AI 활용 문제 풀이 요약을 읽고, 프롬프트 예시의 줄마다 무슨 역할인지 짚어 봅니다. |
| 35~40분 | 5. 나의 실수 체크리스트를 읽습니다. 실제로 문제를 풀 때 이 체크박스를 떠올리면 됩니다. |
💡 아침에 새로운 걸 배우려고 하지 마십시오. 이미 아는 걸 꺼내기 쉽게 정리하는 시간입니다.
핵심 개념을 한 장으로 요약하면 무엇일까요?
주제마다 헷갈리는 비교 포인트만 적었습니다. ★은 특히 자주 헷갈렸던 주제입니다.
① Temperature·Top-p ★
- temperature를 낮추면 분포가 뾰족해져서 1등 토큰에 몰리고, 답이 일정해집니다. 높이면 평평해져서 답이 다양해집니다(엉뚱한 답도 늡니다).
- temperature는 분포의 모양을, top-k와 top-p는 후보의 범위를 정합니다.
- top-k는 후보 수가 고정입니다. top-p는 누적 확률이 p가 될 때까지 남겨서, 분포가 뾰족하면 후보가 적고 평평하면 많습니다.
- 계산 예: 확률 0.50 / 0.30 / 0.10 / 0.06 이고 top-p = 0.85면, 누적이 0.50 → 0.80 → 0.90이라 0.85를 처음 넘는 3번째까지, 3개가 남습니다.
② Prefill·Decode·KV Cache ★
- Prefill은 프롬프트를 한꺼번에 처리해서 **연산이 병목(compute-bound)**입니다.
- Decode는 토큰을 하나씩 만듭니다. 토큰마다 가중치와 앞 토큰의 K·V를 메모리에서 다시 읽어야 해서 **메모리가 병목(memory-bound)**입니다. 그래서 HBM 같은 고대역폭 메모리가 중요합니다.
- KV Cache는 앞 토큰의 K와 V만 저장해서 다시 씁니다. Q는 재사용하지 않고 새 토큰마다 새로 만듭니다.
- 답변이 길어질수록 Decode 단계가 늘어서 응답이 느려집니다. 컨텍스트가 길어지면 KV Cache도 커집니다.
③ 지도·비지도·강화학습 ★
- 라벨이 없고 비슷한 것끼리 묶으면 **군집화(비지도)**입니다.
- 라벨이 있고 숫자를 맞히면 회귀, 범주(예/아니오, 스팸 여부)를 맞히면 분류입니다. 둘 다 지도학습입니다.
- 보상을 받으며 시행착오로 배우면 강화학습입니다(게임, 로봇, RLHF).
- 함정: “비가 올지 예/아니오”는 숫자 같아 보여도 분류입니다.
④ 과적합·데이터 누수 ★
- 과적합은 학습 점수는 높은데 새 데이터 점수가 낮은 것입니다(학습 99%, 새 데이터 60%).
- 학습 손실은 계속 줄어드는데 검증 손실이 다시 오르기 시작하면 과적합 신호입니다. 검증 손실이 가장 낮던 지점에서 멈추는 게 조기 종료입니다.
- 줄이는 법은 데이터 늘리기, 정규화, 조기 종료입니다. 적은 데이터로 모델을 키우고 더 오래 학습하면 오히려 나빠집니다.
- 데이터 누수는 평가 쪽 정보가 학습에 섞여서 평가 점수가 거짓으로 높게 나오는 것입니다. 예: 전체 데이터에 전처리를 먼저 하고 나서 나누기.
⑤ 제로샷·퓨샷·CoT vs 파인튜닝·LoRA ★
- 제로샷, 퓨샷, CoT는 입력만 바꿉니다. 가중치는 그대로입니다. 그래서 새 세션에서 형식을 원하면 예시를 다시 넣어야 합니다.
- 파인튜닝(SFT)은 지시–응답 데이터로 가중치를 추가 학습합니다.
- LoRA는 원래 가중치는 고정하고 작은 어댑터만 학습합니다. “LoRA가 원래 가중치 전체를 바꾼다”는 틀린 말입니다.
- 출력 형식이 들쭉날쭉하면 먼저 퓨샷부터 해 봅니다. 학습은 그다음입니다.
⑥ 환각
- LLM은 사실을 찾아보는 게 아니라 그럴듯한 다음 토큰을 확률로 예측해서 환각이 생깁니다.
- 줄이는 법은 RAG, 검색 도구, 출처 확인과 교차 확인입니다. temperature를 올리는 건 반대 방향입니다.
- “모르면 모른다고 답해”는 도움은 되지만 완벽하지 않습니다. 검증을 같이 해야 합니다.
⑦ Embedding·Vector DB·RAG
- Embedding은 글을 의미 벡터로 바꾸는 것, Vector DB는 그 벡터를 저장하고 찾는 것, LLM은 최종 답을 만드는 것입니다.
- RAG는 문서를 찾아 Context에 넣는 전체 방식입니다. Vector DB는 필수가 아닙니다. 키워드 검색이나 웹 검색으로 찾아도 RAG입니다.
- 넣은 문서가 틀리거나 오래됐으면 RAG를 써도 틀린 답이 나옵니다.
- 원-핫 벡터는 서로 다른 단어끼리 코사인 유사도가 항상 0입니다.
⑧ LLM·Workflow·Agent
- 가르는 기준은 도구를 쓰느냐가 아니라 다음 행동을 누가 정하느냐입니다. 사람이 순서를 정해 두면 Workflow, LLM이 스스로 정하면 Agent입니다.
- “매일 9시에 검색 → 요약 → 메일”은 Workflow입니다.
- Agent 안전장치: 권한은 필요한 만큼만 주고, 삭제·발송처럼 되돌릴 수 없는 행동 전에는 사람 승인을 받습니다.
⑨ Self-Attention (Q·K·V)
- 도서관 비유: Q는 검색어, K는 책 라벨, V는 책 내용입니다.
- 점수는 Q와 K를 비교해서 만들고, 실제로 섞는 건 V입니다.
- 예: Softmax 결과가 B 0.7, C 0.3이면 새 표현은 **0.7·V(B) + 0.3·V(C)**입니다.
⑩ Transformer
- Self-Attention은 토큰끼리 정보를 나누는 회의, FFN은 토큰마다 혼자 가공하는 개인 작업입니다.
- Attention은 모든 토큰을 한꺼번에 봐서 순서를 모릅니다. 그래서 **위치 정보(Positional Encoding)**를 더합니다.
- 처리 순서는 텍스트 → 토큰 → 토큰 ID → 임베딩 벡터입니다.
⑪ 양자화 ★
- 가중치 메모리 = 파라미터 수 × 파라미터당 바이트입니다. FP16은 2바이트, INT8은 1바이트, INT4는 0.5바이트입니다.
- 계산 예: 7B 모델을 INT4로 하면 70억 × 0.5바이트 = 3.5GB입니다. 13B를 FP16에서 INT8로 바꾸면 26GB → 13GB입니다.
- Decode가 memory-bound라서, 읽을 바이트가 줄어드는 양자화의 효과가 큽니다.
- 양자화는 같은 모델의 숫자 정밀도를 낮추는 것이고, 지식 증류는 작은 모델을 새로 학습하는 것입니다.
⑫ 사전학습 → SFT → RLHF
- 순서는 사전학습 → SFT → RLHF입니다.
- 사전학습은 텍스트 자체가 정답이라 자기지도 학습입니다.
- RLHF에서 사람은 정답을 쓰는 게 아니라 여러 답에 순위를 매깁니다. 그걸로 보상 모델을 만들고 강화학습으로 조정합니다.
- DPO는 보상 모델과 강화학습 단계 없이 선호 데이터로 바로 학습합니다.
⑬ 토큰·컨텍스트 윈도우
- 토큰 수는 글자 수나 단어 수와 같지 않습니다. 같은 뜻이라도 언어에 따라 다릅니다.
- 추론 모델의 보이지 않는 추론 토큰도 출력 사용량에 들어갑니다.
- 컨텍스트 윈도우를 넘으면 줄이거나, 나누거나, 요약해서 보냅니다.
⑭ MoE ★
- 라우터가 토큰마다 일부 전문가만 고릅니다. 연산은 일부 전문가만 합니다.
- 그래도 메모리에는 모든 전문가의 가중치를 올려 둬야 합니다. 연산은 줄어도 메모리는 줄지 않습니다.
- 토큰이 한 전문가에 몰리지 않게 load balancing 보조 손실을 둡니다.
- Sparse 모델은 오히려 과적합에 더 취약한 편입니다.
⑮ 프롬프트·컨텍스트 엔지니어링, 시스템 프롬프트
- 범위는 프롬프트 ⊂ 컨텍스트 ⊂ 하네스 순서로 넓어집니다.
- 컨텍스트 엔지니어링은 모델이 보는 정보 전체를 고르는 일입니다. 예: 파일 전체를 매번 붙이지 않고, 경로만 들고 있다가 필요할 때 읽게 하기.
- 시스템 프롬프트는 세션 내내 유지되고, 길수록 대화에 쓸 자리가 줍니다.
- 긴 세션에서 앞의 규칙을 잊기 시작하면, 결정 사항만 요약해서 새 세션으로 옮깁니다.
⑯ 재현율·정밀도 ★ (보충)
- 재현율 = 잡은 진짜 양성 ÷ 전체 진짜 양성. “놓치면 안 될 때”(질병 선별, 불량 검출) 봅니다.
- 정밀도 = 잡은 진짜 양성 ÷ 내가 양성이라고 한 전체. 헛경보를 줄이고 싶을 때 봅니다.
- 계산 예: 실제 불량 100개 중 80개를 잡고 정상품 40개를 불량으로 잘못 판정했다면, 재현율 = 80 ÷ 100 = 0.80, 정밀도 = 80 ÷ 120 ≈ 0.67입니다.
- 불량 10개, 정상 990개에서 전부 “정상”이라고 하면 정확도는 99%지만 **재현율은 0%**입니다.
⑰ 지식 증류 (보충)
- 큰 모델(선생님)의 출력을 작은 모델(학생)이 따라 배우게 해서 작고 빠른 모델을 만듭니다.
- 양자화와 함께 경량화 방법이지만, 증류는 모델을 새로 학습한다는 점이 다릅니다.
⑱ 4D: AI와 일하는 네 가지 역량 (보충)
- 위임(Delegation): 무엇을 AI에게 맡기고 무엇을 내가 할지 정합니다.
- 설명(Description): 목표, 맥락, 형식을 분명하게 전달합니다.
- 분별(Discernment): AI 결과를 그대로 믿지 않고 검증합니다.
- 책임(Diligence): 결과에 책임지고, 윤리와 투명성을 지킵니다.
자주 틀리는 함정 10개, O/X로 맞힐 수 있을까요?
정답을 손으로 가리고 먼저 O/X를 정해 보십시오.
1. 매번 같은 답을 받고 싶으면 temperature를 올린다.
정답 보기
→ X. 낮춰야 1등 토큰에 몰려서 답이 일정해집니다. 올리면 다양해집니다.
2. top-p는 언제나 같은 개수의 후보를 남긴다.
정답 보기
→ X. 그건 top-k입니다. top-p는 분포 모양에 따라 후보 수가 바뀝니다.
3. Decode 단계는 연산이 병목이라 GPU 코어를 늘리면 가장 빨라진다.
정답 보기
→ X. Decode는 memory-bound입니다. 메모리 대역폭이 가장 직접적으로 도움이 됩니다. 연산 병목은 Prefill입니다.
4. KV Cache는 앞 토큰의 Q, K, V를 모두 저장해서 다시 쓴다.
정답 보기
→ X. K와 V만 저장합니다. Q는 새 토큰마다 새로 만듭니다.
5. 라벨 없는 고객 데이터를 비슷한 그룹으로 묶는 건 지도학습 회귀다.
정답 보기
→ X. 비지도학습 군집화입니다. 회귀는 라벨이 있고 숫자를 예측할 때입니다.
6. 퓨샷 예시를 한 번 넣으면 모델이 그 형식을 학습해서 다음 세션에서도 따른다.
정답 보기
→ X. 퓨샷은 입력만 바꿉니다. 가중치는 그대로라 다음에도 예시를 다시 넣어야 합니다.
7. RAG를 하려면 반드시 Vector DB가 있어야 한다.
정답 보기
→ X. 키워드 검색이나 웹 검색으로 찾아 Context에 넣어도 RAG입니다.
8. 도구를 쓰면 Agent, 안 쓰면 Workflow다.
정답 보기
→ X. 기준은 다음 행동을 누가 정하느냐입니다. Workflow도 도구를 씁니다.
9. MoE는 토큰마다 일부 전문가만 계산하니까, 쓰지 않는 전문가는 메모리에 안 올려도 된다.
정답 보기
→ X. 연산은 일부만 하지만, 어떤 전문가가 뽑힐지 모르니 전부 메모리에 올려 둬야 합니다.
10. 7B 모델을 INT4로 양자화하면 가중치 메모리는 약 3.5GB다.
정답 보기
→ O. 70억 × 0.5바이트 = 3.5GB입니다. (FP16은 14GB, INT8은 7GB)
문서·데이터 AI 활용 문제는 어떻게 풀까요?
규정 문서와 데이터 파일 여러 개를 AI에게 주고 판정·건수·금액을 구하는 문제의 풀이법입니다. 자세한 버전은 전략 글에 있습니다.
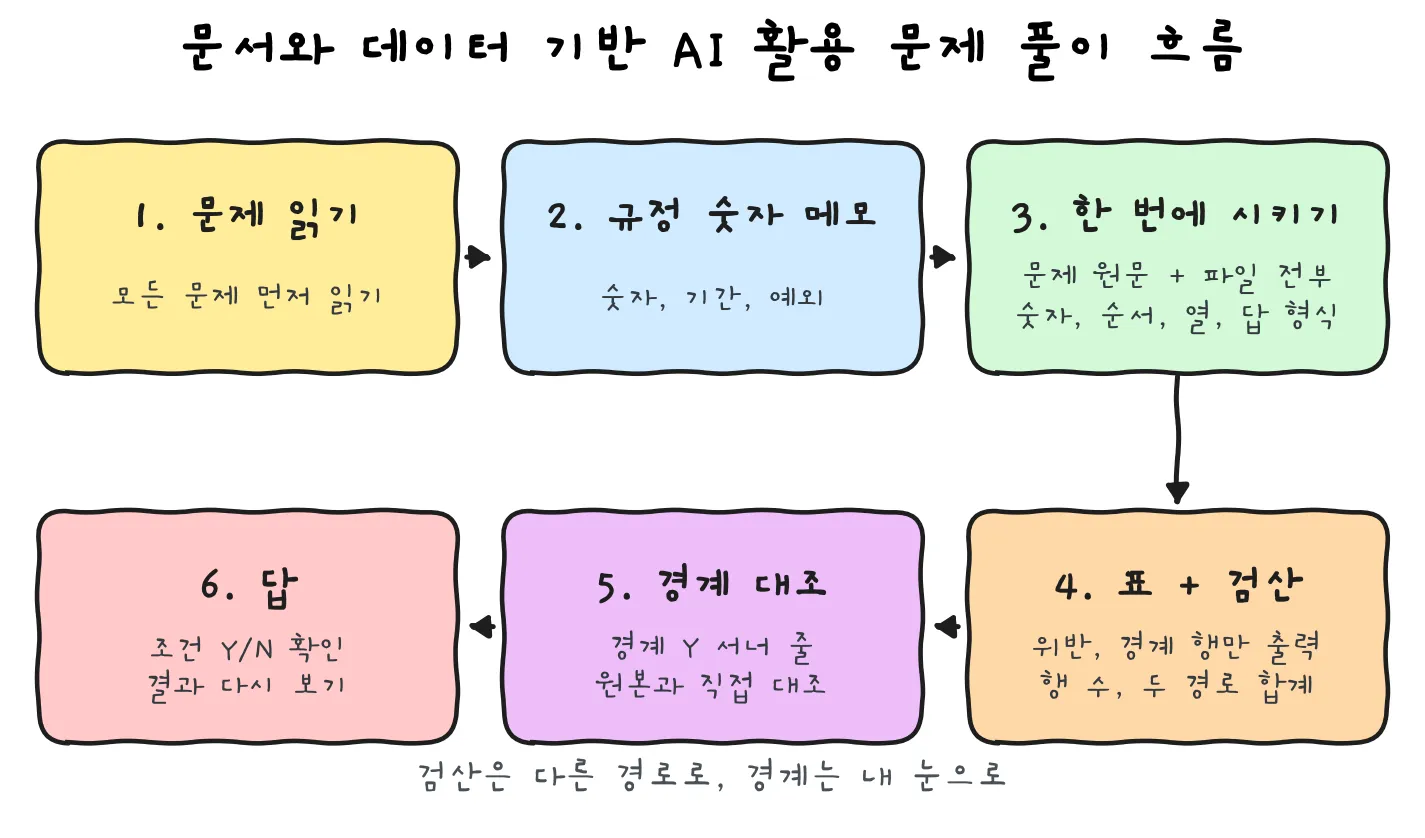
접근 순서
- 모든 문제를 먼저 읽습니다. 어떤 문제가 어떤 파일을 쓰는지, 겹치는 계산이 뭔지 봅니다.
- 규정의 숫자, 기간, 예외만 메모합니다. 한도, 기준 시간, 적용 기간, 제외 대상입니다.
- 한 번에 시키는 프롬프트를 씁니다. 같은 파일로 같은 판정을 하는 문제는 묶습니다.
- 표와 검산을 받습니다.
- 경계 행을 원본과 대조합니다.
- 조건을 다시 확인하고 답을 적습니다.
한 턴 프롬프트 공식
문제 원문 그대로 → 필요한 파일 전부 첨부 → 규정 숫자와 경계 기준
→ 처리 순서 → 표 열 → 검산 → 마지막 줄 답 형식- 문제 원문은 요약하지 말고 그대로 붙입니다. “제외”, “초과”, “이상”, “단,” 한 마디가 답을 바꿉니다.
- 필요한 파일은 처음부터 전부 붙입니다.
- 규정 숫자는 프롬프트에 직접 씁니다. “한도와 같은 값은 위반 아님”처럼 경계 기준도 마찬가지입니다.
- 말투는 ‘~해’로 시킵니다. “표가 필요하다”(메모 말투) 대신 “아래 열로 표를 만들어”(시키는 말투).
| 메모 말투 (X) | 시키는 말투 (O) |
|---|---|
| 규정으로 판정해야한다 | 첨부한 규정으로 행마다 위반 여부를 판정해. |
| 표로 정리가 필요하다 | 아래 열로 표를 만들어. |
| 필요한 데이터가 있으면 요청해 | (넣지 않기. 필요한 건 내가 이미 압니다.) |
출력 줄이기
- AI에게는 모든 행을 판정하게 합니다.
- 표로는 위반 행과 경계 행만 받고, 나머지는 건수만 받습니다.
- 출력이 길수록 긴 표 중간에서 한 줄을 잘못 읽는 실수가 늡니다.
검산 4가지
| 검산 | 프롬프트에 넣을 문장 |
|---|---|
| 행 수 | “원본 행 수 = 제외 행 + 남은 행인지 확인해.” |
| 행마다 계산식 열 | “각 행에 실근로 = 퇴근 − 출근 − 휴게 식을 그대로 적어.” |
| 두 경로 합계 | “날짜별 합계와 직원별 합계를 따로 구해서 같은지 확인해.” |
| 조건 Y/N | “문제의 모든 조건을 다시 나열하고 답이 각각 맞는지 Y/N으로 표시해.” |
⚠️ 같은 숫자를 다시 더하는 건 검산이 아닙니다. 이미 틀린 값을 다시 더하면 당연히 “일치합니다”가 나옵니다. 진짜 검산은 원본 파일을 다시 붙이고 다른 경로로 다시 계산하는 것입니다.
경계 사례 체크리스트
- ☐ 기준값과 정확히 같은 값 (‘초과’인지 ‘이상’인지)
- ☐ 기간의 첫날과 마지막 날
- ☐ 자정을 넘긴 시간
- ☐ 중복 입력
- ☐ 정정·취소된 건
- ☐ 예외 대상 (제외 직군, 특수 근무 형태)
- ☐ 발효일 당일에 새 기준을 쓰는지 옛 기준을 쓰는지
- ☐ 휴일 근무의 휴게 시간 처리
표에 경계 Y/N 열을 두게 하고, 경계 Y인 줄 서너 개는 원본에서 직접 눈으로 대조합니다.
짧은 프롬프트 예시 (가상의 출장비 규정)
[규정.pdf, 직원마스터.xlsx, 출장내역.csv 첨부]
출장내역 40건을 전수 검사해서 아래 세 문제에 답해.
(문제 원문 그대로 붙여 넣기)
위반 기준: ① 일비 > 100,000 ② 숙박비 > 80,000 ③ 토·일이면서 사전승인=N. 한도와 같은 값은 위반 아님.
위반 금액: ①② 한도 초과분, ③ 전액.
순서: 사번으로 부서 매칭 → 건별 판정 → 표.
표는 위반 행과 경계 행만: |사번|부서|요일|일비|숙박비|사전승인|위반①②③|위반금액 계산식|경계Y/N|
나머지는 건수만 적어.
검산: 위반 + 비위반 = 40, 부서별 위반 합 = 전체 위반 건수, 조건별 Y/N 재확인.
마지막 줄: 문제1=N건 / 문제2=N원 / 문제3=부서명
짧게 써도 공식의 모든 단계가 다 들어갑니다.
내가 반복한 실수는 무엇이었을까요?
연습하면서 실제로 여러 번 했던 실수입니다. 문제를 풀 때 이 순서대로 떠올립니다.
보내기 전
- ☐ 문제 조건을 요약하지 않고 원문 그대로 붙였나? (요약하다가 제외 조건을 빠뜨린 적 있음)
- ☐ 필요한 파일을 전부 첨부했나? (파일 하나를 빠뜨리거나 0개로 보낸 적 있음)
- ☐ 문장이 ‘~해’, ‘~만들어’, ‘~계산해’로 끝나나? (‘~해야한다’ 메모 말투 금지)
- ☐ 규정 숫자와 경계 기준을 프롬프트에 직접 썼나?
- ☐ 검산을 구체적으로 썼나? (행 수, 계산식 열, 두 경로 합계, 조건 Y/N)
- ☐ ‘필요한 데이터가 있으면 요청해’ 같은 설계 질문을 뺐나?
- ☐ 마지막 줄 답 형식을 넣었나?
마무리 전
- ☐ 경계 행을 원본과 직접 대조했나? 특히 발효일 당일, 정정이 반영 안 된 건, 휴일 근무의 휴게 시간.
- ☐ AI가 ‘확인 불가’라고 한 답을 그대로 쓰지 않았나?
- ☐ 조건별 Y/N을 다시 봤나?
- ☐ 최종 결과를 다시 확인했나? 계산이 맞아도 옮겨 적다가 틀어지면 소용없습니다.
4D로 보면 제일 약한 건 분별(Discernment)
연습을 4D로 돌아보면 위임과 설명은 점점 좋아졌는데, 분별이 가장 약했습니다. AI가 “검산 결과 일치합니다”라고 하면 그대로 믿었기 때문입니다. 앞으로는 이렇게 합니다.
- 원본 파일을 다시 첨부합니다. 앞에서 만든 표만 보고 확인하면 그 표의 오류까지 따라갑니다.
- 다른 경로로 다시 계산합니다. 금액이 큰 2~3건을 골라 처음부터 다시 계산하게 하고, 이전 값과 다른 줄만 보여 달라고 합니다.
- AI 답 안에 조건과 어긋나는 단서(예: 제외 대상인 사람이 합계에 들어감)가 있는지 내 눈으로 봅니다.
마무리와 함께 볼 관련 글은 무엇일까요?
개념은 비교 포인트로, 문제는 원문 그대로, 판정은 전부, 출력은 위반·경계만, 검산은 다른 경로로, 경계는 내 눈으로.
관련 글