레이어 정규화(LayerNorm)와 배치 정규화(BatchNorm)는 모두 깊은 신경망을 학습할 때 층마다 흔들리는 값의 분포를 정리해 학습을 안정시키는 정규화 기법입니다. 두 기법의 핵심 차이는 평균과 분산을 계산할 때 미니배치 안의 여러 샘플을 묶는지, 아니면 샘플 하나 안의 특성들을 묶는지에 있으며, 이 차이가 트랜스포머에서 LayerNorm을 사용하는 이유로 이어집니다.
핵심 요약
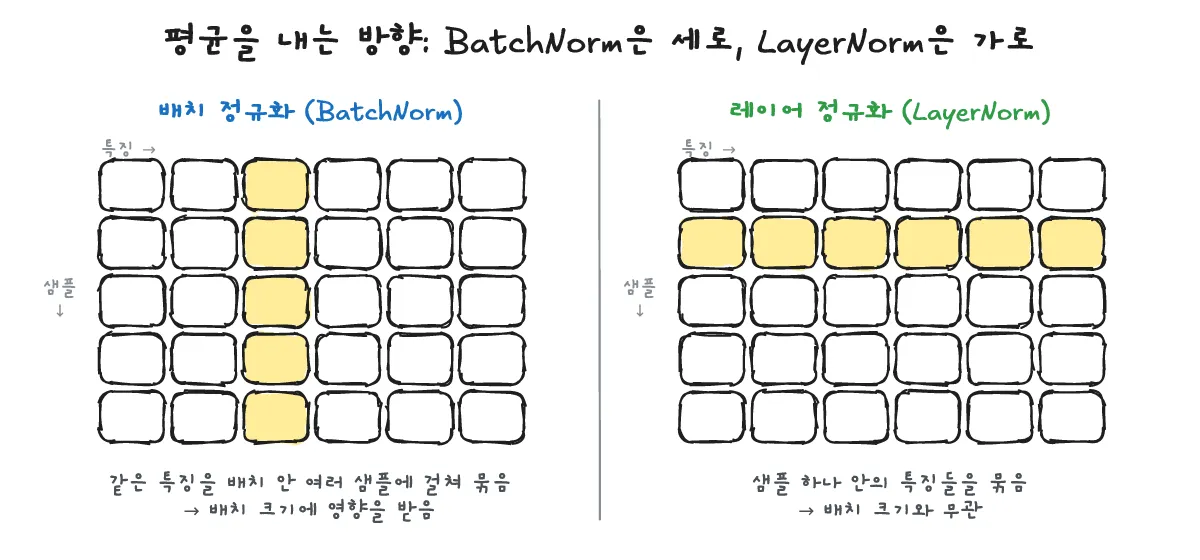
배치 정규화와 레이어 정규화는 모두 값의 평균을 0, 분산을 1 근처로 맞춰 학습을 안정시키는 방법이지만 평균을 내는 방향이 다릅니다. 배치 정규화는 같은 특성을 미니배치 안의 여러 샘플에 걸쳐 묶고, 레이어 정규화는 샘플 하나 안의 모든 특성을 묶습니다. 따라서 레이어 정규화는 미니배치 크기나 문장 길이에 의존하지 않고 학습과 추론에서 완전히 같은 계산을 수행하므로 트랜스포머에서 주로 사용합니다.
레이어 정규화와 배치 정규화 같은 정규화는 왜 합니까?
한 줄 답: 신경망의 층을 지날수록 값의 분포가 흔들려 학습이 불안정해지는 현상을 줄이기 위해, 값을 평균 0과 분산 1 기준으로 맞춘 뒤 학습 가능한 스케일(γ)과 시프트(β)를 적용합니다.
깊은 신경망에서는 앞선 층의 가중치가 갱신될 때마다 다음 층으로 전달되는 입력 값의 분포가 계속 바뀝니다. 층을 거듭할수록 값의 크기가 지나치게 커지거나 작아지면 학습이 불안정해지기 쉽습니다.
정규화(normalization)는 각 층에서 값의 평균과 분산을 구해 평균 0, 분산 1을 목표로 맞춘 다음, 신경망이 표현력을 잃지 않도록 학습 가능한 스케일(scale, γ)과 시프트(shift, β) 파라미터를 적용하는 과정입니다. 이때 평균과 분산을 어느 축을 따라 묶어서 계산하느냐에 따라 배치 정규화(BatchNorm)와 레이어 정규화(LayerNorm)로 나뉩니다.
배치 정규화는 무엇을 묶습니까?
한 줄 답: 샘플을 행, 특성(feature)을 열로 놓은 표에서 배치 정규화(BatchNorm)는 세로 방향인 한 열을 택해 미니배치 안의 여러 샘플에 걸쳐 같은 특성의 평균과 분산을 구합니다.
Ioffe와 Szegedy의 배치 정규화 논문에서는 미니배치에 들어 있는 샘플들을 기준으로 각 특성마다 평균과 분산을 계산해 정규화한 뒤, 학습 가능한 스케일(γ)과 시프트(β)를 적용합니다. 행이 개별 샘플이고 열이 각 특성인 격자를 떠올리면, 배치 정규화는 세로 기둥 하나(같은 열에 속한 미니배치 전체 샘플의 값)를 묶어서 통계를 내는 방식입니다.
배치 정규화에는 미니배치 단위로 통계를 낸다는 특성 때문에 두 가지 중요한 성질이 따릅니다.
- 추론 시 이동 평균 사용: 추론 단계에서는 미니배치 자체의 통계를 그때그때 다시 구하지 않고, 학습 중에 모아 둔 모집단 통계인 이동 평균(moving averages)을 고정해 사용합니다.
- 미니배치 크기에 따른 영향: 미니배치 안에서 평균과 분산을 구하므로, 미니배치가 작아지면 배치 통계가 흔들려(noisy) 학습 안정성이 떨어질 수 있습니다.
레이어 정규화는 무엇을 묶습니까?
한 줄 답: 레이어 정규화(LayerNorm)는 가로 방향인 한 행을 택해 단일 샘플 하나가 가진 모든 특성의 평균과 분산을 구하므로 미니배치 크기에 의존하지 않습니다.
Ba, Kiros, Hinton의 레이어 정규화 논문에서는 다른 샘플을 참조하지 않고 단일 학습 사례(샘플 하나) 안에 들어 있는 모든 특성(합산된 입력들)에 걸쳐 평균과 분산을 계산한 뒤 학습 가능한 스케일(γ)과 시프트(β)를 적용합니다. 행이 샘플이고 열이 특성인 격자에서 가로 줄 하나를 통째로 묶어 정규화하는 방식입니다.
샘플 하나 안에서 계산이 끝나므로 미니배치 크기에 전혀 의존하지 않으며, 학습할 때와 추론할 때 완전히 동일한 계산을 수행합니다. 이러한 특성 덕분에 순환 신경망이나 시퀀스 모델에 적용하기 쉽습니다.
| 구분 | 배치 정규화 (BatchNorm) | 레이어 정규화 (LayerNorm) |
|---|---|---|
| 묶는 방향 (행=샘플, 열=특성) | 세로 열 하나 (미니배치에 걸친 동일 특성) | 가로 행 하나 (단일 샘플 내 모든 특성) |
| 미니배치 크기 의존성 | 의존함 (배치가 작으면 통계가 흔들림) | 의존하지 않음 |
| 학습과 추론의 계산 방식 | 추론 시 학습 중 모은 이동 평균 사용 | 학습과 추론에서 완전히 동일한 계산 수행 |
트랜스포머는 왜 LayerNorm을 씁니까?
한 줄 답: 입력 문장마다 길이가 다르고 추론 시 토큰을 하나씩 생성하는 트랜스포머 특성상, 각 토큰의 특성 벡터를 그 자체로 정규화하는 LayerNorm을 써야 배치 크기나 시퀀스 길이에 관계없이 동일한 계산을 적용할 수 있기 때문입니다.
자연어 처리나 시퀀스 모델링에서는 미니배치에 담긴 문장들의 길이가 서로 다르고, 추론할 때는 토큰을 한 번에 하나씩 차례대로 생성합니다. LayerNorm은 각 토큰의 특성 벡터를 독립적으로 정규화하므로, 미니배치 크기가 달라지거나 시퀀스 길이가 가변적인 상황에서도 학습과 추론 모두 똑같은 계산을 그대로 적용할 수 있습니다.
트랜스포머 블록 안에서 잔차 연결(residual connection)과 LayerNorm이 어텐션 및 피드포워드 층과 결합되는 전체 구조는 「Transformer 구조 쉽게 정리: Self-Attention·FFN·위치 정보」 글에서 확인할 수 있습니다.
한편 트랜스포머 계열 구조에서 자주 언급되는 정규화 배치 방식과 변형 용어는 다음과 같습니다.
Pre-LN과Post-LN: 잔차 블록 내부에서LayerNorm을 서브레이어(sublayer) 앞에 두는지(Pre-LN) 아니면 뒤에 두는지(Post-LN)에 따른 구분입니다.RMSNorm: 평균을 빼는 과정을 생략하고 제곱평균제곱근(root mean square)만으로 정규화하도록 단순화한 변형 기법입니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 합성곱 신경망(CNN)에서의 BatchNorm 사용 여부, 정규화와 과적합의 관계, 활성화 함수와의 배치 순서를 정리합니다.
CNN은 여전히 BatchNorm을 씁니까?
그렇습니다. 이미지 처리를 다루는 많은 합성곱 신경망(CNN)에서는 여전히 배치 정규화(BatchNorm)가 널리 사용됩니다.
정규화가 과적합을 막아 줍니까?
정규화(normalization)의 직접적인 목적은 과적합 방지가 아니라 학습 안정성 확보이며, 과적합의 원인과 해결 방법은 과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법 글에서 다룹니다.
활성화 함수와는 어떤 순서로 둡니까?
정규화 층을 활성화 함수 앞에 둘지 뒤에 둘지는 신경망 아키텍처 설계에 따라 달라지며, 각 활성화 함수의 특징은 활성화 함수란? ReLU·GELU·시그모이드 차이와 고를 때 글에서 다룹니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 트랜스포머 블록 구조, 과적합, 역전파, 활성화 함수, 옵티마이저를 다룬 관련 글입니다.
- 「Transformer 구조 쉽게 정리: Self-Attention·FFN·위치 정보」
- 과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법
- 역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리
- 활성화 함수란? ReLU·GELU·시그모이드 차이와 고를 때
- 옵티마이저란? SGD·모멘텀·Adam 차이와 처음 고를 때
출처는 어디입니까?
한 줄 답: 배치 정규화와 레이어 정규화를 제안한 원 논문 두 편을 참고했습니다.