핵심 요약
과적합은 모델이 학습 데이터에 지나치게 맞춰져 새로운 데이터에서는 제대로 예측하지 못하는 상태입니다. 학습 손실은 계속 내려가는데 검증 손실이 오르기 시작하면 과적합을 의심해야 합니다. 해결은 조기 종료, 데이터 늘리기, 정규화와 드롭아웃, 모델 크기 줄이기 순서로 시도해 볼 수 있습니다.
학습을 돌리다 보면 손실 그래프의 두 선이 서로 벌어지는 순간을 만나게 됩니다. 학습 손실은 계속 좋아지는데 검증 손실은 어느 지점부터 오르는 현상이 바로 과적합(overfitting)입니다. 이 글에서는 손실 곡선을 읽는 법, 진단하는 법, 그리고 해결하는 순서를 차례로 정리합니다.
과적합이란 무엇입니까?
한 줄 답: 과적합은 모델이 학습 세트에 지나치게 가깝게 맞춰져서 새로운 데이터를 제대로 예측하지 못하는 상태입니다.
과적합은 문제의 원리를 이해하지 않고 정답만 외우는 것에 비유할 수 있습니다. 외운 문제는 잘 맞히지만 조금만 다른 문제가 나오면 틀립니다. 반대로 원리를 이해한 모델은 처음 보는 데이터에서도 잘 동작하며, 이를 일반화(generalization)라고 부릅니다. 일반화는 새로운 데이터에서 좋은 성능을 내는 능력입니다. 편향–분산 관점에서는 과적합을 분산이 큰 쪽으로 치우친 상태로 봅니다.
손실 곡선은 어떻게 읽습니까?
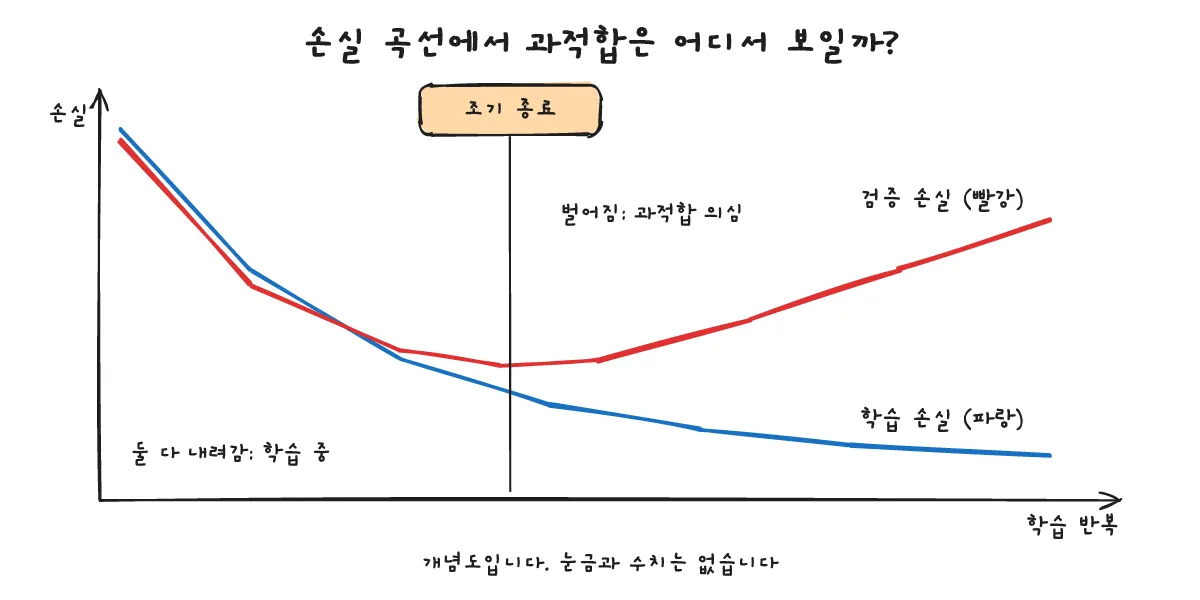
한 줄 답: 처음에는 학습 손실과 검증 손실이 함께 내려가다가, 학습 손실은 계속 내려가는데 검증 손실이 위로 꺾이는 지점부터 과적합이 시작됩니다.
손실 곡선(loss curve)은 학습 반복에 따라 손실이 어떻게 변하는지 그린 그래프입니다. 보통 다음과 같은 단계로 나누어 읽습니다.
- 두 손실이 함께 내려가는 구간: 모델이 데이터의 일반적인 패턴을 배우는 중입니다.
- 두 손실의 간격이 벌어지는 구간: 학습 손실만 더 빠르게 내려가며, 모델이 학습 데이터에만 맞추기 시작합니다.
- 검증 손실이 오르는 지점: 학습 손실은 계속 내려가는데 검증 손실이 상승합니다. 이 지점 근처가 조기 종료를 고려할 자리입니다.
과적합인지 어떻게 진단합니까?
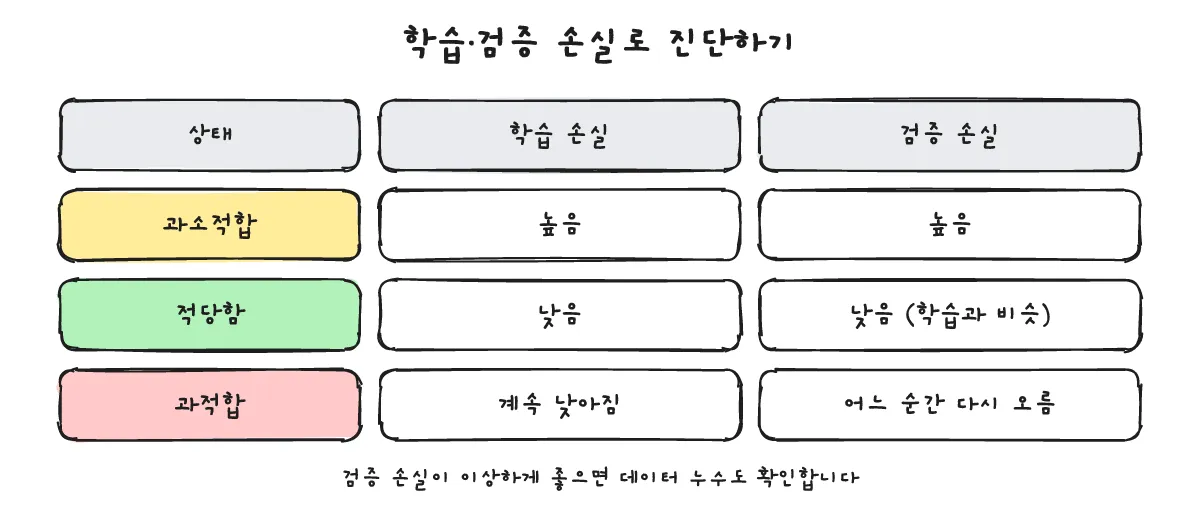
한 줄 답: 학습 손실과 검증 손실을 비교하십시오. 학습 손실은 낮은데 둘의 간격이 크면 과적합이고, 둘 다 높으면 과소적합입니다.
먼저 학습 손실과 검증 손실의 간격을 확인합니다. 학습 손실은 낮은데 검증 손실이 그보다 훨씬 높다면 과적합입니다. 반대로 두 손실이 모두 높다면 모델이 아직 패턴을 충분히 배우지 못한 과소적합이므로, 처방이 달라집니다. 검증 결과가 지나치게 좋아 보일 때는 데이터 누수도 함께 점검해야 합니다. 누수로 얻은 좋은 결과는 일반화가 아닙니다.
- 검증 데이터가 학습 데이터에 섞여 들어가지 않았는지 확인합니다.
- 분할된 세트 사이에 중복된 데이터가 없는지 확인합니다.
- 정답을 그대로 드러내는 특성(feature)이 입력에 들어 있지 않은지 확인합니다.
과적합은 어떻게 해결합니까?
한 줄 답: 조기 종료, 데이터 늘리기와 증강, L2 정규화와 드롭아웃, 모델 크기 줄이기 순서로 먼저 해볼 것부터 시도하십시오.
조기 종료
조기 종료(early stopping)는 검증 손실이 더 이상 좋아지지 않는 지점 또는 그 근처에서 학습을 멈추는 방법입니다. 설정을 거의 바꾸지 않고 시도할 수 있어 가장 먼저 해볼 만합니다.
데이터 늘리기와 증강
더 많고 더 다양한 데이터는 모델이 우연한 패턴에 맞춰지는 것을 줄여 줍니다. 데이터를 더 모으기 어렵다면 데이터 증강(data augmentation)도 고려할 수 있습니다. 기존 데이터를 변형해 학습 데이터를 늘리는, 널리 쓰이는 방법입니다.
L2 정규화와 드롭아웃
정규화(regularization)는 모델의 복잡도에 벌점을 주는 방법이며, L2 정규화가 대표적입니다. 드롭아웃(dropout)도 널리 쓰이는 방법으로, 학습 중에 일부 유닛을 무작위로 빼고 학습합니다.
모델 크기 줄이기
매개변수가 더 적은 단순한 모델이 오히려 더 잘 일반화하는 경우가 있습니다. 앞의 방법으로 충분하지 않을 때 모델 크기를 줄여 보십시오.
자주 묻는 질문은 무엇입니까?
한 줄 답: 아래 질문에 원리 중심으로 답합니다.
과적합은 항상 나쁩니까?
과적합은 모델이 새로운 데이터에서 실패한다는 신호이므로 해결해야 할 문제입니다. 다만 학습 손실과 검증 손실 사이에 약간의 간격이 있는 것은 자연스러운 현상이며, 그 자체가 과적합은 아닙니다.
검증 세트는 얼마나 떼야 합니까?
정해진 비율보다 원칙이 중요합니다. 검증 세트는 학습에 절대 사용하지 않아야 하고, 실제 데이터와 비슷해야 하며, 점수가 안정적으로 나올 만큼 충분히 커야 합니다. 최종 확인용으로는 별도의 테스트 세트를 따로 보관하십시오.
파인튜닝에서도 과적합이 생깁니까?
그렇습니다. 적은 데이터로 파인튜닝하면 과적합이 생길 수 있습니다. 사전학습과 파인튜닝의 차이는 사전학습·파인튜닝·RLHF 정리 글에서 볼 수 있습니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 기초 개념과 모델 구조를 함께 보면 이해가 쉽습니다.
출처는 어디입니까?
한 줄 답: 이 글의 내용은 Google 머신러닝 단기집중과정을 바탕으로 합니다.
- Google Machine Learning Crash Course, “Overfitting” (확인일: 2026-10-23)