옵티마이저(optimizer)는 신경망 학습에서 계산된 기울기를 사용해 각 가중치를 실제로 어떻게 갱신할지 결정하는 규칙입니다. 손실에서 기울기를 구하더라도 그 기울기를 그대로 쓸지, 이전 이동 방향을 더할지, 파라미터마다 보폭을 다르게 줄지에 따라 학습 경로가 달라지며, 이 글에서는 경사 하강법 계열인 SGD, 모멘텀, Adam, AdamW의 차이와 처음 고를 때의 기준을 정리합니다.
핵심 요약
옵티마이저는 역전파로 구한 기울기를 보고 가중치를 어느 방향으로 얼마나 움직일지 정하는 규칙입니다. SGD는 기울기 반대 방향으로 같은 보폭만큼 움직이고, 모멘텀은 이전 이동 방향을 관성처럼 더해 지그재그를 줄이며, Adam은 파라미터마다 기울기 크기 이력을 보고 보폭을 따로 조절합니다. 처음에는 Adam이나 AdamW로 시작하는 경우가 많고, 어떤 옵티마이저를 고르든 학습률은 따로 정해야 합니다.
옵티마이저란 무엇입니까?
한 줄 답: 옵티마이저는 역전파로 계산한 각 가중치의 기울기를 받아 가중치를 갱신할 방향과 보폭을 결정하는 알고리즘입니다.
신경망 학습에서는 기울기를 구하는 단계와 가중치를 실제로 바꾸는 단계가 분리되어 있습니다. 역전파가 모든 가중치에 대한 손실의 기울기를 계산하면(역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리 참고), 옵티마이저는 그 기울기들을 어떻게 활용해 가중치를 이동시킬지(이동 방향과 보폭)를 결정합니다.
SGD는 어떻게 움직입니까?
한 줄 답: 확률적 경사 하강법(SGD)은 미니배치에서 구한 기울기의 반대 방향으로 모든 가중치를 동일한 보폭 비율(학습률)만큼 이동시킵니다.
SGD는 현재 미니배치에서 계산된 기울기만을 보고, 기울기가 가리키는 방향의 정반대 쪽으로 이동합니다. 이때 모든 가중치에 같은 학습률이 보폭 기준으로 적용됩니다.
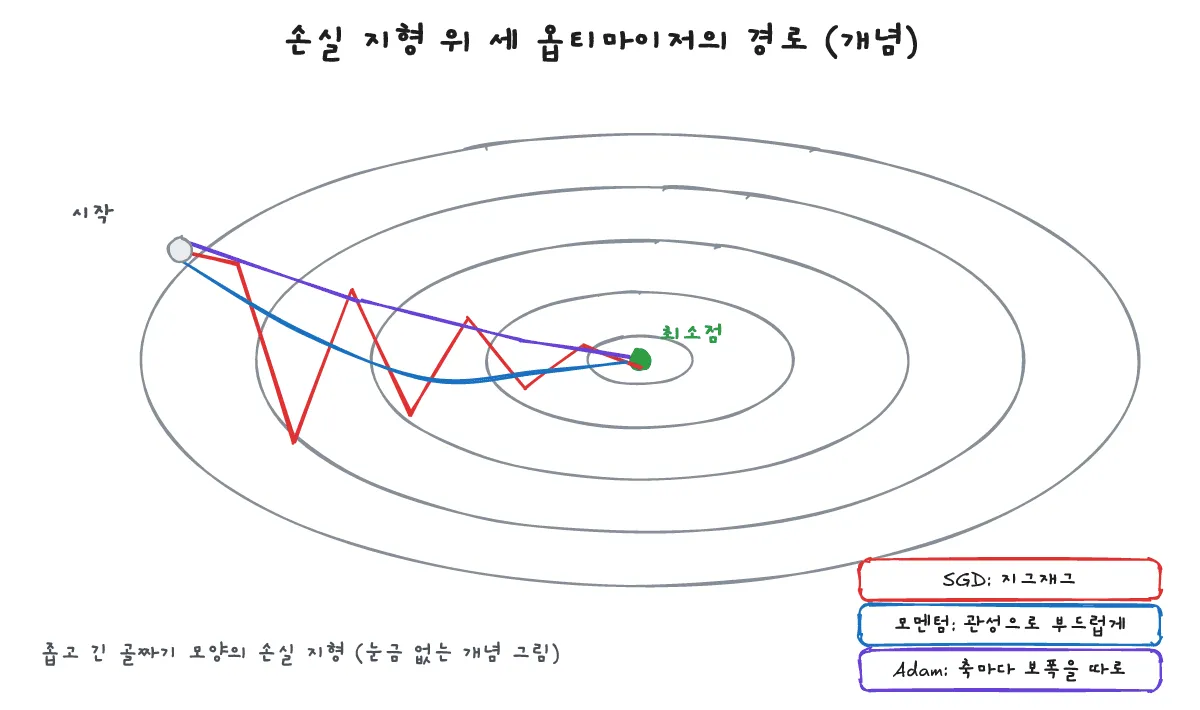
손실 지형이 길고 좁은 골짜기 모양일 때 SGD는 완만한 골짜기 바닥 방향보다 가파른 양쪽 벽면 방향의 기울기가 훨씬 크게 나타나므로, 양쪽 벽 사이를 지그재그로 오가면서 정작 골짜기 바닥을 따라서는 느리게 전진하는 경향이 있습니다.
모멘텀은 무엇을 더합니까?
한 줄 답: 모멘텀은 이전 단계들에서 움직이던 방향을 관성처럼 유지해 더해 줌으로써 지그재그 진동을 상쇄하고 일관된 방향의 이동 속도를 높입니다.
모멘텀(momentum)은 언덕 아래로 굴러가는 공이 관성을 받는 것에 비유할 수 있습니다. 현재 단계의 기울기만 쓰는 대신 이전 단계들에서 누적된 이동 방향을 계속 유지하면서 현재 기울기에 더합니다.
이렇게 하면 좁은 골짜기에서 양쪽 벽을 오가며 방향이 매번 바뀌는 지그재그 성분은 서로 상쇄되어 줄어들고, 골짜기 바닥을 따라 꾸준히 같은 방향을 가리키는 성분은 계속 더해져 더 빠르게 나아갑니다. PyTorch의 torch.optim에서는 별도 클래스가 아니라 SGD 옵티마이저가 momentum 인자를 받는 형태로 제공됩니다.
Adam은 무엇이 다릅니까?
한 줄 답: Adam은 각 파라미터마다 기울기의 이동 평균과 기울기 제곱의 이동 평균을 따로 유지해 파라미터별로 보폭을 개별 조절합니다.
Kingma와 Ba의 논문에서 제안된 Adam은 파라미터마다 두 가지 이동 평균을 함께 추적합니다. 하나는 기울기 자체의 이동 평균(모멘텀에 해당하는 방향 정보)이고, 다른 하나는 기울기 제곱의 이동 평균(기울기 크기가 얼마나 크게 흔들렸는지를 나타내는 정보)입니다. Adam은 이 두 값을 조합해 파라미터마다 보폭을 따로 맞추므로, 기울기가 자주 크게 변하는 가중치와 완만하게 변하는 가중치가 서로 다른 보폭으로 갱신됩니다.
한편 PyTorch의 torch.optim에서 Adam과 AdamW는 서로 별개의 옵티마이저 클래스로 구분되어 있으며, 공식 문서(Decoupled Weight Decay Regularization 논문 기반)에 따르면 AdamW는 가중치 감쇠(weight decay)가 모멘텀이나 분산(기울기 제곱 이동 평균)에 누적되지 않도록 분리한 알고리즘입니다.
처음에는 무엇을 고릅니까?
한 줄 답: 처음에는 Adam이나 AdamW를 기본 출발점으로 삼는 경우가 많으며, 모델 종류에 따라 모멘텀을 켠 SGD도 널리 쓰입니다.
모든 상황에 항상 최고인 단일 옵티마이저는 없지만, 각 규칙의 특징과 자주 쓰이는 출발점은 아래 표와 같이 정리할 수 있습니다.
| 옵티마이저 | 핵심 특징 | 자주 쓰는 상황 |
|---|---|---|
| SGD + 모멘텀 | 현재 기울기에 이전 이동 방향(관성)을 더하며 모든 파라미터에 같은 방식의 보폭 기준을 적용합니다. 구조가 단순합니다. | 여러 비전 모델을 비롯해 단순하고 검증된 갱신 규칙이 잘 맞는 학습에서 널리 쓰입니다. |
| Adam | 파라미터별 기울기 이동 평균과 기울기 제곱 이동 평균을 이용해 각 가중치의 보폭을 따로 조절합니다. | 처음 실험을 시작할 때 기본 출발점으로 자주 선택됩니다. |
| AdamW | Adam의 파라미터별 보폭 조절 방식을 유지하면서 가중치 감쇠가 모멘텀이나 분산에 누적되지 않게 분리합니다. | 트랜스포머 계열 모델을 포함해 처음 학습을 구성할 때 기본 출발점으로 널리 쓰입니다. |
어떤 옵티마이저를 선택하더라도 전체 보폭의 기준이 되는 학습률은 사용자가 직접 정해야 합니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 옵티마이저를 골라도 학습률은 따로 정해야 하며, 과적합 방지나 손실 함수 정의는 옵티마이저의 역할이 아닙니다.
옵티마이저를 고르면 학습률은 안 정해도 됩니까?
정해야 합니다. Adam이나 AdamW처럼 파라미터마다 보폭을 조절하는 옵티마이저를 쓰더라도 기준이 되는 학습률은 여전히 직접 설정해야 하며, 자세한 내용은 「학습률(Learning Rate)이란? 손실이 튀거나 줄지 않을 때 조정하는 방법」 글에서 다룹니다.
옵티마이저가 과적합을 막아 줍니까?
막아 주지 않습니다. 옵티마이저는 훈련 손실을 줄이도록 가중치를 갱신하는 규칙일 뿐이며, 훈련 손실은 내려가는데 검증 손실이 오르는 과적합 문제를 다루는 방법은 과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법 글에서 확인할 수 있습니다.
손실 함수와는 무엇이 다릅니까?
손실 함수는 모델이 줄여야 할 목표(오차의 기준)를 정의하는 것이고, 옵티마이저는 그 손실을 줄이기 위해 가중치를 어떻게 이동시킬지를 결정하는 규칙입니다. 분류 문제에서 쓰는 대표적인 손실 함수는 「교차 엔트로피(Cross-Entropy) 손실이란? 분류 모델이 MSE 대신 쓰는 이유」 글에서 다룹니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 역전파의 기울기 계산 원리, 과적합 해결 방법, 전체 모델 학습 단계를 다룬 관련 글입니다.
- 역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리
- 과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법
- 사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?
출처는 어디입니까?
한 줄 답: PyTorch 공식 문서와 Adam 원 논문을 기준으로 확인했습니다.
- PyTorch Documentation — torch.optim (확인 2026-10-28)
- PyTorch Documentation — torch.optim.AdamW (확인 2026-10-28)
- Diederik P. Kingma, Jimmy Ba — Adam: A Method for Stochastic Optimization (확인 2026-10-28)