교차 엔트로피(cross-entropy loss)는 분류 모델이 정답 클래스에 얼마나 높은 확률을 부여했는지를 평가하는 대표적인 손실 함수(로그 손실)입니다. 이 글에서는 정답 확률에 따른 손실 값의 변화와 softmax 연결 구조, 그리고 분류 문제에서 평균제곱오차(MSE)와의 차이 및 교차 엔트로피를 쓰는 이유를 정리합니다.
핵심 요약
교차 엔트로피 손실은 모델이 정답 클래스에 부여한 확률이 낮을수록 큰 벌점을 주는 손실 함수로, 정답 확률 p에 대해 -log(p)를 계산합니다. 정답 확률이 1에 가까우면 손실이 0에 수렴하고, 0에 가까워질수록 손실이 급격히 커집니다. 분류 모델에서 평균제곱오차(MSE) 대신 쓰는 이유는 softmax 확률 출력과 결합했을 때 틀린 답을 강하게 확신하는 상황에서 기울기가 크게 나와 학습이 빠르게 진행되기 때문입니다.
교차 엔트로피 손실이란 무엇입니까?
한 줄 답: 모델이 정답 클래스에 부여한 확률 p에 자연로그를 취해 부호를 바꾼 값(-log(p))으로, 정답 확률이 낮을수록 벌점이 가파르게 커지는 손실 함수입니다.
단일 샘플에 대해 모델이 정답 클래스(예: 고양이·개·새 중 정답인 고양이)에 부여한 확률을 p라고 할 때, 교차 엔트로피 손실은 자연로그 기준 -log(p)로 정의됩니다. 정답 확률 p가 1에 가까워질수록 손실은 0으로 수렴하고, 반대로 p가 0에 가까워질수록 손실은 한계 없이 커집니다.
Python의 math.log(자연로그, 소수점 셋째 자리 반올림)로 계산한 정답 확률별 손실 값은 다음과 같습니다. 예를 들어 정답 확률이 0.9이면 손실은 약 0.105이지만, 정답 확률이 0.01로 떨어지면 손실은 약 4.605가 됩니다.
정답 클래스 확률 (p) | 교차 엔트로피 손실 (-log(p)) |
|---|---|
0.9 | 0.105 |
0.5 | 0.693 |
0.1 | 2.303 |
0.01 | 4.605 |
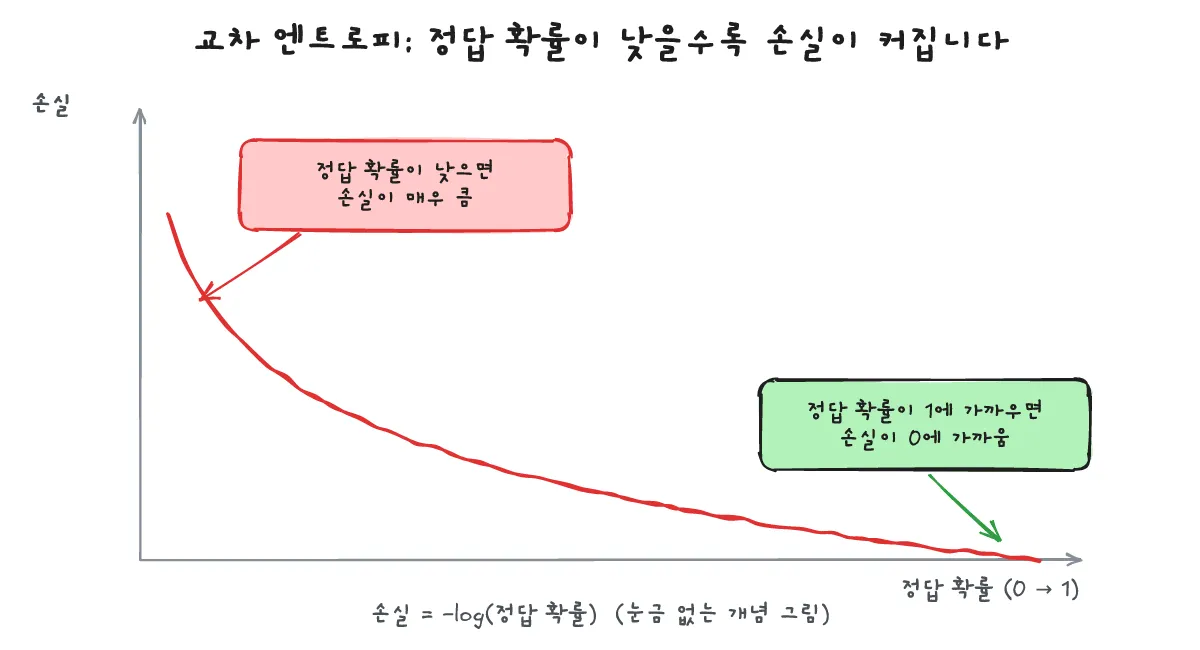
정보이론 관점에서 이 개념은 실제 정답 분포와 모델이 예측한 확률 분포 사이의 차이를 재는 엔트로피 및 쿨백-라이블러 발산(KL divergence)에서 유래했으며, 머신러닝에서는 로그 손실(log loss)이라고도 부릅니다. 정답 클래스만 확률이 1이고 나머지는 0인 원-핫(one-hot) 정답에서는 식이 -log(p)로 단순해집니다.
softmax와는 어떻게 연결됩니까?
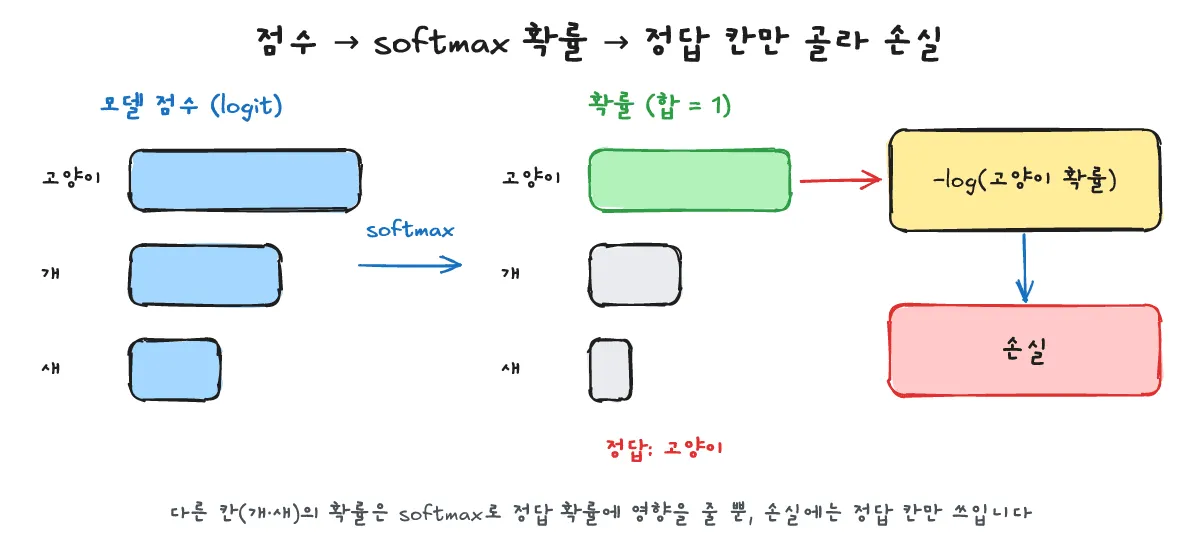
한 줄 답: 모델이 출력한 원시 점수(logit)를 softmax로 합이 1인 확률 분포로 바꾼 뒤, 정답 클래스 칸의 확률만 골라 -log(p)를 계산합니다.
고양이·개·새를 구분하는 분류 모델이라면 손실 계산 파이프라인은 다음과 같은 순서로 이어집니다.
- 모델의 마지막 층이 각 클래스(고양이·개·새)에 대한 정규화되지 않은 원시 점수(logit)를 출력합니다.
softmax함수가 이 점수들을 모두 양수이면서 합이 1이 되는 확률 분포로 변환합니다.- 전체 클래스 확률 가운데 정답 클래스(예: 고양이)의 확률
p만 골라내어-log(p)를 취하면 최종 손실이 됩니다.
softmax가 점수를 비중(확률)으로 바꾸는 원리는 「Self-Attention이란? Q·K·V로 토큰 비중 매기는 법」 글에서 함께 확인할 수 있으며, 신경망 내부 층에서 비선형성을 주는 함수들과의 비교는 「활성화 함수란? ReLU·GELU·시그모이드 차이와 고를 때」 글에서 다룹니다.
실무에서 PyTorch의 torch.nn.CrossEntropyLoss를 쓸 때는 모델 출력에 softmax를 직접 적용하지 않고 원시 점수(logits)를 그대로 넣어야 합니다. PyTorch 공식 문서에 따르면 이 손실 함수는 입력으로 정규화되지 않은 각 클래스의 점수(양수이거나 합이 1일 필요가 없는 logits)를 받으며, 클래스 인덱스 정답과 함께 사용할 때 내부적으로 LogSoftmax와 NLLLoss를 차례로 적용하는 것과 동일하게 동작합니다.
분류에서 MSE 대신 쓰는 이유는 무엇입니까?
한 줄 답: 모델이 틀린 답을 강하게 확신할 때 교차 엔트로피는 큰 손실과 큰 기울기를 만들어 가중치를 빠르게 고치지만, MSE는 확률 출력이 포화되면 기울기가 작아져 학습이 느려지기 때문입니다.
분류 모델의 출력이 softmax 확률일 때 평균제곱오차(MSE)와 교차 엔트로피의 차이를 비교하면 학습 속도에서 뚜렷한 대비가 나타납니다.
- 교차 엔트로피: 모델이 틀린 답을 확신하여 정답 확률
p가 0에 가까워지면 손실이 제한 없이 커지고 기울기(gradient)도 크게 유지됩니다. 따라서 크게 틀린 예측일수록 가중치를 강하게 수정하여 학습이 빠르게 진행됩니다. - 평균제곱오차(MSE): 확률 값에 대한 벌점이 제한되어 있을 뿐 아니라,
softmax출력이 양끝으로 포화(saturated)되면 기울기가 작아질 수 있습니다. 이 때문에 모델이 틀린 답을 강하게 확신하는 상태에서도 기울기가 작아 가중치 수정이 느려집니다.
계산된 손실의 기울기를 따라 신경망의 가중치를 갱신하는 과정은 「역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리」 글에서 자세히 볼 수 있으며, 기울기를 반영하는 보폭을 조절하는 방법은 「학습률(Learning Rate)이란? 손실이 튀거나 줄지 않을 때 조정하는 방법」 글의 주제입니다. 반면 연속적인 실수 값을 직접 예측하는 회귀(regression) 문제에서는 여전히 MSE가 자연스러운 선택입니다.
LLM 학습에서는 어떻게 쓰입니까?
한 줄 답: 대규모 언어 모델의 다음 토큰 예측은 어휘집 전체에서 정답 토큰을 고르는 다중 클래스 분류이므로, 사전학습 단계에서 매 토큰마다 교차 엔트로피 손실을 사용합니다.
대규모 언어 모델(LLM)이 문장의 다음 토큰을 예측하는 과제는 고양이·개·새 중 정답을 고르는 문제를 모델의 어휘집(vocabulary) 전체로 확장한 다중 클래스 분류와 같습니다. 모델은 매 위치에서 어휘집의 모든 토큰에 대한 점수(logits)를 출력하고, 실제 정답인 다음 토큰의 확률에 대해 교차 엔트로피 손실을 계산하여 학습합니다.
이러한 다음 토큰 예측이 전체 학습 파이프라인에서 차지하는 위치는 「사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?」 글에서 확인할 수 있습니다. 또한 언어 모델 평가 지표로 자주 언급되는 퍼플렉시티(perplexity)는 평균 교차 엔트로피 손실에 지수 함수를 취한 값으로 정의됩니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 이진 분류에서의 손실 함수 선택, 손실이 0에 수렴할 때의 과적합 위험, 그리고 라벨 스무딩의 역할을 정리합니다.
이진 분류에서는 무엇을 씁니까?
참·거짓처럼 두 클래스를 구분하는 이진 분류에서는 이진 교차 엔트로피(binary cross-entropy, BCE) 손실을 사용합니다.
손실이 0이 되면 좋은 것입니까?
반드시 좋은 것은 아닙니다. 학습 데이터에 대한 손실만 0에 가까워지면 모델이 학습 데이터를 외워 버려 새로운 데이터에서 성능이 떨어지는 과적합이 발생할 수 있으며, 자세한 원인과 해결책은 「과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법」 글에서 다룹니다.
라벨 스무딩은 무엇입니까?
라벨 스무딩(label smoothing)은 정답 분포를 균등 분포(uniform distribution)와 섞어 모델이 과도하게 확신하지 않도록 완화하는 기법으로, PyTorch의 torch.nn.CrossEntropyLoss에도 label_smoothing 파라미터가 제공됩니다. 일반적인 소프트 라벨 활용은 「지식 증류(Knowledge Distillation)란? 큰 모델로 작은 모델을 학습시킬 때 양자화와 차이」 글의 주제입니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 역전파, 과적합, Self-Attention, LLM 학습 단계 및 관련 기초 개념을 다룬 글입니다.
- 「역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리」
- 「과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법」
- 「Self-Attention이란? Q·K·V로 토큰 비중 매기는 법」
- 「사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?」
- 「학습률(Learning Rate)이란? 손실이 튀거나 줄지 않을 때 조정하는 방법」
- 「지식 증류(Knowledge Distillation)란? 큰 모델로 작은 모델을 학습시킬 때 양자화와 차이」
- 「활성화 함수란? ReLU·GELU·시그모이드 차이와 고를 때」
출처는 어디입니까?
한 줄 답: 본문 작성에 참고한 PyTorch 공식 문서와 머신러닝 기초 자료입니다.
- PyTorch Documentation — torch.nn.CrossEntropyLoss (확인 2026-10-28)
- Google Machine Learning Crash Course (확인 2026-10-28)