핵심 요약
학습률은 경사 하강법에서 기울기 방향으로 가중치를 한 번에 얼마나 옮길지 정하는 값입니다. 너무 크면 손실이 튀거나 발산하고, 너무 작으면 손실이 아주 느리게 줄어듭니다. 그래서 적당한 값에서 시작해, 학습이 진행되면 학습률을 줄여 가는 스케줄러를 함께 쓰는 경우가 많습니다.
학습률(learning rate)은 경사 하강법으로 신경망을 학습할 때 손실(loss)이 위아래로 튀거나 거의 줄지 않는 현상을 이해하고 조정하는 데 핵심이 되는 하이퍼파라미터입니다. 이 글에서는 학습률의 정의와 가중치 갱신 식, 학습률 크기에 따른 손실 곡선 변화, 값을 고르는 방법, 그리고 학습률 스케줄러와 워밍업(warmup)을 차례대로 정리합니다.
학습률이란 무엇입니까?
한 줄 답: 학습률(learning rate)은 경사 하강법에서 가중치를 갱신할 때 기울기 방향으로 한 걸음에 얼마나 이동할지 비율을 정하는 하이퍼파라미터입니다.
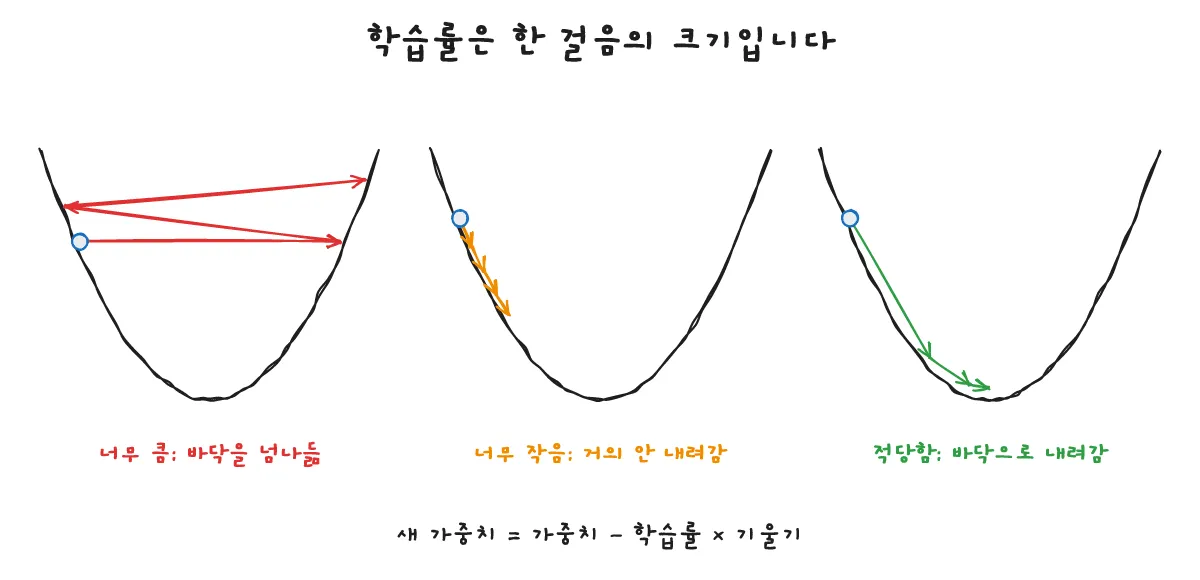
경사 하강법에서 가중치 갱신 규칙은 일반적으로 w ← w − lr × gradient(가중치 ← 가중치 − 학습률 × 기울기) 형태로 나타냅니다. 여기서 lr(학습률)은 한 걸음에 가중치를 얼마나 멀리 옮길지 결정하는 비율입니다.
PyTorch의 torch.optim 문서에 따르면, 옵티마이저는 학습률을 lr 인자로 지정합니다. 예를 들어 문서의 예제처럼 optim.SGD(model.parameters(), lr=..., momentum=...) 형태로 생성할 때나 torch.optim.Adam을 사용할 때 모두 lr 인자로 지정합니다. 이때 갱신 식에 쓰이는 기울기(gradient) 자체는 역전파를 통해 구하며, 자세한 내용은 「역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리」에서 다룹니다.
이를 안개 낀 언덕을 걸어 내려가는 상황에 비유할 수 있습니다. 기울기(gradient)가 어느 쪽이 내리막길인지를 알려준다면, 학습률(learning rate)은 그 방향으로 내딛는 보폭의 크기를 정하는 값입니다.
학습률이 너무 크거나 작으면 어떻게 됩니까?
한 줄 답: 학습률이 너무 크면 바닥을 지나쳐 손실이 위아래로 튀거나 발산하고, 너무 작으면 손실이 아주 느리게 줄어들어 학습이 멈춘 것처럼 보입니다.
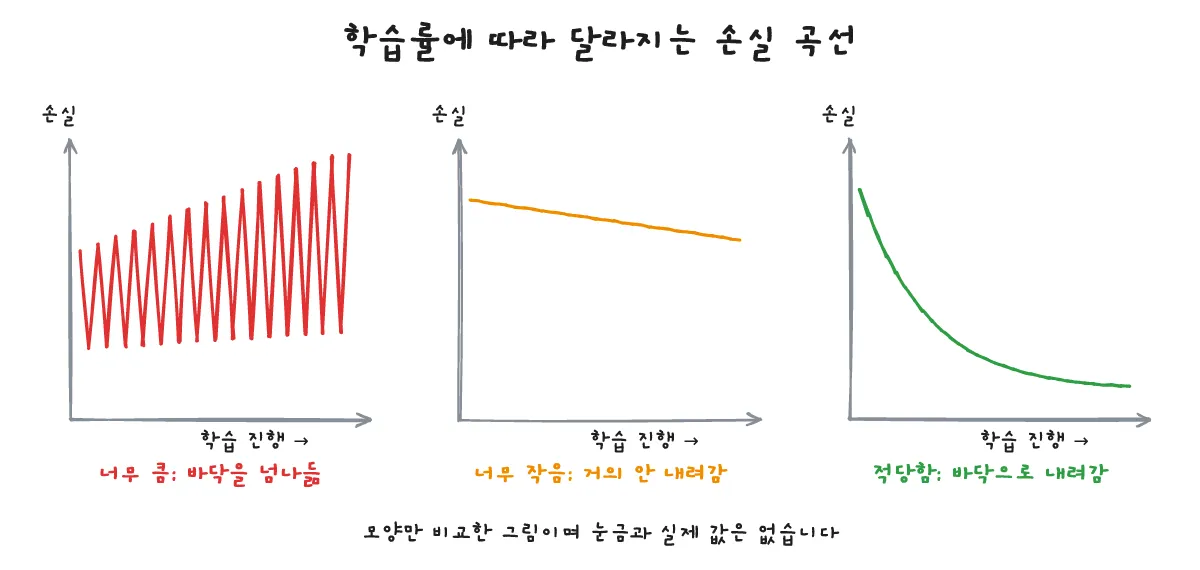
학습률 크기에 따라 학습 중 손실(loss)이 변하는 양상은 다음과 같은 경우들로 나뉩니다.
- 학습률이 너무 큰 경우: 한 걸음이 너무 커서 골짜기 바닥(최저점)을 훌쩍 지나쳐 버립니다. 그 결과 손실이 위아래로 요동치며 튀거나 오히려 점점 커지면서 발산(diverge)합니다.
- 학습률이 너무 작은 경우: 한 번 갱신할 때 가중치가 아주 조금씩만 이동합니다. 손실이 매우 느리게 감소하거나, 마치 학습이 멈춰 제자리에 머무는 것처럼 보입니다.
- 학습률이 적당한 경우: 손실이 불안정하게 튀지 않고 꾸준히 감소합니다.
학습률은 어떻게 고릅니까?
한 줄 답: 모든 경우에 통하는 단일 정답 값은 없으므로, 짧은 실험으로 몇 가지 후보 값을 시도해 손실 곡선을 비교하며 한 번에 하나씩 조정합니다.
학습률에는 모든 모델과 데이터에 그대로 들어맞는 단 하나의 정답 값이 없습니다. 따라서 처음부터 긴 학습을 돌리기보다, 짧은 실험을 통해 몇 가지 후보 값을 시도해 보고 각각의 손실 곡선이 어떻게 움직이는지 비교하는 방식을 씁니다.
조정할 때는 원인을 구분할 수 있도록 한 번에 한 가지 요소만 바꿉니다. 손실 곡선이 위아래로 튀거나 발산하면 학습률을 더 작은 값으로 낮추어 시도하고, 손실이 거의 움직이지 않고 제자리에 머문다면 학습률을 더 큰 값으로 높여 시도합니다.
학습률 스케줄러와 워밍업은 무엇입니까?
한 줄 답: 학습률 스케줄러는 학습이 진행됨에 따라 학습률을 조정하는 방법이며, 워밍업은 처음 구간에서 작은 학습률로 시작해 목표값까지 서서히 올리는 방식입니다.
PyTorch 공식 문서의 학습률 조정(How to adjust learning rate) 항목에 따르면, torch.optim.lr_scheduler는 에포크 진행에 따라 학습률을 조정하는 여러 방법을 제공합니다. 문서에 수록된 스케줄러 클래스로는 StepLR, CosineAnnealingLR, LinearLR, SequentialLR 등이 있으며, ReduceLROnPlateau는 검증 측정값(validation measurements)을 바탕으로 학습률을 동적으로 줄여 줍니다.
워밍업(warmup)은 학습 초기 단계에서 목표 학습률보다 더 작은 값으로 시작해 목표 학습률까지 점진적으로 올리는 개념입니다. 예를 들어 문서에 있는 LinearLR이나 여러 단계를 이어 붙이는 SequentialLR 같은 스케줄러를 조합해 이러한 일정을 구성할 수 있습니다.
PyTorch 문서는 학습률 스케줄링을 옵티마이저의 가중치 갱신 뒤에 적용해야 한다고 안내합니다. 즉 다음과 같이 optimizer.step()을 호출한 뒤에 scheduler.step()을 호출합니다.
optimizer.step()
scheduler.step()
자주 묻는 질문은 무엇입니까?
한 줄 답: 배치 크기와의 관계, Adam 옵티마이저에서의 학습률 지정 여부, 파인튜닝 시의 학습률 선택을 정리했습니다.
배치 크기와 학습률은 관계가 있습니까?
그렇습니다. 두 요소는 서로 영향을 줍니다. 배치 크기를 바꾸면 매 단계에서 추정하는 기울기의 흔들림(잡음) 정도가 달라지므로, 배치 크기를 변경했다면 학습률도 다시 점검하는 것이 좋습니다.
Adam을 쓰면 학습률을 안 정해도 됩니까?
아닙니다. torch.optim.Adam은 파라미터별 이동 크기를 적응적으로 조정하지만, 여전히 전체 기준이 되는 lr 인자를 받으므로 학습률을 지정해야 합니다.
파인튜닝할 때도 같은 학습률을 씁니까?
일반적으로 사전학습(pretraining) 때와는 별도로 설정하며, 모델이 이미 학습해 둔 표현이 크게 망가지지 않도록 흔히 더 작은 학습률을 선택합니다. 사전학습과 파인튜닝 단계의 차이는 사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?에서 다룹니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 언어 모델의 학습 단계 구분과 AI 기초 개념 정리 글을 함께 참고하실 수 있습니다.
- 사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?
- AI 기초 개념 공부 정리 글
- 「역전파(Backpropagation)란? 신경망이 기울기로 가중치를 고칠 때 동작 원리」
- 「과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법」
출처는 어디입니까?
한 줄 답: 옵티마이저의 학습률 인자와 스케줄러 동작을 설명한 PyTorch 공식 문서를 참고했습니다.
- PyTorch Documentation,
torch.optim, https://docs.pytorch.org/docs/stable/optim.html (확인 2026-10-25) - PyTorch Documentation,
torch.optim.Adam, https://docs.pytorch.org/docs/stable/generated/torch.optim.Adam.html (확인 2026-10-25)