**지식 증류(Knowledge Distillation)**는 크고 무거운 모델이나 여러 모델을 묶은 앙상블을 수많은 사용자에게 직접 배포하기가 너무 비쌀 때, 그 지식을 배포하기 쉬운 단일 소형 모델로 옮겨 담는 기법입니다.
핵심 요약
지식 증류는 크고 잘 학습된 교사 모델의 출력(각 답에 매긴 확률 분포)을 정답처럼 써서, 더 작은 학생 모델을 학습시키는 방법입니다. 정답 하나만 배우는 것보다 “이 답과 저 답이 얼마나 비슷한지”까지 배울 수 있다는 것이 핵심입니다. 양자화가 같은 모델의 숫자 정밀도를 낮추는 것이라면, 증류는 더 작은 다른 모델을 새로 학습시키는 것입니다.
지식 증류란 무엇입니까?
한 줄 답: 크고 무거운 교사 모델(또는 앙상블)이 산출한 클래스 확률 분포를 목표 삼아, 배포하기 쉬운 작은 학생 모델을 학습시키는 방법입니다.
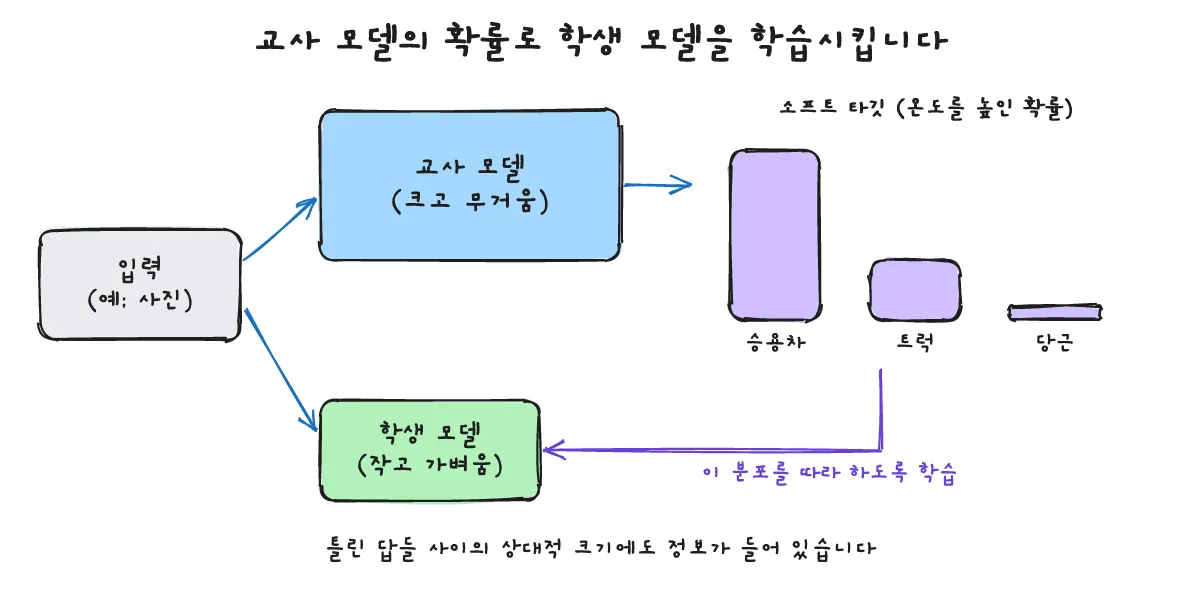
매우 큰 모델이나 여러 모델의 앙상블은 학습 단계에서는 유리하지만, 많은 사용자에게 실제로 서비스하기에는 연산 비용이 지나치게 클 수 있습니다. 지식 증류(knowledge distillation)는 이렇게 무거운 모델(교사 모델, teacher)이 가진 지식을 배포하기에 적합한 하나의 작은 모델(학생 모델, student)로 전달합니다. 이때 학생 모델은 기존 학습 데이터셋이나 별도의 전이용 데이터셋(transfer set) 위에서 교사 모델이 만들어 낸 클래스 확률 분포를 ‘소프트 타깃(soft targets)‘으로 삼아 학습합니다.
왜 정답 라벨 대신 소프트 타깃을 씁니까?
한 줄 답: 소프트 타깃에는 오답들에 부여된 상대적 확률까지 들어 있어, 정답 하나만 알려주는 하드 라벨보다 교사 모델이 일반화하는 방식을 훨씬 풍부하게 전달하기 때문입니다.
학습이 완료된 교사 모델은 정답뿐만 아니라 모든 오답에도 작은 확률을 부여하며, 이 오답 확률들의 상대적인 크기는 모델이 어떻게 일반화하는지를 보여줍니다. 예를 들어 논문이 드는 예처럼 승용차 사진을 분류할 때, 이를 쓰레기 수거 트럭으로 착각할 확률은 매우 작더라도 당근으로 착각할 확률보다는 훨씬 높습니다. 이처럼 엔트로피가 높은 소프트 타깃은 정답 하나만 1로 표시하는 하드 라벨(one-hot)보다 학습 사례 하나당 훨씬 많은 정보를 담아 학생 모델에 전달합니다.
오답들의 미세한 확률 차이를 더 잘 드러내기 위해 최종 소프트맥스(softmax)의 온도(temperature)를 높여 교사 모델이 충분히 부드러운 확률 분포를 내놓게 합니다. 학생 모델을 학습시킬 때도 이 소프트 타깃에 맞추기 위해 똑같이 높은 온도를 적용하며, 학습이 끝난 뒤 실제 추론을 할 때는 학생 모델의 온도를 다시 1(일반 소프트맥스)로 돌려놓습니다.
만약 데이터에 실제 정답 라벨이 있다면, 높은 온도에서 소프트 타깃과 맞추는 교차 엔트로피와 기본 온도(1)에서 실제 정답 라벨과 맞추는 교차 엔트로피를 가중 평균해 두 목표를 함께 학습시키는 편이 더 잘 작동합니다.
참고로 증류에서의 온도와 생성 시 샘플링 온도는 모두 소프트맥스 전에 로짓(logit)을 나누는 값이지만, 증류 온도는 학습 시 타깃 분포를 부드럽게 만드는 조절값이고 샘플링 온도는 생성 시 무작위성을 조절하는 값이라는 점이 다릅니다(「Temperature와 Top-p란?」 참고).
양자화와는 무엇이 다릅니까?
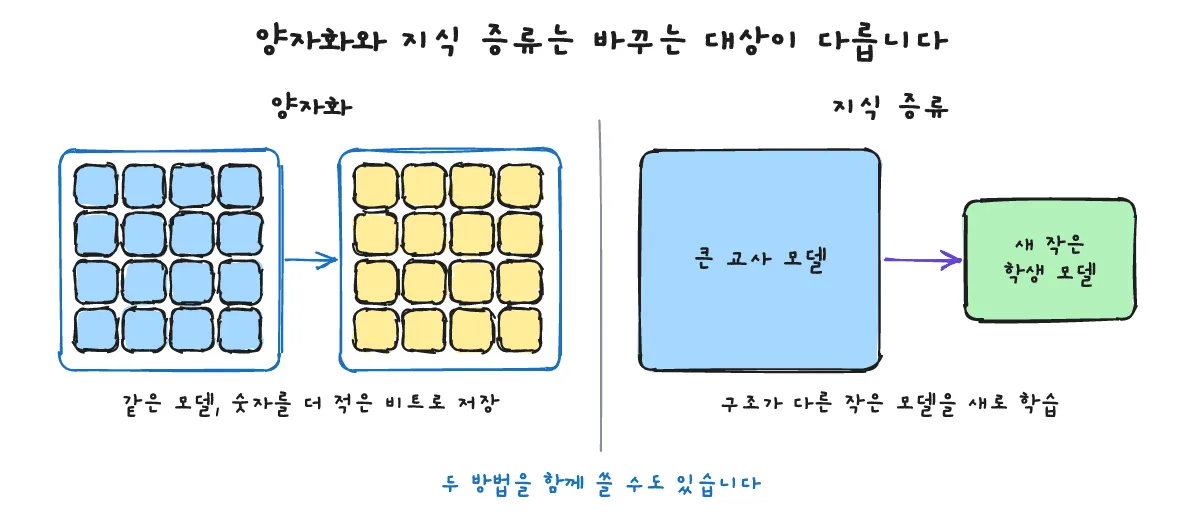
한 줄 답: 양자화는 같은 모델의 숫자를 더 적은 비트로 저장·연산하는 것이고, 지식 증류는 구조가 더 작은 별도의 모델을 새로 학습시키는 것입니다.
「양자화(Quantization)란? FP16·INT8·INT4 차이와 LLM 메모리가 줄어드는 이유」에서 다루듯 양자화는 기존 모델 자체는 그대로 유지한 채 숫자를 표현하고 계산하는 비트 수만 줄이는 방식입니다. 반면 지식 증류는 교사 모델과는 다른, 크기가 더 작은 학생 모델을 새로 학습시킵니다. 증류로 작게 만든 모델을 추가로 양자화하는 식으로 두 기법을 함께 쓸 수도 있습니다.
언제 지식 증류를 씁니까?
한 줄 답: 스마트폰·엣지 기기처럼 자원이 제한된 환경에 모델을 올리거나, 서버의 응답 지연과 추론 비용을 줄여야 할 때 씁니다.
메모리와 전력이 빠듯한 스마트폰이나 엣지 기기에 모델을 직접 배포해야 할 때, 또는 많은 요청을 처리하는 서버에서 응답 지연(latency)과 서빙 비용을 낮춰야 할 때 지식 증류를 활용합니다. 엣지에서 어떤 가속기로 돌리는지는 이 글(「NPU와 GPU 차이점은? 구조·용도·전력으로 쉽게 비교」)에서 확인할 수 있습니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 학생 모델의 성능 한계, 전문가 혼합(MoE)과의 관계, 파인튜닝과의 차이를 정리합니다.
학생 모델이 교사보다 좋아질 수 있습니까?
일반적으로 학생 모델이 교사 모델을 능가한다는 보장은 없으며, 보통은 훨씬 낮은 배포 비용으로 교사 모델의 성능에 최대한 가깝게 다가가는 것을 목표로 삼습니다.
MoE와 관계가 있습니까?
서로 다른 개념입니다. MoE는 하나의 모델 안에서 입력을 여러 전문가로 분기하는 방식이고, 지식 증류는 교사 모델의 지식을 별도의 작은 모델로 옮기는 방법입니다. 자세한 내용은 「MoE(Mixture of Experts)란? Dense 모델과 차이와 메모리 부담」에서 확인할 수 있습니다.
파인튜닝과는 무엇이 다릅니까?
파인튜닝은 같은 모델을 새로운 데이터로 이어서 학습시키는 것이고, 지식 증류는 교사 모델의 출력을 모방하도록 더 작은 새 모델을 학습시키는 것입니다. 전체 학습 단계 비교는 「사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?」에서 볼 수 있습니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 양자화, MoE, 모델 학습 단계, 엣지 가속기, 샘플링 온도를 다룬 관련 글 목록입니다.
- 「양자화(Quantization)란? FP16·INT8·INT4 차이와 LLM 메모리가 줄어드는 이유」
- 「MoE(Mixture of Experts)란? Dense 모델과 차이와 메모리 부담」
- 「사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?」
- 「NPU와 GPU 차이점은? 구조·용도·전력으로 쉽게 비교」
- 「Temperature와 Top-p란?」
출처는 어디입니까?
한 줄 답: 지식 증류와 소프트 타깃·온도 개념을 제시한 논문을 참고했습니다.
- Geoffrey Hinton, Oriol Vinyals, Jeff Dean, “Distilling the Knowledge in a Neural Network”, arXiv:1503.02531 (submitted 2015-03-09), https://arxiv.org/abs/1503.02531 (확인 2026-10-25)