핵심 요약
임베딩(Embedding)은 단어 같은 데이터를 의미가 담긴 숫자 벡터로 바꾸는 방법입니다. 벡터로 바꾸면 두 단어의 뜻이 얼마나 비슷한지를 거리나 각도로 계산할 수 있고, 각도로 비교하는 대표적인 방법이 코사인 유사도입니다.
SK하이닉스 AI 해커톤 1차 예선(10/17–18)을 준비하며 정리하는 AI 공부 노트입니다. Day5~7에서 RAG 흐름 속 Embedding을 한 줄로 정리했다면, 이번 글은 임베딩 자체가 어떤 원리로 뜻을 비교하게 해 주는지에 집중합니다.
임베딩이란? 단어를 숫자 목록(벡터)으로 바꾸는 이유는?
한 줄 답: 토큰(단어)을 의미가 담긴 숫자 벡터로 바꿔, 컴퓨터가 “뜻이 비슷한지”를 계산할 수 있게 하는 것입니다.
- 흐름은 텍스트 → 토큰 → 토큰 ID → 임베딩 벡터입니다. 텍스트가 토큰과 토큰 ID로 바뀌는 과정은 토큰과 컨텍스트 윈도우 글에서, 임베딩이 모델 안에서 어떻게 쓰이는지는 Day1 Self-Attention 글에서 다뤘습니다.
- Google ML Crash Course는 임베딩을 “임베딩 공간에서 데이터를 벡터로 표현한 것”이라고 설명합니다. 각 항목을 n개의 실수로 된 n차원 공간의 점으로 나타내고, 두 점 사이의 거리를 상대적인 유사도로 해석할 수 있습니다.
- 비유하면 지도 위의 좌표입니다. 뜻이 비슷한 단어는 가까운 자리에, 관련이 적은 단어는 먼 자리에 놓입니다.
- 이 좌표는 사람이 직접 숫자를 넣어 정하지 않습니다. 신경망을 학습하면서 임베딩 층이 데이터를 잘 표현하는 값을 스스로 익힙니다.
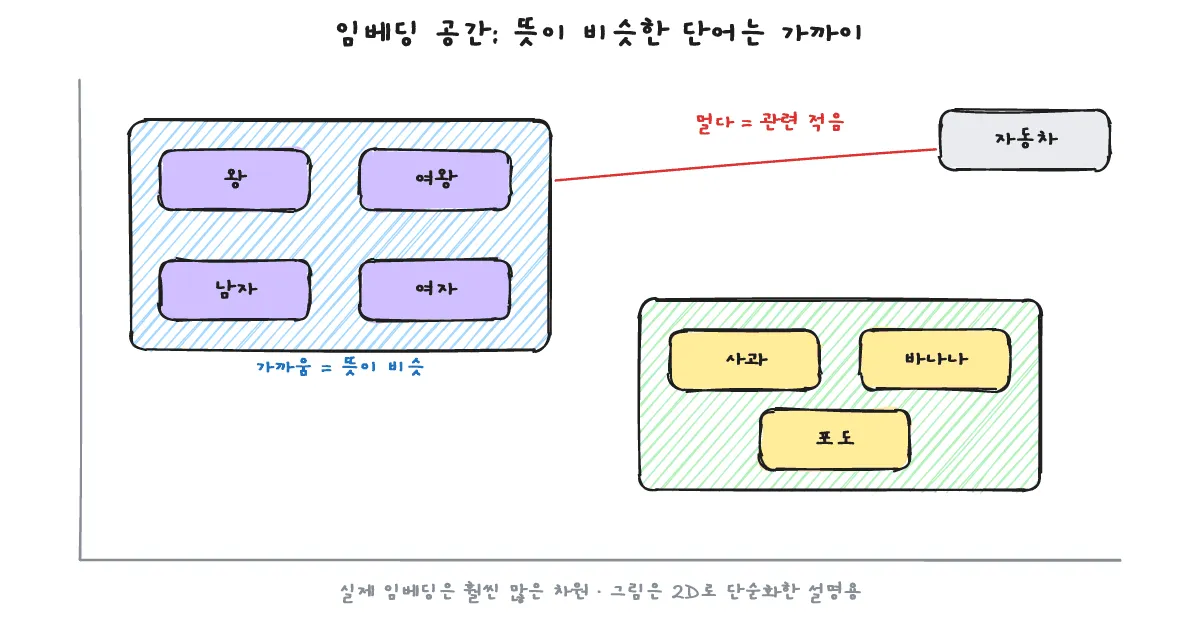
원-핫 인코딩 vs 임베딩 차이: 왜 원-핫으로는 뜻을 못 비교하나?
한 줄 답: 원-핫 벡터는 서로 다른 두 단어가 항상 같은 거리(직각)에 있어서 뜻이 비슷한지에 대한 정보가 없고, 임베딩은 비슷한 단어끼리 가깝게 배치되도록 학습됩니다.
- 원-핫 인코딩은 단어(범주)마다 한 칸만 1이고 나머지는 모두 0인 벡터입니다. 길이는 단어 수만큼 길어지고, 대부분의 값이 0인 희소(sparse) 벡터가 됩니다.
- 원-핫에서는 “왕”과 “여왕”도, “왕”과 “자동차”도 똑같이 서로 직각이라 코사인 유사도가 0입니다. 아래 코드 실행 결과에서 확인할 수 있습니다.
- 임베딩은 원-핫보다 짧고 값이 촘촘한(dense) 벡터이며, 학습을 통해 비슷한 단어끼리 가까워집니다.
| 구분 | 원-핫 인코딩 | 임베딩 |
|---|---|---|
| 길이 | 단어 수만큼 김 | 그보다 훨씬 짧음 |
| 0의 비율 | 한 칸 빼고 전부 0 (희소) | 대부분 0이 아닌 값 (촘촘) |
| 유사도 표현 | 없음 (서로 다른 단어는 모두 같은 거리) | 있음 (비슷한 단어가 가까움) |
| 학습 여부 | 규칙으로 정해짐 | 학습으로 정해짐 |
유명한 예로 word2vec 논문(Mikolov et al., 2013)은 vector(“King”) − vector(“Man”) + vector(“Woman”)의 결과가 “Queen”의 벡터와 가장 가깝다는 관찰을 소개합니다. 다만 이것은 직관을 돕는 예시이고, 이런 덧셈·뺄셈이 항상 정확히 성립하는 것은 아닙니다.
코사인 유사도란? 벡터로 “뜻이 가깝다”를 어떻게 재나?
한 줄 답: 두 벡터 사이의 각도로 비교하는 방법으로, 방향이 같을수록 1에 가깝고 직각이면 0입니다.
- 계산식은 두 벡터의 내적을 각 벡터 길이의 곱으로 나눈 값입니다. 길이는 무시하고 방향(각도)만 봅니다. Google의 유사도 측정 문서도 코사인은 벡터 사이의 각도에만 집중한다고 설명합니다.
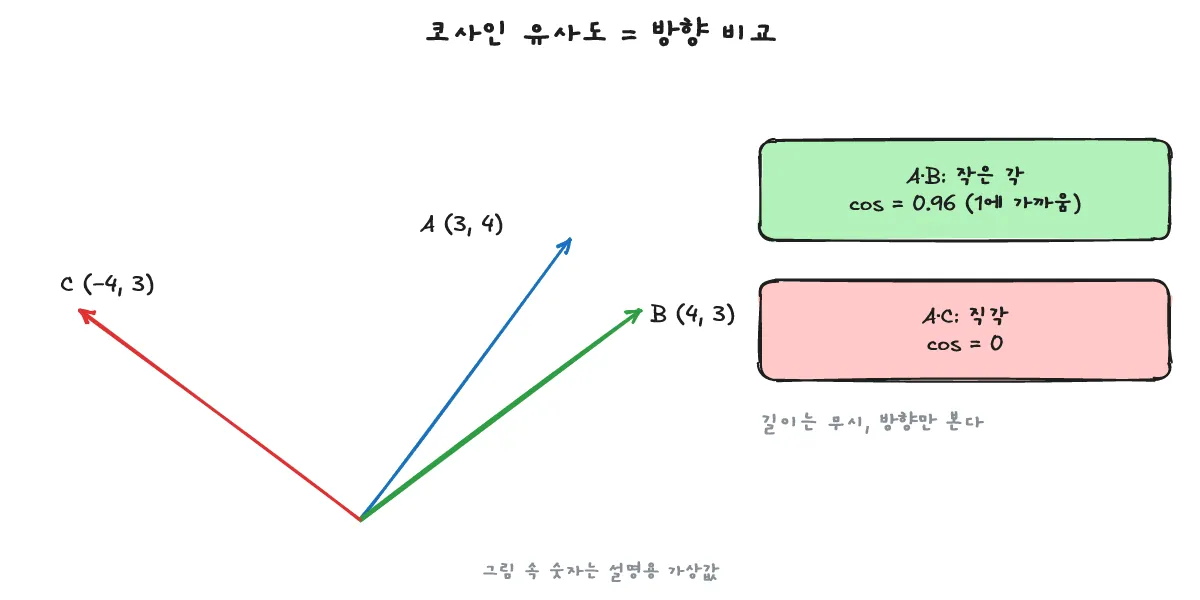
- 손계산 예를 보겠습니다. 설명용으로 만든 가상 벡터 A = (3, 4), B = (4, 3)이면 내적은 3×4 + 4×3 = 24, 두 벡터의 길이는 모두 5이므로 코사인 유사도는 24 / 25 = 0.96입니다. C = (−4, 3)은 A와 직각이라 내적이 0이고, 코사인 유사도도 0입니다.
- 임베딩끼리 코사인 유사도를 재면 비슷한 문장 찾기, 분류, 추천 같은 곳에 쓸 수 있습니다. 문서를 검색해 LLM에 넣는 활용은 Day5~7의 RAG 부분을 참고해 주세요.
# 설명용 가상 벡터로 코사인 유사도 계산 (실제 모델 값 아님)
import math

def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    return dot / (math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b)))

A = (3, 4)   # 예: "왕"
B = (4, 3)   # 예: "여왕" (방향이 비슷)
C = (-4, 3)  # 예: "자동차" (A와 직각)
print("cos(A, B) =", round(cosine(A, B), 2))
print("cos(A, C) =", round(cosine(A, C), 2))

# 원-핫: 서로 다른 두 단어는 항상 0
king  = (1, 0, 0, 0)
queen = (0, 1, 0, 0)
car   = (0, 0, 1, 0)
print("one-hot cos(king, queen) =", cosine(king, queen))
print("one-hot cos(king, car)   =", cosine(king, car))
cos(A, B) = 0.96
cos(A, C) = 0.0
one-hot cos(king, queen) = 0.0
one-hot cos(king, car) = 0.0가상 벡터에서는 손계산과 같은 0.96과 0.0이 나오고, 원-핫 벡터는 어떤 두 단어를 골라도 0.0이 나옵니다.
[시험용 한 줄] 임베딩 = 단어를 의미가 담긴 촘촘한 벡터로 바꾸는 것(학습으로 정해짐). 원-핫은 유사도 정보가 없다. 코사인 유사도 = 두 벡터의 방향 비교(같은 방향 1, 직각 0).
배운 내용을 퀴즈로 확인해 볼까요?
Q1. 원-핫 인코딩으로 “왕”과 “여왕”의 코사인 유사도를 재면 얼마입니까?
A1. 0입니다. 서로 다른 단어의 원-핫 벡터는 항상 직각이라, 뜻이 비슷해도 유사도 정보가 없습니다.
Q2. 임베딩 벡터의 숫자는 사람이 직접 정합니까?
A2. 아닙니다. 모델을 학습하면서 임베딩 층이 스스로 값을 익힙니다.
Q3. 두 벡터의 코사인 유사도가 1에 가깝다는 것은 무슨 뜻입니까?
A3. 두 벡터의 방향이 거의 같다는 뜻입니다. 임베딩에서는 뜻이 비슷하다고 해석할 수 있습니다.
Q4. “왕 − 남자 + 여자 ≈ 여왕”은 모든 임베딩에서 항상 정확히 성립합니까?
A4. 아닙니다. word2vec 연구에서 관찰된 직관용 예시이고, 항상 정확히 성립하지는 않습니다.