엔디안(Endianness)은 임베디드 면접에서 바이트 순서의 정의, C 코드로 호스트 바이트 순서를 확인하는 방법, 네트워크 및 이진 데이터 송수신 시 주의점을 물을 때 자주 나오는 주제입니다. 이 글의 실행 환경은 x86_64 리눅스(리틀엔디안)입니다.
핵심 요약
엔디안은 여러 바이트로 된 값을 메모리에 어떤 순서로 놓는지를 말합니다. 리틀엔디안은 가장 낮은 자리 바이트(LSB)를 낮은 주소에, 빅엔디안은 가장 높은 자리 바이트(MSB)를 낮은 주소에 둡니다. 리틀엔디안 호스트에서 0x12345678을 바이트로 읽으면 78 56 34 12가 나오고, 네트워크로 보낼 때는 htonl로 빅엔디안(네트워크 바이트 순서)으로 바꿉니다.
엔디안이란 무엇입니까?
한 줄 답: 엔디안(Endianness)은 여러 바이트로 이루어진 값을 메모리에 저장할 때 바이트를 배치하는 순서입니다.
엔디안은 한 바이트 내부의 비트(bit) 순서가 아니라, 멀티바이트 값의 바이트(byte)가 메모리에 놓이는 순서를 뜻합니다.
다른 아키텍처용으로 빌드할 때는 타깃 환경의 바이트 순서 같은 특성을 함께 고려해야 하며, 크로스 컴파일 설정 방법은 aarch64 크로스 컴파일 CMake, toolchain 파일은 어떻게 쓰나 글에서 다룹니다.
빅엔디안과 리틀엔디안은 어떻게 다릅니까?
한 줄 답: 가장 높은 자리 바이트(MSB)를 가장 낮은 메모리 주소에 두면 빅엔디안이고, 가장 낮은 자리 바이트(LSB)를 가장 낮은 메모리 주소에 두면 리틀엔디안입니다.
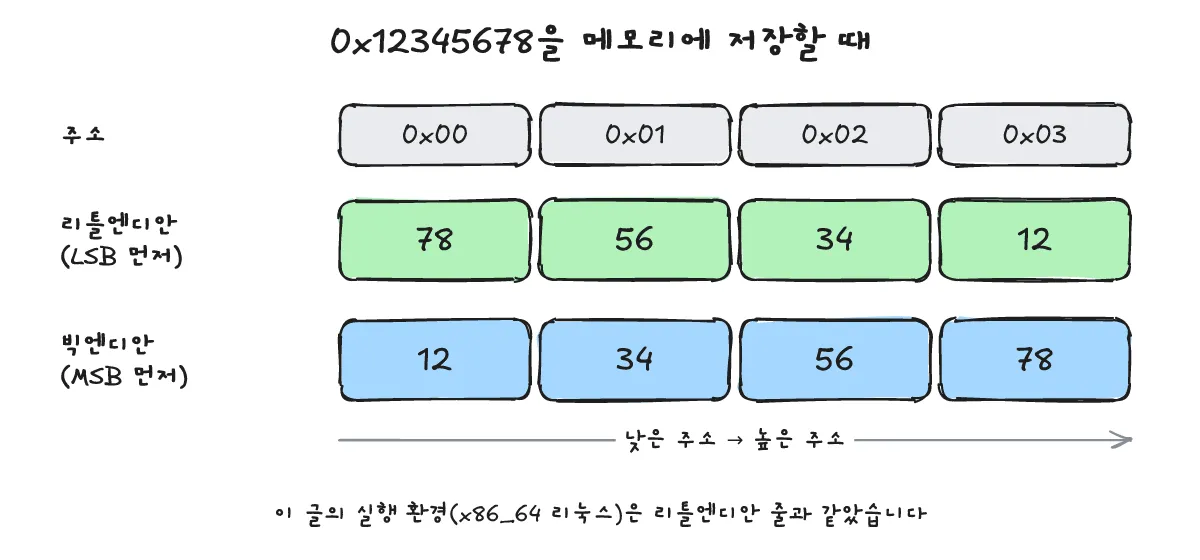
0x12345678에서 가장 높은 자리 바이트(Most Significant Byte, MSB)는 0x12이고, 가장 낮은 자리 바이트(Least Significant Byte, LSB)는 0x78입니다. 이 값을 메모리 주소 0x00부터 0x03까지 저장할 때 리틀엔디안은 78 56 34 12 순서로 배치하고, 개념상 빅엔디안은 12 34 56 78 순서로 배치합니다.
| 구분 | 주소 0x00 | 주소 0x01 | 주소 0x02 | 주소 0x03 |
|---|---|---|---|---|
| 리틀엔디안 (Little-endian) | 78 (LSB) | 56 | 34 | 12 (MSB) |
| 빅엔디안 (Big-endian, 개념) | 12 (MSB) | 34 | 56 | 78 (LSB) |
내 시스템의 엔디안은 어떻게 확인합니까?
한 줄 답: C 코드에서 멀티바이트 정수의 주소를 unsigned char *로 읽어 첫 바이트 값을 확인하거나, 리눅스 셸에서 lscpu 명령을 실행해 확인합니다.
C 언어에서 값의 바이트 배치를 확인할 때는 unsigned char * 포인터로 각 바이트를 읽는 방식을 일반적으로 사용합니다. 다음은 gcc (Debian 14.2.0-19) 14.2.0 환경에서 gcc -std=c11 -Wall endian.c -o endian 명령으로 경고 없이 컴파일한 뒤 ./endian을 실행한 코드입니다.
#include <stdio.h>
#include <stdint.h>
#include <arpa/inet.h>
int main(void) {
    uint32_t v = 0x12345678;
    const unsigned char *p = (const unsigned char *)&v;   /* 바이트 단위로 읽기 */
    printf("memory: %02x %02x %02x %02x\n", p[0], p[1], p[2], p[3]);
    printf("%s-endian\n", p[0] == 0x78 ? "little" : "big");
    uint32_t n = htonl(v);                                 /* 네트워크 바이트 순서(빅엔디안) */
    const unsigned char *q = (const unsigned char *)&n;
    printf("htonl:  %02x %02x %02x %02x\n", q[0], q[1], q[2], q[3]);
    printf("ntohl(htonl(v)) == v: %s\n", ntohl(n) == v ? "yes" : "no");
    return 0;
}
실행 결과는 다음과 같습니다.
memory: 78 56 34 12
little-endian
htonl:  12 34 56 78
ntohl(htonl(v)) == v: yes
같은 호스트에서 lscpu | grep -i "byte order" 명령을 실행하면 바이트 순서를 바로 확인할 수 있습니다.
Byte Order: Little Endian또한 디버거인 gdb에서는 x 명령으로 메모리의 바이트를 직접 확인할 수 있으며, 자세한 사용법은 임베디드 리눅스에서 gdb로 크래시 원인은 어떻게 찾나? core dump·gdbserver 실전 글에서 확인할 수 있습니다.
통신·파일에서는 왜 문제가 됩니까?
한 줄 답: 바이트 순서가 다른 장치끼리 멀티바이트 이진 데이터를 변환 없이 주고받으면 바이트가 반대로 읽혀 값이 달라지기 때문입니다.
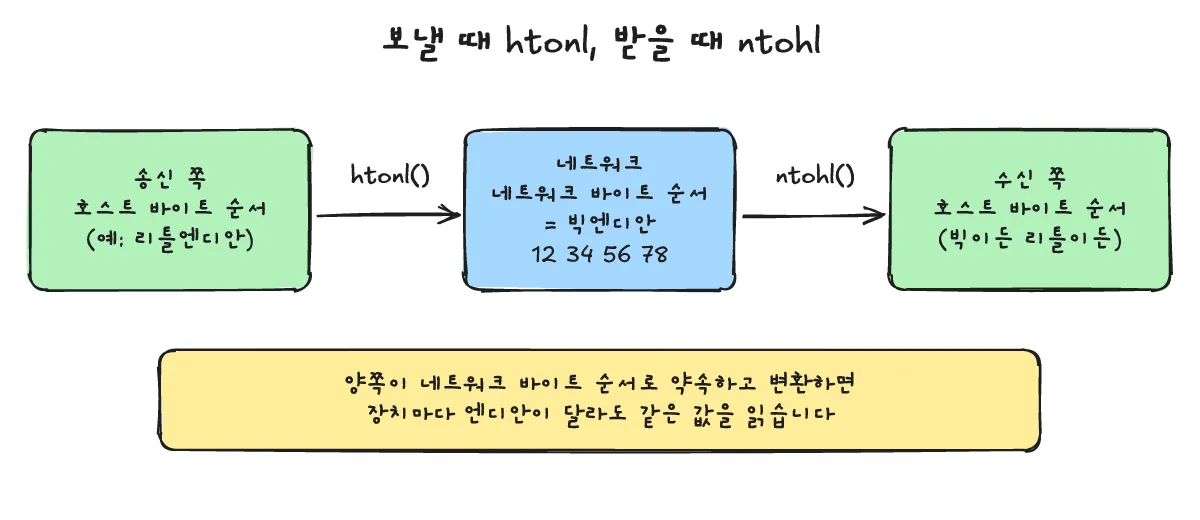
리눅스 매뉴얼 byteorder(3)(POSIX.1-2008 표준)에 따르면 인터넷에서 쓰이는 네트워크 바이트 순서는 가장 높은 자리 바이트가 먼저 오는 빅엔디안(Most Significant Byte first)인 반면, 리틀엔디안 호스트의 바이트 순서는 가장 낮은 자리 바이트가 먼저 오는 방식(Least Significant Byte first)입니다. <arpa/inet.h>에 선언된 htonl과 htons는 호스트 바이트 순서를 네트워크 바이트 순서로 변환하고, ntohl과 ntohs는 다시 호스트 바이트 순서로 되돌립니다. 위 실행 결과에서 htonl: 12 34 56 78과 ntohl(htonl(v)) == v: yes가 출력된 것처럼, 바이트 순서가 다른 장치 사이에 이진 데이터나 파일을 교환할 때는 바이트 순서를 미리 정하고 변환 함수를 거쳐야 합니다.
임베디드 통신 인터페이스 비교는 I2C vs SPI vs UART 차이: 임베디드 면접에서 어떻게 비교하나? 글에서 다룹니다.
면접에서 자주 나오는 엔디안 질문은 무엇입니까?
한 줄 답: 문자열(char 배열)의 바이트 순서, 구조체 전송 시 패딩 문제, 비트 필드 배치, 공용체(union)를 이용한 확인 시 C와 C++의 차이를 자주 묻습니다.
문자열(char 배열)에도 엔디안이 있습니까?
char 배열이나 문자열은 각 원소가 단일 바이트이므로 바이트 순서에 따라 글자 순서가 바뀌지 않으며, 엔디안은 여러 바이트로 이루어진 값에서 문제가 됩니다.
구조체를 그대로 전송하면 왜 안 됩니까?
바이트 순서 차이뿐만 아니라 컴파일러가 정렬(alignment)을 위해 멤버 사이에 패딩(padding)을 넣을 수 있어 컴파일러나 아키텍처마다 구조체의 실제 바이트 배치가 달라질 수 있기 때문입니다.
비트 필드는 무엇을 조심해야 합니까?
비트 필드(bit-field)가 저장 단위 안에 어떤 순서로 배치되는지는 구현 정의(implementation-defined) 사항이므로, 서로 다른 시스템 사이에 비트 필드 구조체를 원시 바이트 그대로 주고받지 않아야 합니다.
공용체(union)로 엔디안을 확인해도 됩니까?
C(C99 TC3 이후)에서는 마지막으로 기록한 멤버가 아닌 다른 공용체 멤버를 읽으면 저장된 객체 표현을 재해석(type punning)하지만, C++에서는 마지막으로 기록하지 않은 공용체 멤버를 읽는 것이 미정의 동작(undefined behavior)이고 많은 컴파일러가 비표준 확장으로만 허용하므로 C++에서는 unsigned char *로 바이트를 읽는 편이 안전합니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 크로스 컴파일, 임베디드 리눅스 부팅 과정, gdb 메모리 디버깅, 통신 인터페이스 비교 글을 함께 참고하시기 바랍니다.
- aarch64 크로스 컴파일 CMake, toolchain 파일은 어떻게 쓰나
- 임베디드 리눅스 부팅 과정, 부트로더부터 유저랜드까지
- 임베디드 리눅스에서 gdb로 크래시 원인은 어떻게 찾나? core dump·gdbserver 실전
- I2C vs SPI vs UART 차이: 임베디드 면접에서 어떻게 비교하나?
출처는 어디입니까?
한 줄 답: Linux man-pages byteorder(3) 문서와 cppreference의 C·C++ 공용체(union) 문서를 참고했습니다.
- man7 — byteorder(3) Linux manual page (확인 2026-10-25)
- cppreference — C language union declaration (확인 2026-10-25)
- cppreference — C++ language union declaration (확인 2026-10-25)