핵심 요약
LLM 추론 프레임워크는 학습된 모델 가중치를 읽어 요청을 받아 토큰을 만들어 주는 실행 엔진입니다. 여러 요청을 묶어 GPU를 효율적으로 쓰는 서버형(vLLM 등)과, 노트북·CPU·작은 GPU에서 양자화 모델을 가볍게 돌리는 로컬형(llama.cpp 등)으로 나눠 보면 고르기 쉽습니다.
한 줄 답: 서버형(vLLM 등)과 로컬형(llama.cpp 등)으로 나누고, 사용자 수·하드웨어·모델 포맷으로 고르면 됩니다.
최근 Hacker News에서도 특정 모델군을 위한 추론 엔진이 큰 화제가 되었습니다. 이 글은 개념을 정리하는 글이라 설치나 실행 명령은 다루지 않습니다.
LLM 추론 프레임워크란 무엇이고, 모델 파일만으로는 왜 안 되나요?
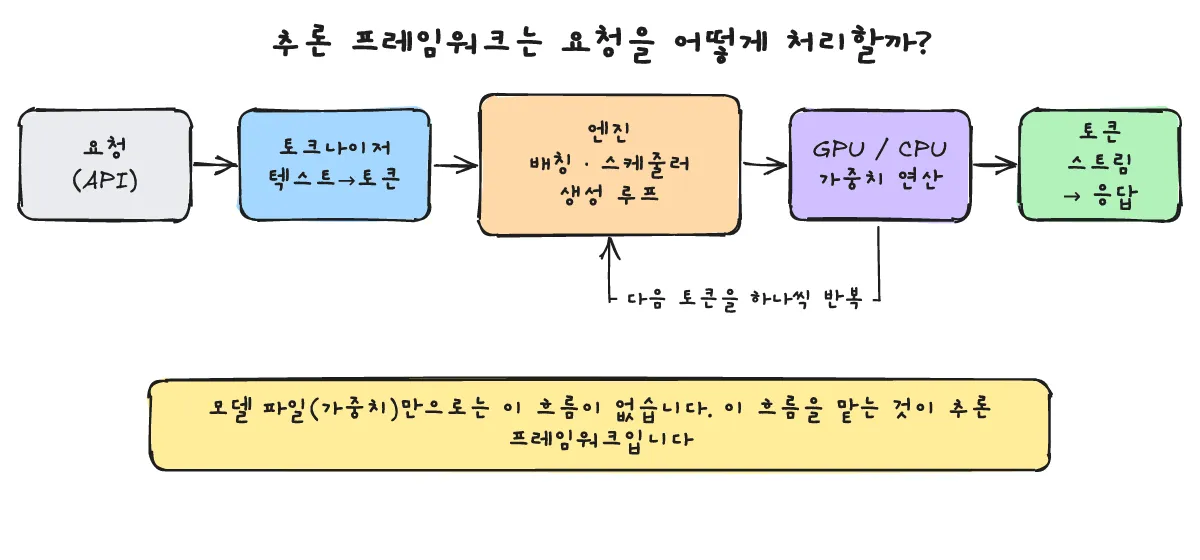
한 줄 답: 가중치 파일은 데이터일 뿐이라, 로딩·토크나이즈·토큰별 생성 루프·API 서버를 맡는 실행 엔진이 필요합니다.
모델 파일에는 학습된 가중치만 들어 있습니다. 이 가중치를 메모리에 올리고, 입력 문장을 토크나이저로 토큰으로 바꾸고, 토큰을 하나씩 이어서 생성하는 반복 루프를 돌리고, 결과를 요청한 쪽에 돌려주는 일은 별도의 소프트웨어가 맡아야 합니다. 이 역할을 하는 것이 추론 프레임워크입니다. vLLM 문서는 스트리밍 출력, OpenAI 호환 API 서버, Hugging Face 모델 연동을 기능으로 소개하고, llama.cpp README는 GGUF 모델 파일 사용과 OpenAI 호환 API 서버 포함을 안내합니다.
토큰과 컨텍스트 개념이 낯설다면 토큰/컨텍스트 정리 글을 먼저 보셔도 좋습니다.
서버형과 로컬형은 무엇이 다른가요?
한 줄 답: 서버형은 동시 요청을 묶어 GPU를 효율적으로 쓰고, 로컬형은 CPU·소형 GPU에서 양자화 모델을 가볍게 돌립니다.
| 구분 | 서버형 (예: vLLM) | 로컬형 (예: llama.cpp) |
|---|---|---|
| 핵심 목표 | 들어오는 여러 요청을 묶어 처리 | 적은 자원에서 가볍게 실행 |
| 메모리·배칭 | PagedAttention, continuous batching | CPU+GPU 하이브리드 추론(VRAM보다 큰 모델 대응) |
| 양자화 | FP8, INT8, INT4, GPTQ/AWQ, GGUF 등 지원 | 1.5비트~8비트 정수 양자화 |
| 하드웨어 | tensor/pipeline parallelism으로 분산 추론 | 의존성 없는 C/C++, Apple silicon 우선(NEON, Accelerate, Metal) |
| 모델 포맷 | Hugging Face 모델 연동 | GGUF 파일 |
| API | OpenAI 호환 서버, 스트리밍 출력 | OpenAI 호환 서버 포함 |
양자화가 무엇인지는 양자화 정리 글에서 다뤘습니다. KV 캐시는 여기서 다시 설명하지 않으며, 궁금하시면 AI Day3: LLM 추론·KV 캐시를 참고해 주시기 바랍니다.
어떤 기준으로 고르나요?
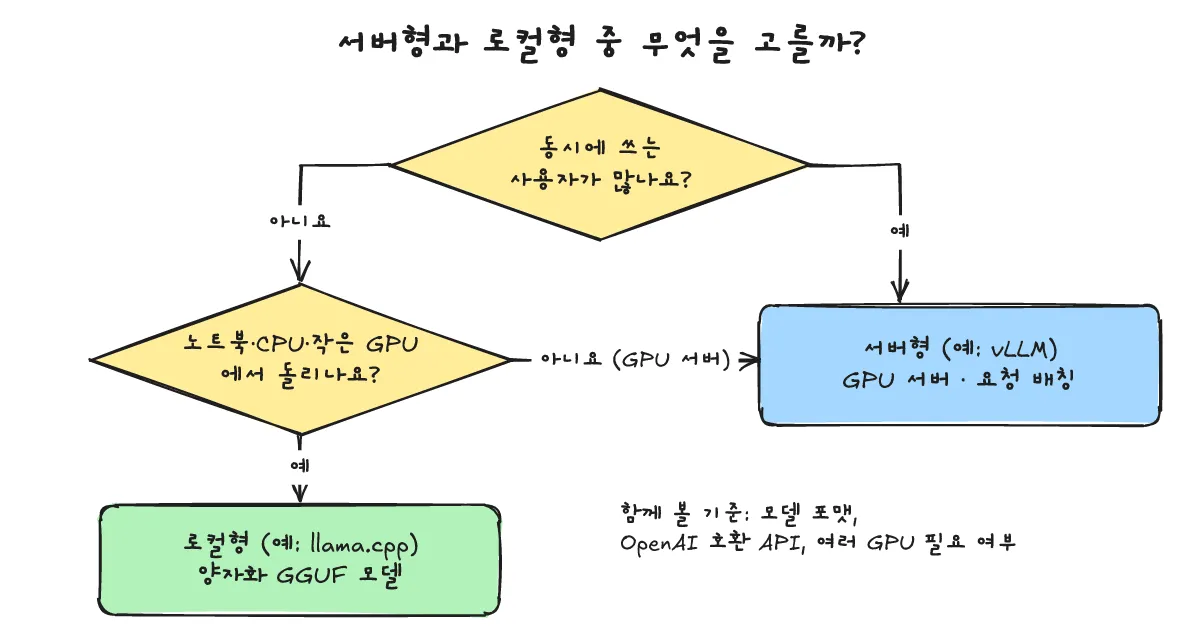
한 줄 답: 동시 사용자 수, 하드웨어, 모델 포맷, 멀티 GPU 필요 여부로 정하면 됩니다.
- 사용자 수: 여러 사용자의 요청을 동시에 받아야 하면 서버형, 혼자 쓰면 로컬형이 자연스럽습니다.
- 하드웨어: 서버용 GPU를 쓸 수 있으면 서버형, 노트북·CPU·작은 GPU라면 로컬형이 맞습니다.
- 모델 포맷: safetensors/Hugging Face 형식이면 서버형, GGUF 파일이면 로컬형과 잘 맞습니다.
- OpenAI 호환 API: 둘 다 제공하므로 결정 요인이 아닙니다.
- 멀티 GPU: 여러 GPU로 나눠 돌려야 한다면 tensor/pipeline parallelism을 지원하는 서버형을 보시면 됩니다.
요즘 모델사가 자체 추론 엔진을 내는 이유는 무엇인가요?
한 줄 답: 특정 모델 구조에 맞춘 최적화를 넣기 위해서라고 볼 수 있습니다. 다만 일반적인 추론일 뿐 공식 설명은 아닙니다.
2026-10-20 Hacker News에 “DeepInfer: High-performance inference framework for DeepSeek models”라는 글이 올라와 특정 모델군을 위한 추론 엔진이 화제가 되었습니다(HN 스레드). 한 모델 구조에 맞춰 최적화하면 범용 엔진보다 유리한 부분을 넣을 수 있기 때문이라고 생각해 볼 수 있습니다. 다만 이는 일반적인 추론일 뿐, 위 스레드의 내용이나 수치를 근거로 한 설명은 아닙니다.
자주 묻는 질문은 무엇인가요?
로컬형으로 여러 사람이 써도 되나요?
가능은 하지만, 동시 요청을 묶어 처리하는 배칭이 핵심인 쪽은 서버형입니다. 여러 사람이 함께 써야 한다면 서버형이 더 맞는 선택입니다.
양자화하면 품질이 떨어지나요?
떨어질 수 있으며, 모델과 양자화 방식에 따라 다릅니다. 자세한 내용은 양자화 정리 글을 참고해 주시기 바랍니다.
OpenAI 호환 API가 왜 중요한가요?
기존 클라이언트 코드를 거의 그대로 재사용할 수 있기 때문입니다. vLLM과 llama.cpp 모두 OpenAI 호환 API 서버를 제공합니다.
출처는 어디인가요?
한 줄 답: vLLM 문서, llama.cpp GitHub, HN 스레드이며 모두 2026-10-21에 확인했습니다.
함께 보면 좋은 글
외부 출처
- vLLM docs (확인일 2026-10-21)
- llama.cpp GitHub (확인일 2026-10-21)
- Hacker News: DeepInfer (2026-10-20 게시, 확인일 2026-10-21)