핵심 요약
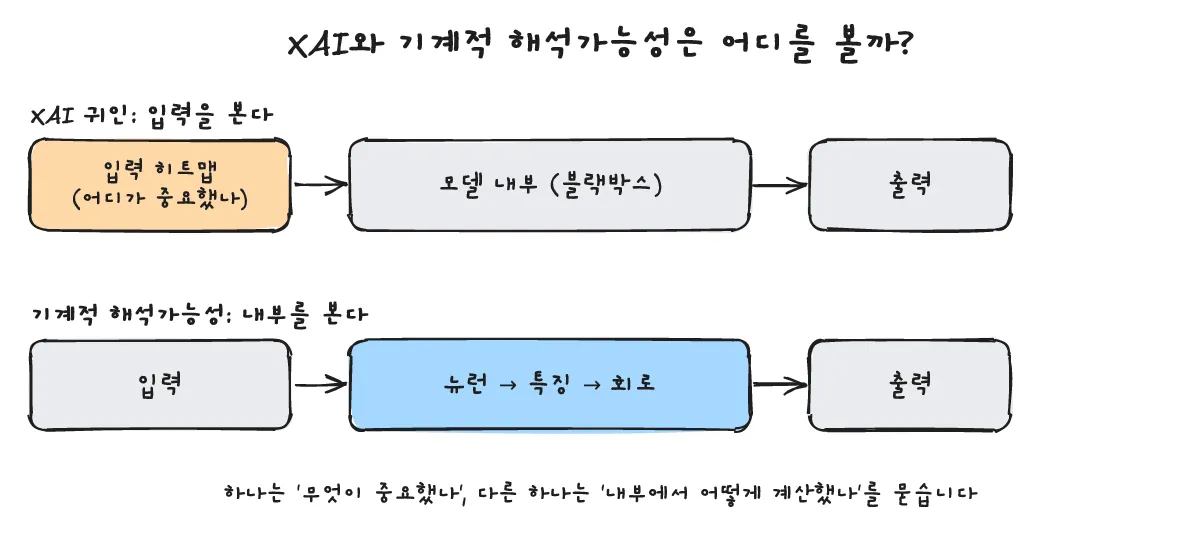
**기계적 해석가능성(Mechanistic Interpretability)**은 어떤 입력이 출력에 영향을 미쳤는지(예: 히트맵)만 살피는 일반적인 설명가능 AI(XAI) 귀인 방식과 달리, 신경망 내부의 뉴런·특징(feature)·회로(circuit) 메커니즘을 직접 역설계하는 연구 분야입니다. 이 분야에서 다루는 대표적인 난제가 바로 뉴런 하나가 서로 무관해 보이는 여러 개념에 반응하는 **다의성(polysemanticity)**입니다. 이는 모델이 보유한 차원 수보다 더 많은 희소 특징을 간섭(interference)을 감수하며 압축해 표현하는 중첩(superposition) 가설(Anthropic, Toy Models of Superposition, 2022-09-14)로 주로 설명됩니다. 연구자들은 레이어 활성값을 더 큰 희소 특징 집합으로 풀어내는 **희소 오토인코더(SAE)**를 활용하는 한편, 최근 Goodfire의 Nick Cammarata가 제시한 작업 가설(Neural networks are clean)처럼 다의성으로 보이던 현상의 상당수가 사실 ‘재귀적 일반화(recursive generalization)‘라는 반론을 두고 활발히 논쟁하고 있습니다.
기계적 해석가능성이란 무엇이며, 일반적인 설명가능 AI(XAI)와 어떻게 다른가요?
한 줄 답: 일반적인 XAI 귀인(attribution)이 출력에 어떤 입력이 중요했는지(예: 히트맵)를 보여준다면, 기계적 해석가능성은 모델 내부의 뉴런, 특징(feature), 회로(circuit) 메커니즘을 직접 역설계합니다.
- XAI 귀인(Attribution) vs 기계적 해석가능성(Mechanistic Interpretability): XAI 귀인 방식은 특정 결과가 나왔을 때 입력의 어느 부분이 중요하게 작용했는지를 히트맵 등으로 설명하는 데 초점을 맞춥니다. 반면 기계적 해석가능성은 신경망 내부로 들어가 개별 뉴런과 특징, 그리고 이들이 연결되어 작동하는 회로의 내부 메커니즘을 역설계합니다.
- 모델에 입력되는 기본 단위인 토큰과 컨텍스트의 기초는 토큰/컨텍스트 정리 글을 참고하시기 바랍니다.
다의성(polysemanticity)이란 무엇이고, 왜 뉴런 하나가 여러 개념을 담게 되나요?
한 줄 답: 다의성은 뉴런 하나가 서로 무관해 보이는 여러 대상에 반응하는 현상으로, 모델이 가진 차원 수보다 더 많은 희소 특징을 간섭을 감수하며 압축해 표현하는 중첩(superposition) 때문으로 설명됩니다.
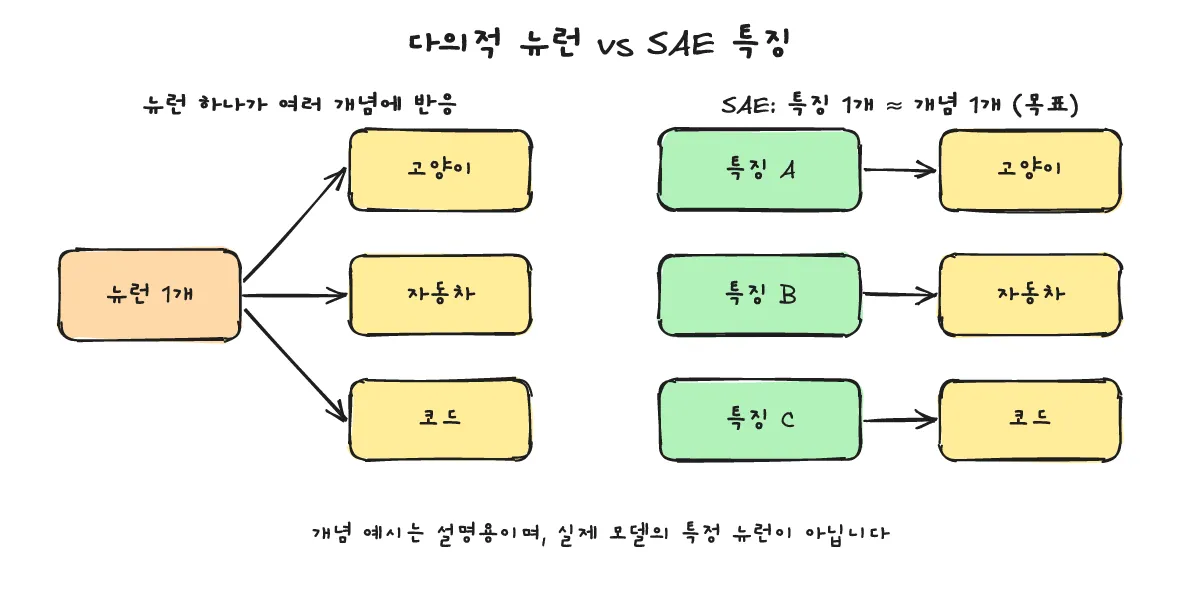
- 다의적(Polysemantic) vs 단의적(Monosemantic): 단의적 뉴런이나 특징은 하나의 명확한 개념에 일대일로 대응하지만, 다의적 뉴런은 서로 무관해 보이는 여러 개념에 동시에 반응합니다.
- 중첩(Superposition)과 Toy Models of Superposition (Anthropic, 2022-09-14):
- 정의: 중첩은 모델이 자신이 가진 차원 수보다 더 많은 특징을 표현(represent more features than they have dimensions)하는 현상입니다. 특징들이 희소(sparse)할 때는 비선형 필터링(nonlinear filtering)이 필요한 ‘간섭(interference)‘을 대가로 치르면서 특징을 압축해 저장할 수 있습니다.
- 실험 설정 및 한계: 이 논문은 희소한 입력 특징을 가진 합성 데이터로 학습된 작은 ReLU 네트워크(small ReLU networks trained on synthetic data with sparse input features)를 분석해 단의적 뉴런과 다의적 뉴런이 모두 형성될 수 있음(Both monosemantic and polysemantic neurons can form)을 보였습니다. 다만 저자들은 이 결과를 실제 대규모 네트워크에 어디까지 일반화할 수 있는지는 매우 불분명하다(it’s very unclear what to generalize to real networks)고 밝혔습니다.
- 기하학적 예시: 2차원 공간에 5개의 특징을 담으려 할 때, 특징이 조밀(dense)하면 가장 중요한 상위 2개만 저장됩니다. 그러나 특징이 희소하면 간섭을 감수하고 추가 특징을 함께 저장합니다. 예를 들어 2차원 공간에 3개의 특징을 배치하면 정삼각형(triangle) 형태를 이루게 됩니다.
실제 실행 결과 (손으로 만든 예시, 학습된 모델 아님)
import numpy as np
# 3 features squeezed into 2 dimensions (triangle layout, as in Toy Models of Superposition)
ang = np.deg2rad([90, 210, 330])
W = np.stack([np.cos(ang), np.sin(ang)])      # shape (2 dims, 3 features)
print("W^T W (feature overlap):")
print(np.round(W.T @ W, 2))
x = np.array([1.0, 0.0, 0.0])                  # only feature 0 is active
h = W @ x                                      # 2-dim hidden vector
print("readout W^T h      :", np.round(W.T @ h, 2))
print("after ReLU(.. -0.4):", np.round(np.maximum(W.T @ h - 0.4, 0), 2))
W^T W (feature overlap):
[[ 1. -0.5 -0.5]
[-0.5 1. -0.5]
[-0.5 -0.5 1. ]]
readout W^T h : [ 1. -0.5 -0.5]
after ReLU(.. -0.4): [0.6 0. 0. ]위 실행 결과(Python 3 + numpy 2.5.3)에서 보듯, 3개의 특징이 2개의 차원을 공유하기 때문에 0번 특징 하나(x = [1.0, 0.0, 0.0])만 활성화해 다시 읽어낼 때도 다른 특징들로 -0.5만큼의 간섭(interference)이 새어 나갑니다. 여기에 음수 편향(-0.4)을 가진 ReLU를 적용하면 간섭이 걸러져 [0.6, 0., 0.]만 남는데, 이는 논문이 설명한 비선형 필터링(nonlinear filtering) 아이디어를 간단히 축소해 보여줍니다.
연구자들은 얽혀 있는 특징을 어떻게 분리해 내나요?
한 줄 답: 레이어 활성값을 더 큰 규모의 희소 특징 집합으로 다시 쓰는 희소 오토인코더(SAE)를 학습시키거나, 최근 작업 가설처럼 다의성을 재귀적 일반화로 보고 뉴런을 직접 분석하려는 시도가 이어지고 있습니다.
- 희소 오토인코더(SAE, Sparse Autoencoder): 레이어의 활성값(activations)을 더 큰 규모의 희소 특징 집합으로 재작성하도록 학습된 두 번째 모델입니다. ‘특징 1개 ≈ 개념 1개’를 목표로 하는 사전 학습(dictionary learning) 기법이며, Anthropic의 2023년 연구인 Towards Monosemanticity가 대표적인 사례로 꼽힙니다.
- 최근 반론과 작업 가설 (Hacker News 토론 및 Neural networks are clean): Goodfire의 Nick Cammarata는 자신의 에세이를 **“작업 가설(A working hypothesis)“**으로 명시하며 다음과 같은 주장을 펼칩니다.
- 에세이 저자는 기존의 대표적인 다의성 증거들이 잘못 해석되었으며, 겉보기에 다의적으로 보이는 현상의 상당수는 뉴런이 연관된 가지를 뻗어 나가는 **“재귀적 일반화(recursive generalization)“**라고 주장합니다(예:
"iy"뉴런 →"diy"→"do it yourself"). - 에세이 저자는 유명한 InceptionV1의 “고양이 얼굴과 자동차 앞면(cat faces and car fronts)” 뉴런 역시 자신의 해석에 따르면 사실 V자 형태(V-shape) 뉴런이라고 주장합니다.
- 따라서 에세이 저자는 SAE 같은 분해(decomposition) 기법으로 뉴런을 먼저 풀어내지 않고도 뉴런 자체를 직접 연구할 수 있다고 주장합니다.
- 또한 Qwen3-32B에 대한 예비 감사(preliminary audit)를 근거로 에세이 저자는 “뉴런 극(neuron poles)의 약 90%가 하나의 주요 역할을 한다(roughly 90% of neuron poles have one main job)“고 주장하며, 이 수치는 임계값(thresholds) 설정에 따라 달라진다는 단서를 함께 달았습니다.
- 에세이 저자는 기존의 대표적인 다의성 증거들이 잘못 해석되었으며, 겉보기에 다의적으로 보이는 현상의 상당수는 뉴런이 연관된 가지를 뻗어 나가는 **“재귀적 일반화(recursive generalization)“**라고 주장합니다(예:
- HN 토론의 반론과 한계: Hacker News 스레드의 한 댓글 작성자는 “중첩(superposition)이 완전히 틀렸다고 성급히 단정하지는 않겠다(would not rush to say that superposition is completely wrong)“고 지적했습니다. 이 주장은 한 연구자가 제시한 작업 가설(working hypothesis)일 뿐 학계의 확정된 합의(settled consensus)가 아니며, 여전히 논쟁이 진행 중입니다.
기계적 해석가능성이 개발자에게 왜 중요한가요?
한 줄 답: 모델 행동 디버깅, 안전성 연구, 모델 편집 및 조향(steering)에 실마리를 제공하지만, 이 모든 영역은 아직 연구 단계(research-stage)에 머물러 있어 실무에서의 확실한 보장은 없습니다.
- 모델 행동 디버깅(Debugging model behaviour): 모델이 특정 입력에 대해 왜 그러한 출력을 내놓았는지 내부 특징과 회로 수준에서 추적하려는 연구입니다.
- 안전성 연구(Safety research): 모델 내부에 숨어 있는 위험하거나 의도치 않은 동작 메커니즘을 파악하려는 연구입니다.
- 모델 편집 및 조향(Model editing/steering): 특정 특징이나 뉴런의 활성값을 조절해 모델의 행동을 원하는 방향으로 유도하려는 시도입니다.
- 한계 주의: 위 세 가지 영역은 모두 아직 **연구 단계(research-stage)**에 있으며, 실제 프로덕션 환경에서 확실한 동작이나 해결을 보장하지 않습니다(no guarantees).
- 모델 가중치와 내부 표현을 압축해 다루는 또 다른 관점은 양자화(Quantization) 정리 글에서 확인하실 수 있습니다.
기계적 해석가능성에 대해 자주 묻는 질문은 무엇인가요?
Q1. 일반 XAI(설명가능 AI)와 기계적 해석가능성의 가장 큰 차이는 무엇인가요?
XAI 귀인 방식은 출력에 어떤 입력이 중요했는지(예: 히트맵)를 설명하는 반면, 기계적 해석가능성은 모델 내부의 뉴런, 특징, 회로 메커니즘 자체를 역설계합니다.
Q2. 중첩(superposition)이 일어나면 왜 간섭(interference)이 생기나요?
모델이 가진 차원 수보다 더 많은 특징을 겹쳐서 표현하기 때문입니다. 특징이 희소할 때 압축 저장이 가능하지만 다른 특징으로 값이 새어 나가는 간섭이 발생하며, 이를 걸러내기 위해 음수 편향을 둔 ReLU 같은 비선형 필터링이 필요합니다(Anthropic, Toy Models of Superposition, 2022).