핵심 요약
위치 인코딩(Positional Encoding)은 트랜스포머에 “이 토큰이 몇 번째인지”를 알려 주는 정보입니다. Self-Attention 자체는 토큰 순서를 구분하지 못하므로, 원래 트랜스포머는 차원마다 주파수가 다른 사인·코사인 값을 임베딩에 더했습니다. RoPE는 더하는 대신 Query와 Key 벡터를 위치만큼 회전시켜, 두 토큰의 내적에 상대 위치(m − n)만 남게 만드는 방식입니다.
**위치 인코딩(Positional Encoding)**은 트랜스포머(Transformer)가 문장 속 단어 순서를 구분할 수 있도록 각 토큰에 위치 정보를 넣어 주는 방법입니다. 이 글에서는 트랜스포머에 단어 순서 정보가 필요한 이유부터 사인·코사인 위치 인코딩, 학습형 위치 임베딩, 그리고 회전 행렬로 상대 위치를 반영하는 RoPE(Rotary Position Embedding)의 원리와 차이를 정리합니다.
위치 인코딩은 왜 필요합니까?
한 줄 답: Self-Attention은 입력을 순서 없는 집합처럼 다루므로, 위치 정보를 따로 넣어 주지 않으면 단어 순서를 섞어도 토큰별 계산 결과가 같아지기 때문입니다.
트랜스포머를 제안한 Vaswani et al., “Attention Is All You Need” 논문은 이 모델이 순환(recurrence)과 합성곱(convolution)을 포함하지 않는다(“contains no recurrence and no convolution”)고 설명합니다. 따라서 시퀀스의 순서를 모델이 활용하려면 시퀀스 안에서 각 토큰의 상대적 또는 절대적 위치에 관한 정보를 반드시 주입해야 합니다.
위치 인코딩이 들어가는 자리를 이해하려면 먼저 트랜스포머의 기본 요소들을 함께 살펴보는 것이 좋습니다.
- 입력 텍스트를 모델이 처리하는 단위와 길이 한계는 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유에서 다룹니다.
- 쪼개진 각 토큰을 고정된 차원의 실수 벡터로 바꾸는 과정은 임베딩(Embedding)이란? 단어를 벡터로 바꿔 의미를 비교하는 원리에서 확인할 수 있습니다.
- 임베딩 벡터들로부터 Query(Q), Key(K), Value(V)를 만들어 서로의 비중을 계산하는 원리는 Self-Attention이란? Q·K·V로 토큰 비중 매기는 법에 정리되어 있습니다.
- 어텐션과 피드포워드 층이 결합된 전체 블록 구성은 트랜스포머 구조 정리 글을 참고하시기 바랍니다.
사인·코사인 위치 인코딩은 어떻게 만듭니까?
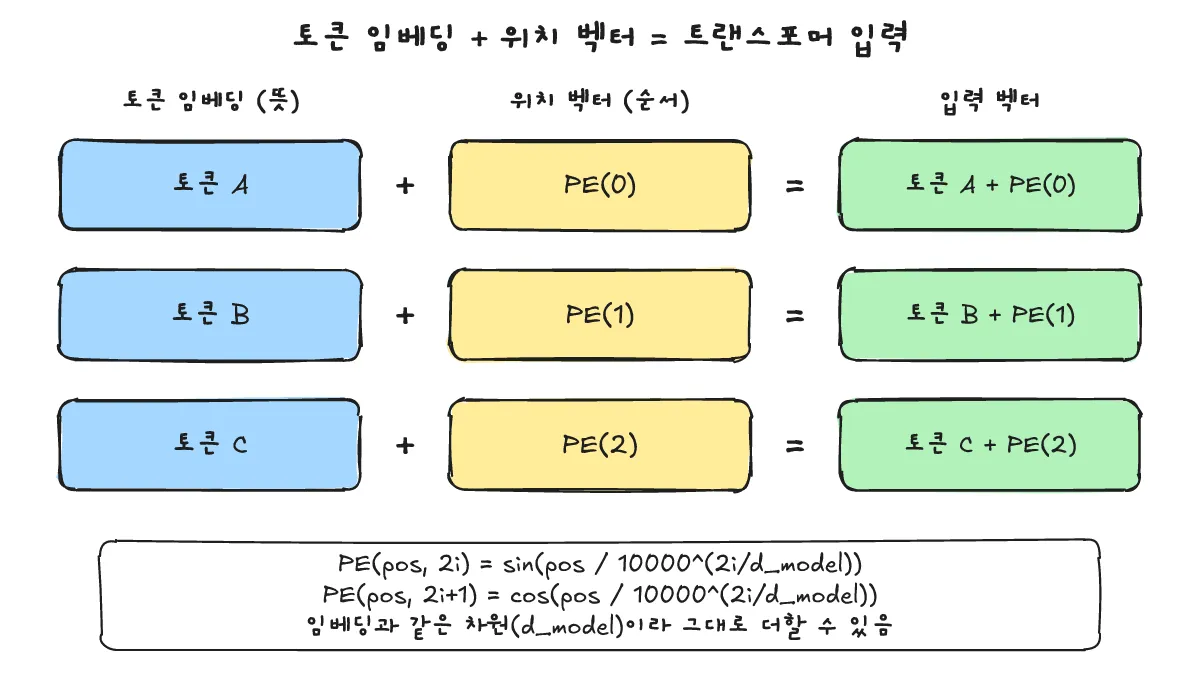
한 줄 답: 차원 쌍마다 서로 다른 주파수의 사인(sin)·코사인(cos) 함수로 위치 벡터를 만든 뒤, 토큰 임베딩 벡터에 그대로 더합니다.
원래 트랜스포머 논문에서는 입력 임베딩과 위치 인코딩이 서로 더해질 수 있도록 두 벡터의 차원을 d_model로 같게 맞춥니다. 위치 pos와 차원 쌍 인덱스 i에 대한 사인·코사인 위치 인코딩 수식은 다음과 같습니다.
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
여기서 pos는 시퀀스 안에서의 토큰 위치이고, i는 차원 인덱스입니다. 각 차원은 하나의 사인파에 대응하며, 파장(wavelength)은 2π부터 10000·2π까지 기하급수(geometric progression)를 이룹니다. 따라서 앞쪽(낮은) 차원은 위치가 바뀔 때 값이 빠르게 변하고, 뒤쪽(높은) 차원은 천천히 변합니다. 논문 저자들은 고정된 오프셋 k에 대해 PE(pos+k)를 PE(pos)의 선형 함수(linear function)로 표현할 수 있기 때문에, 모델이 상대 위치에 따라 어텐션하는 법을 쉽게 학습할 수 있을 것이라 가정했습니다.
다음 pe.py 코드와 출력은 이 글의 실행 환경(Python 3.13.5, NumPy 2.5.4)에서 확인한 값입니다(코드 안의 d_model=8, θ=1, q=(1,2), k=(3,1)은 동작을 보여 주기 위한 예: 값입니다).
import numpy as np
np.set_printoptions(precision=3, suppress=True)
d = 8
pos = np.arange(4)[:, None]
i = np.arange(d // 2)[None, :]
ang = pos / 10000 ** (2 * i / d)
pe = np.zeros((4, d)); pe[:, 0::2] = np.sin(ang); pe[:, 1::2] = np.cos(ang)
print("PE (pos 0-3, d_model=8)"); print(pe)
def rot(v, m, th=1.0):
    c, s = np.cos(m * th), np.sin(m * th)
    return np.array([c * v[0] - s * v[1], s * v[0] + c * v[1]])
q = np.array([1.0, 2.0]); k = np.array([3.0, 1.0])
for m, n in [(2, 1), (5, 4), (2, 0)]:
    print(f"m={m} n={n} m-n={m-n} q.k={rot(q, m) @ rot(k, n):.3f}")
python3 pe.py를 실행한 전체 출력은 다음과 같습니다.
PE (pos 0-3, d_model=8)
[[ 0.     1.     0.     1.     0.     1.     0.     1.   ]
 [ 0.841  0.54   0.1    0.995  0.01   1.     0.001  1.   ]
 [ 0.909 -0.416  0.199  0.98   0.02   1.     0.002  1.   ]
 [ 0.141 -0.99   0.296  0.955  0.03   1.     0.003  1.   ]]
m=2 n=1 m-n=1 q.k=-1.506
m=5 n=4 m-n=1 q.k=-1.506
m=2 n=0 m-n=2 q.k=-6.627
위 행렬에서 첫 번째 행인 위치 0(pos=0)은 사인과 코사인이 번갈아 나오므로 [0. 1. 0. 1. ...]가 되며, 앞쪽 열은 위치가 커질 때 값이 크게 바뀌는 반면 뒤쪽 열은 아주 천천히 변하는 것을 볼 수 있습니다.
학습형 위치 임베딩과는 무엇이 다릅니까?
한 줄 답: 학습형 위치 임베딩은 최대 길이까지의 위치마다 가중치 벡터를 학습하지만, 사인·코사인 방식은 별도 학습 파라미터 없이 고정된 공식으로 값을 계산합니다.
위치 정보를 넣는 또 다른 방법은 각 위치(0번, 1번, 2번 등)마다 고유한 벡터를 두고, 모델 학습 과정에서 그 값을 함께 학습시키는 학습형 위치 임베딩(learned positional embeddings)입니다. 이 방식은 정해진 최대 시퀀스 길이까지 위치별 벡터를 학습합니다.
원래 트랜스포머 논문의 실험에서는 학습형 위치 임베딩과 사인·코사인 위치 인코딩이 거의 동일한 결과(“nearly identical results”)를 냈습니다. 그럼에도 저자들이 사인·코사인 방식을 선택한 이유는, 고정된 주기 함수를 쓰면 학습 중에 본 것보다 더 긴 시퀀스 길이로도 모델이 외삽할 수 있을 것(“may allow the model to extrapolate to sequence lengths longer than the ones encountered during training”)이라 판단했기 때문입니다.
학습형 절대 위치, 사인·코사인 위치 인코딩, 그리고 이어서 살펴볼 RoPE의 차이를 표로 비교하면 다음과 같습니다.
| 방식 | 값이 정해지는 방법 | 위치 정보를 넣는 곳 |
|---|---|---|
| 학습형 절대 위치 | 학습 | 임베딩에 더함 |
| 사인·코사인 | 공식 | 임베딩에 더함 |
| RoPE | 공식(회전) | Q·K에 곱함(회전) |
RoPE란 무엇입니까?
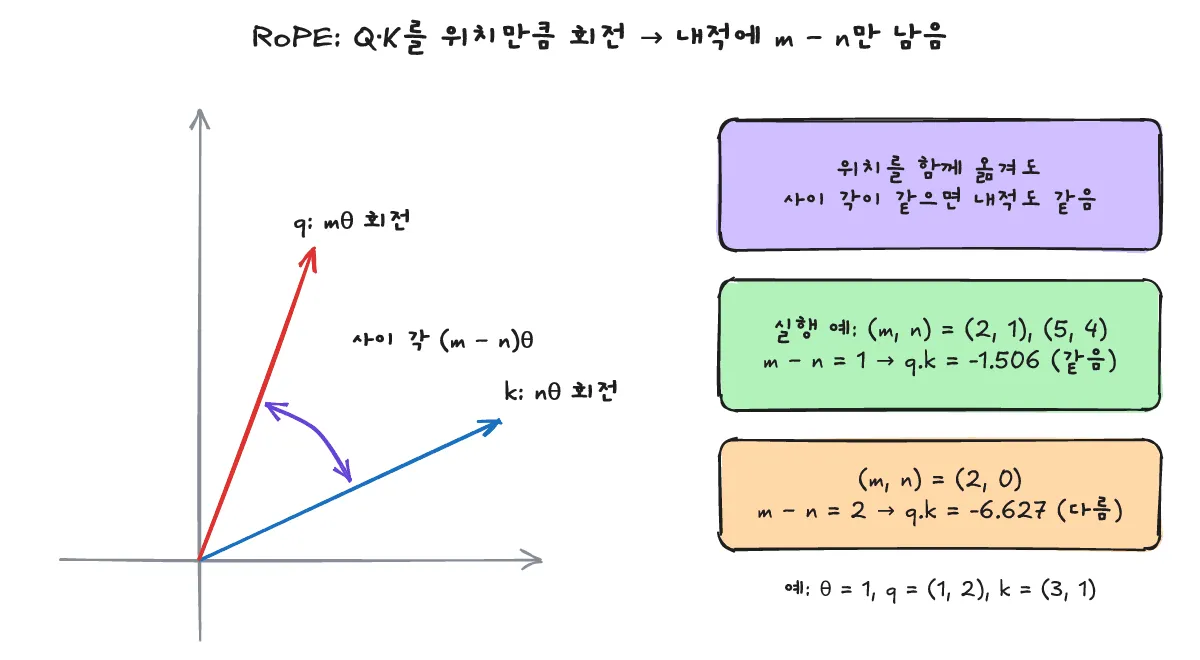
한 줄 답: RoPE(Rotary Position Embedding)는 위치에 비례하는 각도로 Query와 Key 벡터를 회전시켜, 두 벡터의 내적 결과에 상대 위치(m − n)만 남게 하는 방식입니다.
Su et al., “RoFormer: Enhanced Transformer with Rotary Position Embedding” 논문에 따르면, RoPE는 회전 행렬(rotation matrix)로 절대 위치를 인코딩하는 동시에 Self-Attention 수식 안에 명시적인 상대 위치 의존성을 포함시킵니다(“encodes the absolute position with a rotation matrix and meanwhile incorporates the explicit relative position dependency in self-attention”).
먼저 2차원 평면에서 위치 m의 회전 수식은 복소수 표기로 다음과 같이 나타냅니다.
f(x, m) = (W x)·e^(i m θ)위치 m의 Query 벡터 q를 mθ만큼 회전시키고, 위치 n의 Key 벡터 k를 nθ만큼 회전시키면, 두 벡터 사이의 각도는 (m − n)θ만큼만 달라집니다. 따라서 두 벡터의 내적인 q_mᵀ k_n은 오직 상대 위치인 m − n에만 의존하게 됩니다.
일반적인 d차원에서는 전체 차원을 d/2개의 2차원 쌍으로 나눈 뒤, 각 쌍 i를 m·θ_i 각도로 회전시킵니다.
θ_i = 10000^(−2(i−1)/d)즉 임베딩에 위치 벡터를 더하는 가산(additive) 방식이 아니라, 직교 행렬인 회전 행렬을 곱하는 승산(multiplicative) 방식입니다. 앞서 실행한 pe.py 출력의 마지막 세 줄을 다시 보면 이 성질을 바로 확인할 수 있습니다.
m=2 n=1 m-n=1 q.k=-1.506
m=5 n=4 m-n=1 q.k=-1.506
m=2 n=0 m-n=2 q.k=-6.627
절대 위치가 (m=2, n=1)일 때와 (m=5, n=4)일 때는 위치 자체는 다르지만 상대 거리 m − n이 1로 같기 때문에 회전 후 내적 값(q.k)이 -1.506으로 정확히 같습니다. 반면 상대 거리가 m − n = 2인 (m=2, n=0)에서는 내적 값이 -6.627로 달라집니다.
요즘 LLM은 왜 RoPE를 많이 씁니까?
한 줄 답: 임베딩에 값을 더하지 않고도 어텐션 내적에 상대 위치를 직접 반영할 수 있고, 긴 문맥 확장에 관한 논의가 활발하기 때문으로 설명됩니다.
요즘 공개된 여러 LLM에서 RoPE를 채택하는 이유는 다음과 같은 구조적 특성으로 설명됩니다.
- 어텐션 점수에 상대 위치 직접 반영: 입력 임베딩에 위치 벡터를 따로 더하지 않고 어텐션 단계의 Q와 K에만 적용하며, 내적 결과에 상대 위치(
m − n)가 직접 나타나는 구조로 설명됩니다. - 벡터 크기 보존: 직교 행렬(orthogonal matrix)을 통한 회전 연산이므로 벡터의 길이(크기)를 바꾸지 않는다는 점이 특징으로 꼽힙니다.
- RoFormer 논문이 제시한 성질: RoFormer 논문 초록에서는 시퀀스 길이의 유연성(flexibility of sequence length), 상대 거리가 멀어질수록 토큰 간 의존도가 줄어드는 성질(decaying inter-token dependency with increasing relative distance), 그리고 선형 Self-Attention에 상대 위치 인코딩을 결합할 수 있다는 점을 주요 특성으로 제시합니다.
- 문맥 길이 확장 논의: RoPE를 바탕으로 문맥 길이를 늘리려는 논의가 많습니다.
다만 어떤 위치 인코딩 방식이 가장 적합한지는 모델 구조와 학습 설정에 따라 달라지므로, 하나의 방식이 모든 경우에 정답이 되는 것은 아닙니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 위치 인코딩 제거 시의 영향, 거리 비례 페널티를 주는 ALiBi 방식, 그리고 RoPE를 V(값) 벡터에는 적용하지 않는 이유를 정리합니다.
위치 인코딩을 빼면 어떻게 됩니까?
Self-Attention 자체에는 순서 정보가 없으므로 위치 인코딩을 완전히 빼면 단어 순서가 바뀌어도(예: “개가 사람을 물었다”와 “사람이 개를 물었다”) 위치 차이를 구분하지 못해 토큰별 어텐션 계산 결과가 어순 변화를 반영하지 못하게 됩니다.
ALiBi는 무엇입니까?
임베딩에 위치 벡터를 더하는 대신, 두 토큰 사이의 거리에 비례하는 페널티 값을 어텐션 점수에 직접 더하는 방식입니다.
RoPE는 V(값)에도 적용합니까?
적용하지 않습니다. RoFormer 수식에서 회전은 내적을 계산하는 Q(Query)와 K(Key)에만 적용하며, 토큰의 내용을 전달하는 V(Value)에는 적용하지 않습니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 위치 인코딩과 함께 동작하는 Self-Attention, 트랜스포머 구조, 토큰과 컨텍스트 윈도우, 임베딩 개념을 다룬 글입니다.
- Self-Attention이란? Q·K·V로 토큰 비중 매기는 법
- 트랜스포머 구조 정리 글
- 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유
- 임베딩(Embedding)이란? 단어를 벡터로 바꿔 의미를 비교하는 원리
출처는 어디입니까?
한 줄 답: 사인·코사인 위치 인코딩을 제안한 트랜스포머 원 논문과 RoPE를 제안한 RoFormer 논문 및 코드 실행 환경입니다.
- Vaswani et al., “Attention Is All You Need” (확인 2026-11-02)
- Su et al., “RoFormer: Enhanced Transformer with Rotary Position Embedding” (확인 2026-11-02)
- 실행 환경: Python 3.13.5, NumPy 2.5.4 (2026-11-02)