**빔 서치(Beam Search)**는 언어 모델이 다음 토큰의 확률 분포에서 문장을 만들어 갈 때, 당장 눈앞의 최고 확률 토큰 하나만 고르는 그리디 디코딩의 한계를 보완하기 위해 쓰는 탐색 방법입니다. 이 글에서는 빔 폭과 누적 확률, 길이 패널티, 반복 문제, 그리고 번역·요약과 달리 대화형 챗봇에서 샘플링을 더 많이 쓰는 이유를 차례대로 살펴봅니다.
핵심 요약
빔 서치(Beam Search)는 매 단계 확률이 가장 높은 토큰 하나만 고르는 그리디 디코딩과 달리, 누적 확률이 높은 상위 k개 후보 문장을 동시에 키워 가다가 마지막에 가장 점수가 높은 문장을 고르는 디코딩 방법입니다. 그래서 첫 토큰의 확률은 낮아도 뒤가 좋은 문장을 찾을 수 있지만, 가장 좋은 문장을 반드시 찾는다는 보장은 없습니다. 확률을 곱하면 긴 문장이 불리해지기 때문에 길이 패널티로 보정합니다. 번역·요약처럼 정답 범위가 좁은 작업에는 잘 맞고, 대화나 이야기처럼 열린 생성에서는 반복되고 밋밋해지기 쉬워 샘플링이 더 많이 쓰입니다.
빔 서치(Beam Search)란 무엇입니까?
한 줄 답: 매 단계에서 누적 확률이 높은 상위 k개 후보 문장(빔)을 유지하다가 마지막에 전체 점수가 가장 높은 문장을 고르는 디코딩 방법입니다.
자기회귀(autoregressive) 언어 생성에서 한 단어 시퀀스의 전체 확률은 단계별 조건부 다음 단어 확률들의 곱으로 계산됩니다. 빔 서치(Beam Search)는 매 시간 단계마다 가장 가능성 높은 후보 문장 k개를 동시에 추적한 뒤, 최종적으로 전체 확률이 가장 높은 가설(hypothesis)을 선택하는 방식입니다.
- 빔(beam): 탐색 과정에서 유지하고 있는 후보 문장(시퀀스) 하나를 뜻합니다.
- 빔 폭(beam width, k): 매 단계마다 버리지 않고 남겨 두는 후보 문장의 개수입니다.
- 문장 점수(누적 확률): 각 단계에서 선택된 토큰 확률들의 곱이며, 실제 구현에서는 수치 안정을 위해 로그 확률의 합(로그 가능도)으로 계산합니다.
모델이 글자를 세는 단위인 토큰의 개념은 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유에서 다룹니다. 디코드 단계에서 토큰을 한 번에 하나씩 이어 붙이는 추론 과정은 Day3: LLM 추론 구조와 KV Cache에 정리되어 있습니다. 또한 그리디 디코딩과 확률적 샘플링의 기본 차이 및 Temperature가 0에 가까워질 때 샘플링이 그리디와 같아지는 원리는 Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유를 참고하시기 바랍니다.
그리디 디코딩은 왜 더 좋은 문장을 놓칩니까?
한 줄 답: 매 단계에서 당장 확률이 가장 높은 토큰 하나만 확정하기 때문에, 첫 토큰 확률은 조금 낮아도 뒤이어 높은 확률이 나오는 전체 문장을 볼 수 없습니다.
그리디 디코딩(greedy decoding)은 매 단계에서 조건부 확률이 가장 높은 단어 하나만 고르고 나머지는 즉시 버립니다. 가장 큰 단점은 첫 번째 단어의 확률이 다소 낮더라도 그 뒤에 아주 높은 확률의 단어가 이어지는 전체 문장을 아예 탐색하지 못한다는 점입니다.
아래 코드는 이 글의 실행 환경(Python 3.13.5)에서 실행한 결과입니다. 코드와 본문에 쓰인 모든 확률은 설명을 위해 손으로 직접 정한 값이며 실제 모델 출력이 아닙니다(구조는 Hugging Face 블로그의 디코딩 방법 글에 나오는 스케치 아이디어를 따랐습니다).
# 장난감 예: 2단계 생성, 확률은 설명용으로 직접 정한 값(실제 모델 아님)
step1={"A":0.5,"B":0.4,"C":0.1}
step2={"A":{"x":0.4,"y":0.35,"z":0.25},"B":{"x":0.9,"y":0.05,"z":0.05},"C":{"x":0.5,"y":0.3,"z":0.2}}
g1=max(step1,key=step1.get); g2=max(step2[g1],key=step2[g1].get)
print(f"greedy: {g1}{g2} p={step1[g1]*step2[g1][g2]:.2f}")
for k in (2,):
    beams=sorted(step1.items(),key=lambda t:-t[1])[:k]
    cand=[(a+b,pa*pb) for a,pa in beams for b,pb in step2[a].items()]
    best=sorted(cand,key=lambda t:-t[1])[:k]
    print(f"beam k={k}: "+", ".join(f"{s} p={p:.2f}" for s,p in best))
greedy: Ax p=0.20
beam k=2: Bx p=0.36, Ax p=0.20단계별 계산 과정을 따라가 보면 두 방식의 차이가 분명하게 드러납니다.
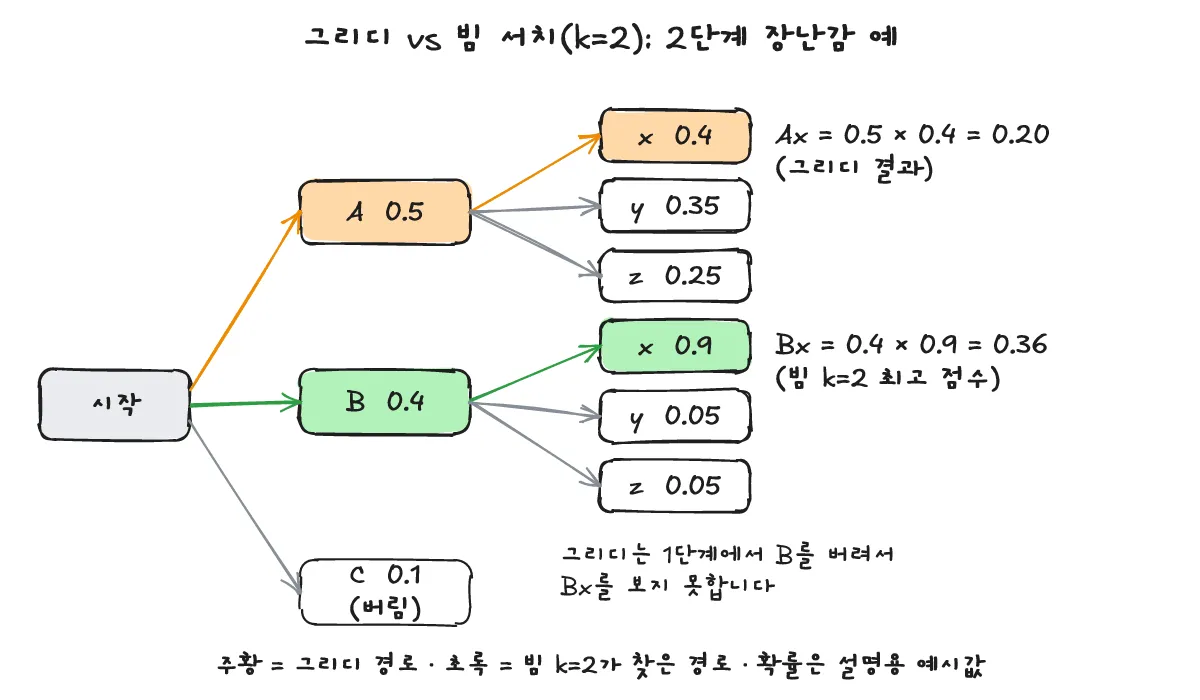
- 1단계 후보 확률(설명용 예시값): 첫 토큰 후보는
A0.5,B0.4,C0.1입니다. - 그리디 디코딩의 선택: 1단계에서 확률이 가장 높은
A만 남기고B와C는 버립니다. 2단계에서는A뒤의 후보x0.4,y0.35,z0.25(모두 설명용 예시값) 가운데 가장 큰x를 고릅니다. 최종 결과는Ax이며 누적 확률은 0.5 × 0.4 = 0.20(설명용 예시값)입니다. - 빔 서치(k=2)의 선택: 1단계에서 상위 두 후보인
A와B를 모두 살려 둡니다.B뒤에 이어지는 후보는x0.9,y0.05,z0.05(모두 설명용 예시값)이므로,Bx의 누적 확률은 0.4 × 0.9 = 0.36(설명용 예시값)이 되어Ax의 0.20(설명용 예시값)을 앞섭니다. 그리디는 1단계에서B를 버렸기 때문에Bx경로를 끝내 보지 못합니다.
빔 폭 k는 무엇을 바꿉니까?
한 줄 답: k가 커질수록 더 많은 후보 경로를 살려 두어 점수가 높은 문장을 찾을 가능성이 커지지만 단계마다 계산량도 함께 늘어나며, k=1이면 그리디 디코딩과 같습니다.
빔 폭 k는 한 걸음 앞을 내다볼 때 몇 개의 갈래를 동시에 유지할지 결정합니다. k가 커지면 후보가 늘어나 더 높은 누적 확률을 가진 문장을 발견할 가능성이 커지지만, 매 단계마다 k개 후보에 이어질 다음 토큰들을 모두 점수 매겨야 하므로 계산량도 k에 따라 늘어납니다.
num_beams설정: Transformers 라이브러리에서는 빔 폭을num_beams매개변수로 지정합니다. 빔 서치가 동작하려면num_beams가 1보다 커야 하며,num_beams=1(즉 k=1)로 두면 후보를 하나만 유지하므로 그리디 디코딩과 똑같아집니다.- 최적 문장 보장 여부: 빔 서치는 그리디보다 숨어 있는 고확률 시퀀스를 놓칠 위험을 줄여 주지만, 가능한 모든 문장 가운데 확률이 가장 높은 문장을 반드시 찾아낸다는 보장은 없습니다.
num_return_sequences: 최종적으로 상위 여러 개의 빔을 돌려받고 싶을 때 사용하며, 그 값은num_beams이하여야 합니다. 다만 반환된 상위 빔들은 서로 아주 미세한 표현만 다른 경우가 많습니다.early_stopping:True로 설정하면 모든 빔 가설이 문장 종료(EOS) 토큰에 도달했을 때 생성을 마칩니다. 문서에 따르면"never"로 설정할 수도 있는데, 이 경우 더 나은 후보가 나올 수 없을 때만 멈추는 정통(canonical) 빔 서치 방식으로 동작합니다.
길이 패널티는 왜 필요합니까?
한 줄 답: 1보다 작은 확률을 계속 곱하면 문장이 길어질수록 점수가 작아져 짧은 문장이 유리해지므로, 문장 길이의 거듭제곱으로 점수를 나누어 보정해야 합니다.
각 단계의 토큰 확률은 모두 1보다 작은 값입니다. 따라서 문장이 한 단계씩 길어질 때마다 1보다 작은 숫자를 계속 곱하게(로그 확률로는 음수를 계속 더하게) 되므로, 별다른 보정이 없으면 일찍 끝나는 짧은 문장이 긴 문장보다 구조적으로 더 높은 점수를 받게 됩니다.
이 문제를 보정하기 위해 빔 기반 생성에서는 문장 길이의 거듭제곱으로 시퀀스 점수를 나누는 지수 형태 패널티를 적용합니다. Transformers 라이브러리의 GenerationConfig 문서에 따르면 length_penalty 매개변수가 이 역할을 담당합니다. 시퀀스 점수가 음수인 로그 가능도(log likelihood)로 계산되기 때문에, length_penalty > 0으로 주면 긴 시퀀스가 더 잘 선택되도록 장려하고, length_penalty < 0으로 주면 짧은 시퀀스가 선택되도록 유도합니다.
대화형 챗봇은 왜 샘플링을 더 많이 씁니까?
한 줄 답: 열린 대화에서는 답변 길이를 미리 정하기 어렵고 빔 서치를 쓰면 표현이 반복되거나 뻔해지기 쉬워, 다양성을 주는 샘플링이 더 자연스럽기 때문입니다.
번역이나 요약과 달리 대화나 이야기 짓기 같은 열린 생성(open-ended generation)에서는 빔 서치가 최선이 아닌 경우가 많습니다. Hugging Face 블로그의 디코딩 방법 글에서는 그 이유를 세 가지로 정리합니다.
- 예측하기 어려운 출력 길이: 기계 번역이나 요약은 입력에 따라 원하는 출력 길이가 비교적 예측 가능하지만, 대화나 이야기 생성은 상황에 따라 필요한 답변 길이가 크게 달라집니다.
- 심한 반복 생성: 그리디와 빔 서치 모두 똑같은 구절을 되풀이하는 반복 문제가 자주 나타납니다. 특히 이야기 생성에서는 패널티만으로 이 반복을 자연스럽게 제어하기가 어렵습니다.
- 지나치게 뻔한 문장: 자연스러운 사람의 글은 매번 확률이 가장 높은 단어만 따라가지 않습니다(Holtzman et al., 2019). 읽는 사람은 뻔하고 예측 가능한 문장보다 적당히 뜻밖의 자연스러운 표현을 원합니다.
반복을 막기 위해 같은 n-그램이 두 번 나오지 못하게 막는 no_repeat_ngram_size(n-그램 패널티)를 쓸 수 있지만 주의가 필요합니다. 예를 들어 도시 "New York"에 관한 글을 생성할 때 2-그램 패널티를 걸면, 글 전체에서 그 도시 이름을 단 한 번밖에 쓸 수 없게 됩니다.
한편 Hugging Face 블로그의 결론에서도 짚듯, 열린 생성에서는 Top-p나 Top-k 샘플링이 그리디와 빔 서치보다 더 유창한 글을 만들어 내는 경향이 있지만, 반복 결함이 디코딩 방식 자체보다 모델과 학습 목표에서 비롯된다는 연구(Welleck et al., 2019)도 있으며 샘플링 역시 반복을 겪을 수 있습니다(Welleck et al., 2020). 결국 모든 상황에 다 맞는 단일 디코딩 방법은 없습니다.
빔 서치는 언제 쓰는 것이 맞습니까?
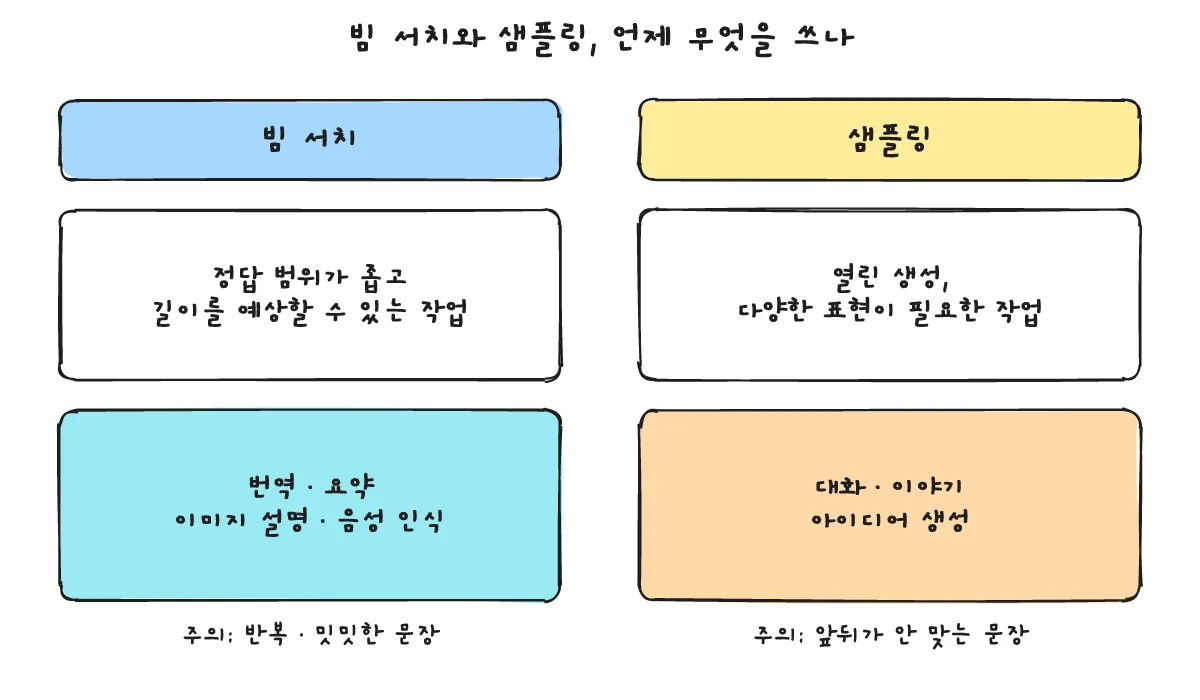
한 줄 답: 번역, 요약, 이미지 설명, 음성 인식처럼 입력에 정답 범위가 묶여 있고 출력 길이가 비교적 예측 가능한 작업에 적합합니다.
Transformers 라이브러리 문서에서도 정리하듯, 그리디 탐색은 라이브러리의 기본 디코딩 전략으로서 창의성이 중요하지 않은 짧은 출력에는 쓸 수 있지만 시퀀스가 길어지면 자기 자신을 반복하기 시작합니다. 반면 빔 서치는 앞을 내다보며 전체 확률이 높은 시퀀스를 고를 수 있어 입력에 기반한(input-grounded) 작업에 잘 맞고, 샘플링(do_sample=True, num_beams=1)은 반복을 줄이고 더 창의적이고 다양한 출력을 내는 데 적합합니다.
| 구분 | 빔 서치 (Beam Search) | 샘플링 (Sampling) |
|---|---|---|
| 주요 목표 | 상위 k개 후보 경로를 비교해 전체 누적 확률이 높은 시퀀스 탐색 | 확률 분포에서 무작위로 추출해 표현의 다양성과 창의성 확보 |
| 잘 맞는 작업 | 기계 번역, 문서 요약, 이미지 설명(캡셔닝), 음성 인식 등 입력에 강하게 묶이고 길이가 예측 가능한 작업 | 대화, 이야기 생성 등 정답 범위가 열려 있고 길이가 가변적인 생성 작업 |
| 주의할 점 | 열린 생성에서 반복이 심해지거나 문장이 밋밋해지기 쉬움, 빔 폭에 따른 계산 부담 | 낮은 확률의 토큰이 뽑히면 맥락에서 벗어날 수 있으며 샘플링에서도 반복이 나타날 수 있음 |
자주 묻는 질문은 무엇입니까?
한 줄 답: 추측 디코딩과의 차이, 샘플링과의 조합 가능 여부, 그리고 최고 문장 보장 여부에 관한 질문 세 가지를 정리합니다.
빔 서치와 추측 디코딩은 같은 것입니까?
아닙니다. 빔 서치는 여러 후보 문장을 비교해 더 높은 점수의 문장을 찾으려는 탐색 전략이고, 추측 디코딩(Speculative Decoding)은 작은 모델이 초안을 쓰고 큰 모델이 한꺼번에 검증해 큰 모델의 분포를 유지하면서 생성 속도를 높이는 기법입니다. 자세한 원리는 추측 디코딩(Speculative Decoding)이란? 작은 모델이 초안을 쓰면 LLM 답변이 빨라지는 이유에서 다룹니다.
빔 서치와 샘플링을 함께 쓸 수 있습니까?
네, 함께 쓸 수 있습니다. Transformers 라이브러리에서 num_beams를 1보다 크게 두고 do_sample=True를 켜면 두 방식을 결합할 수 있지만, 이 경우에도 단계 사이마다 확률이 낮은 시퀀스를 쳐내는 가지치기(pruning)는 여전히 일어납니다.
빔 서치를 쓰면 항상 가장 좋은 문장이 나옵니까?
아닙니다. 빔 서치는 유지하는 k개 후보 안에서 그리디보다 높은 확률의 문장을 찾을 뿐 전체에서 가장 확률이 높은 문장을 반드시 찾는다고 보장하지 않으며, 확률이 가장 높은 문장이 사람에게 가장 자연스러운 글과 항상 일치하지도 않습니다(Holtzman et al., 2019).
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 디코딩 전략(Temperature·Top-p), 토큰과 컨텍스트 윈도우, 추론 구조와 KV 캐시, 추측 디코딩, 어텐션 계산 구조를 다룬 관련 글 목록입니다.
- Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유
- 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유
- Day3: LLM 추론 구조와 KV Cache
- 추측 디코딩(Speculative Decoding)이란? 작은 모델이 초안을 쓰면 LLM 답변이 빨라지는 이유
- 「어텐션 없는 언어 모델이 가능할까? Self-Attention 계산이 문장 길이 제곱으로 늘어나는 이유와 대안」(관련 글)
출처는 어디입니까?
한 줄 답: 이 글에서 확인한 공식 문서와 기술 블로그, 그리고 코드 실행 환경입니다.
- Hugging Face 블로그: How to generate text: using different decoding methods for language generation with Transformers (확인 2026-11-02)
- Hugging Face Transformers 문서: Generation strategies (확인 2026-11-02)
- Hugging Face Transformers 문서: Generation (GenerationConfig) (확인 2026-11-02)
- 박스 실측: Python 3.13.5, 2026-11-02