**추측 디코딩(speculative decoding)**은 작은 초안 모델(draft model)이 다음에 올 토큰 여러 개를 먼저 추측해 두고, 큰 모델이 이를 한 번에 검증하여 LLM 답변 생성 속도를 높이는 추론 기법입니다. 대규모 언어 모델이 토큰을 순서대로 만들 때는 메모리에서 가중치를 읽어 오는 동안 연산 장치가 놀고 있게 되는데, 이 글에서는 전체 계산량이 늘어나는데도 왜 답변이 빨라지는지 그 원리와 한계를 정리합니다.
핵심 요약
추측 디코딩은 작은 초안 모델이 다음 토큰 여러 개를 먼저 추측하고, 큰 모델이 그 초안을 한 번에 검증해 자기가 냈을 토큰만 받아들이는 방법입니다. 전체 계산량은 오히려 늘지만, 한 토큰씩 만들 때 GPU는 가중치를 읽어 오느라 연산 장치가 놀고 있기 때문에 그 남는 연산을 검증에 쓰면 더 빨라집니다. 그래서 요청이 적을 때 효과가 크고, 배치가 크면 이득이 줄어듭니다. 결과 품질은 큰 모델 기준을 따르도록 설계된 방법입니다.
추측 디코딩이란 무엇입니까?
한 줄 답: 추측 디코딩은 작은 초안 모델이 다음 토큰 여러 개를 먼저 제안하고, 큰 모델이 한 번의 전달(forward pass)로 이를 검증해 맞는 토큰만 수락하는 추론 가속 기법입니다.
일반적인 디코딩은 큰 모델이 한 번에 토큰을 하나씩만 순서대로 만들어 냅니다. 반면 추측 디코딩(speculative decoding)은 초안 작성, 검증, 수락 및 거절의 흐름으로 동작합니다.
- 초안 작성(draft): 작고 빠른 초안 모델(draft model)이 다음에 올 토큰 여러 개를 빠르게 제안합니다.
- 검증(verify): 큰 모델(target model)이 초안 모델이 제안한 토큰들을 단 한 번의 전달(forward pass)로 동시에 확인합니다.
- 수락 및 거절(accept/reject): 큰 모델은 자신이 직접 생성했을 토큰들을 그대로 수락하고, 처음으로 거절되는 지점에서는 큰 모델 자신의 토큰으로 바꾼 뒤 그 위치부터 다시 초안 작성을 이어 갑니다.
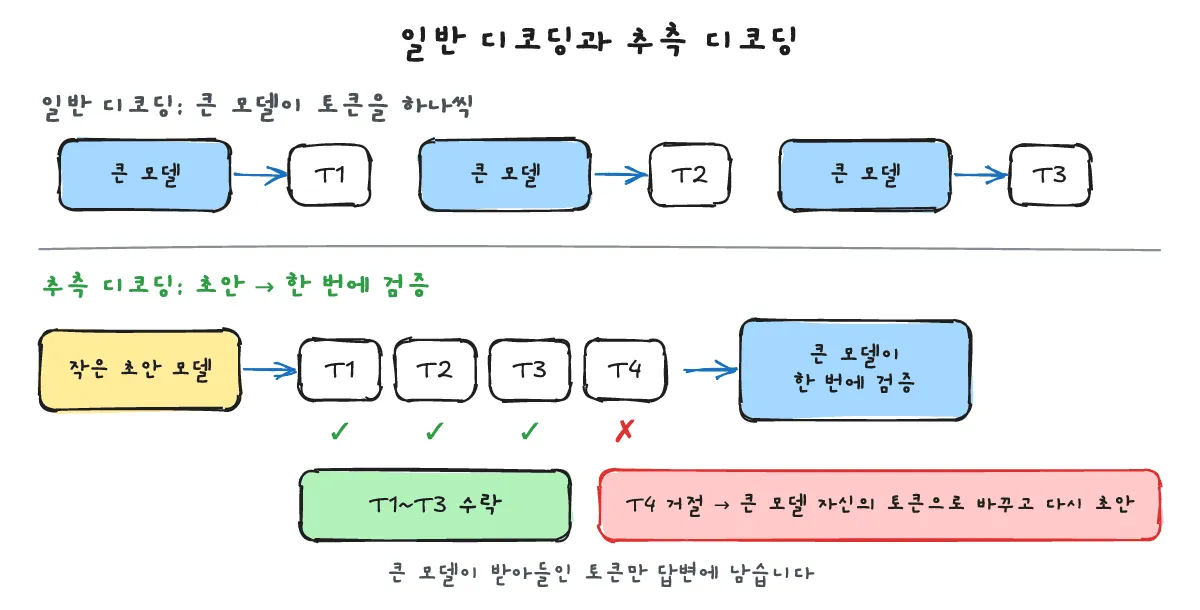
Hacker News에서 화제가 된 글 “Why Is Speculative Decoding Fast?”와 그 원문인 Joe Barrow의 Why Is Speculative Decoding Fast?에서도 이 초안 및 검증 구조를 바탕으로 왜 실제 응답이 빨라지는지를 설명하고 있습니다.
계산이 늘어나는데 왜 빨라집니까?
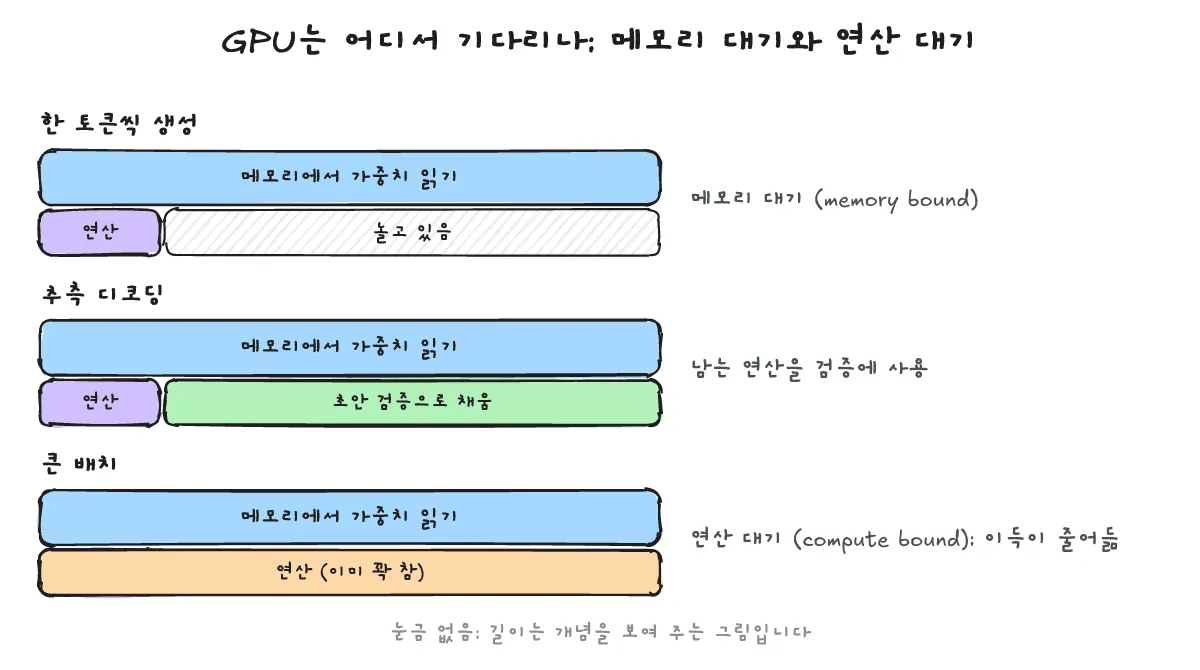
한 줄 답: 토큰을 하나씩 만들 때는 GPU가 메모리에서 가중치를 읽어 오느라 연산 장치가 놀고 있는데(memory bound), 남는 연산 자원으로 초안 토큰 여러 개를 한 번에 검증하기 때문입니다.
초안 모델을 따로 실행하고 거절될 수도 있는 토큰까지 검증하므로 전체 계산량은 오히려 늘어납니다. 그럼에도 전체 시간이 줄어드는 이유는 단일 토큰 생성 단계가 연산 능력 부족(compute bound)이 아니라 메모리 읽기 대기(memory bound) 상태에 묶여 있기 때문입니다.
큰 모델이 토큰을 하나 만들 때마다 GPU는 모델 가중치를 메모리에서 읽어 와야 합니다. 이때 대부분의 시간은 가중치를 옮기는 데 쓰이고 정작 연산 장치는 할 일이 없어 놀게 됩니다. 비유하자면 배송 트럭이 상자 하나만 싣고 가든 상자 여러 개를 함께 싣고 가든 이동 시간은 거의 같은 것과 비슷합니다. 가중치를 메모리에서 읽어 오는 과정이 트럭의 이동이라면, 추측 디코딩은 비어 있는 트럭 적재 공간에 초안 토큰 여러 개를 실어 한 번의 이동 동안 함께 검증하는 셈입니다.
한편 추측 디코딩은 이전 토큰의 연산 결과를 재사용하는 KV 캐시를 대체하는 기법이 아니며 함께 동작하는데, 기본 추론 과정과 캐시 구조는 「Day3: LLM 추론 구조와 KV Cache」 글에서 확인할 수 있습니다.
언제 효과가 없습니까?
한 줄 답: 동시 요청 묶음(배치)이 커서 이미 연산 장치가 가득 차 있거나(compute bound), 초안 모델이 자주 틀려 수락률이 낮을 때는 효과가 줄어듭니다.
추측 디코딩이 항상 빠른 것은 아니며, 다음과 같은 상황에서는 이득이 줄어듭니다.
- 배치가 클 때(compute bound): 동시에 처리하는 요청 묶음이 커지면 GPU 연산 장치가 이미 가득 차서 돌아가므로, 검증에 쓸 남는 연산 여유가 사라져 속도 이득이 줄어듭니다.
- 초안이 자주 틀릴 때(낮은 수락률): 초안 모델이 제안한 토큰이 큰 모델의 검증에서 자주 거절되면, 거절된 토큰을 만들고 검증한 계산이 그대로 낭비가 됩니다.
이러한 특성 때문에 서빙 엔진에는 배치 크기에 따라 추측 디코딩을 끄는 설정이 존재합니다.
결과 품질은 바뀝니까?
한 줄 답: 원래 추측 디코딩 기법의 설계 기준으로는 큰 모델의 출력 분포를 그대로 따르도록 검증 규칙이 구성되어 있어 결과 품질이 유지됩니다.
작은 초안 모델이 먼저 단어를 고른다고 해서 최종 답변 수준이 작은 모델 수준으로 떨어지지는 않습니다. 원래 추측 디코딩 기법의 설계에서는 큰 모델이 모든 초안 토큰을 직접 검증하고 거절된 위치에서도 큰 모델의 분포를 따라 토큰을 채우도록 검증·수락 규칙이 짜여 있기 때문에, 모든 개별 구현체에 대해 절대적인 보장을 단정할 수는 없으나 원래 설계 기준으로는 큰 모델이 직접 생성했을 출력 분포를 따르게 됩니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 샘플링 설정, 모델 양자화, 로컬 추론 프레임워크와 추측 디코딩의 관계를 정리했습니다.
temperature·top-p와는 어떤 관계입니까?
샘플링 방식과 설정은 그대로 유지되며 검증 단계에서도 해당 분포를 반영합니다. 샘플링 개념 자체는 「Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유」 글에서 다룹니다.
양자화와는 무엇이 다릅니까?
양자화는 모델 가중치 자체를 작게 줄이는 기법이고 추측 디코딩은 모델을 실행하는 방식을 바꾸는 기법이므로 일반적으로 두 기법을 함께 조합해 쓸 수 있습니다. 양자화의 개념은 「양자화(Quantization)란?」 글을 참고할 수 있습니다.
로컬에서도 쓸 수 있습니까?
일부 추론 프레임워크에서 추측 디코딩 기능을 지원하므로 로컬 환경에서도 사용할 수 있습니다. 추론 프레임워크의 기본 개념은 「LLM 추론 프레임워크란?」 글에 정리되어 있습니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: LLM 추론 구조, 샘플링, 모델 경량화 및 하드웨어 차이를 다룬 관련 글입니다.
- 「Day3: LLM 추론 구조와 KV Cache」
- 「Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유」
- 「양자화(Quantization)란?」
- 「LLM 추론 프레임워크란?」
- 「NPU와 GPU 차이점은? 구조·용도·전력으로 쉽게 비교」
출처는 어디입니까?
한 줄 답: 본문 작성에 참고한 원문 글과 커뮤니티 토론 출처입니다.
- Joe Barrow — Why Is Speculative Decoding Fast? (확인 2026-10-28)
- Hacker News — Why Is Speculative Decoding Fast? (확인 2026-10-28)