CNN과 LLM 차이는 이미지 분류 문제를 풀 때 전용 분류기를 쓸지 범용 생성 모델을 쓸지 결정하는 핵심 기준입니다. 이 글에서는 합성곱 신경망(CNN)과 멀티모달 LLM이 피부 병변 사진 분류라는 동일한 과제를 어떻게 다르게 처리하는지 모델 구조와 학습 방식 관점에서 정리합니다.
핵심 요약
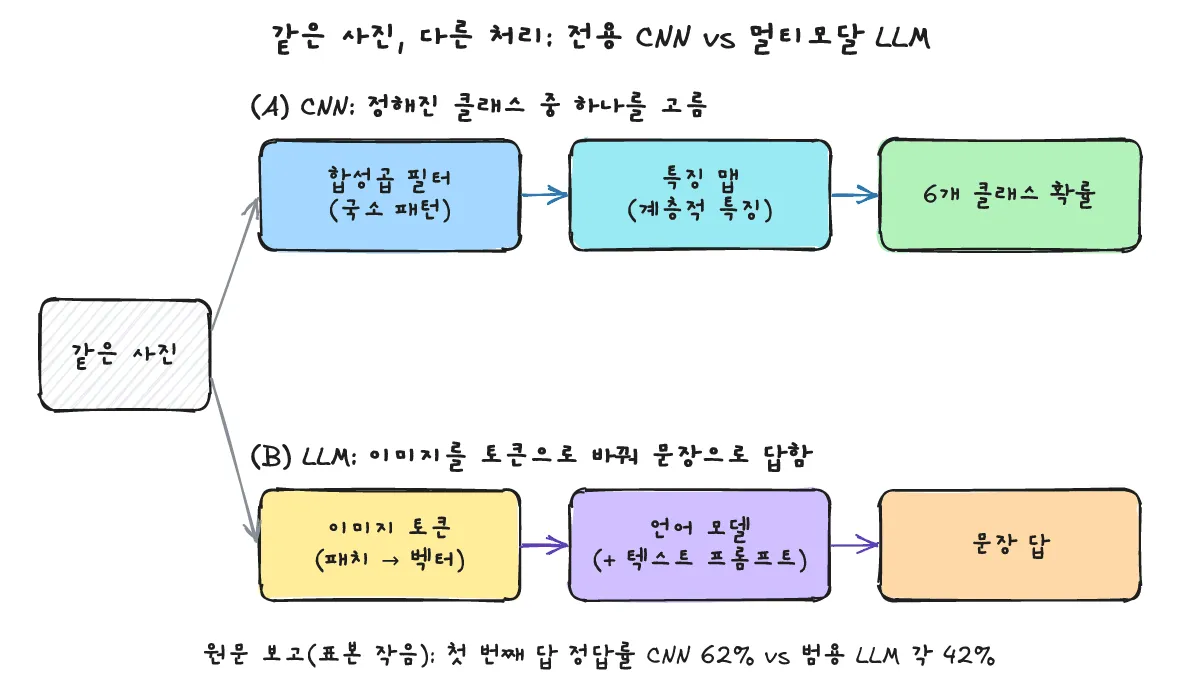
CNN은 합성곱 필터로 이미지의 국소 패턴을 계층적으로 뽑아 정해진 클래스 중 하나를 고르도록 학습된 전용 모델이고, 멀티모달 LLM은 이미지를 토큰으로 바꿔 언어 모델이 문장으로 답하는 범용 모델입니다. 한 피부과 전문의가 생검으로 확인된 병변 200개로 비교한 결과, 파인튜닝한 CNN(Inception v3)이 6개 진단 중 첫 번째 답 정답률 62%로 범용 LLM 두 개(각각 42%)보다 높았다고 보고했습니다. 다만 표본이 작고 LLM은 한 번씩만 실행되었으며, 최신 전용 모델과의 비교도 아닙니다.
CNN과 LLM 차이는 무엇입니까?
한 줄 답: CNN은 정해진 클래스 중 하나를 고르도록 학습된 이미지 전용 모델이고, 멀티모달 LLM은 이미지를 토큰으로 바꿔 문장으로 답하는 범용 모델입니다.
전용 분류 모델과 범용 생성 모델의 구조 비교
이미지 분류 과제에서 전용 모델인 합성곱 신경망(CNN)은 입력 사진에서 시각적 특징을 뽑아 사전에 정의된 라벨 중 하나로 매핑하는 데 집중합니다. 반면 멀티모달 LLM은 이미지와 텍스트를 함께 입력받아 자유로운 문장 형태로 응답을 생성하도록 설계된 범용 모델입니다.
| 구분 | CNN(전용) | 멀티모달 LLM(범용) |
|---|---|---|
| 입력 처리 | 합성곱 필터 | 이미지 토큰 |
| 출력 | 고정 클래스 확률 | 문장 |
| 학습 데이터 | 해당 도메인 | 폭넓은 일반 데이터 |
| 강점 | 좁고 정확한 분류 | 설명·대화·여러 작업 |
CNN은 이미지를 어떻게 봅니까?
한 줄 답: 작은 필터가 이미지 위를 이동하며 국소 패턴을 감지하고, 깊어지는 층이 이를 결합해 고수준 특징으로 만든 뒤 클래스별 확률을 계산합니다.
합성곱 필터와 계층적 특징 추출
CNN의 합성곱 필터는 사진의 작은 영역을 훑으며 윤곽선이나 질감 같은 국소 패턴을 찾아내는 역할을 합니다. 신경망의 층이 깊어질수록 앞선 층에서 찾은 단순한 패턴들이 결합되어 형태나 부위 같은 고수준 특징으로 발전하며, 풀링(pooling) 연산이 공간 크기를 줄여 연산 효율을 높이고 마지막 출력층이 정해진 각 클래스에 대한 확률을 내놓습니다.
전이학습과 파인튜닝
전용 분류기를 만들 때는 처음부터 학습하기보다 일상 사진으로 미리 학습된 모델을 가져와 목표 도메인 이미지로 다시 학습시키는 전이학습(파인튜닝) 방식을 주로 사용합니다. 다만 도메인 데이터 규모가 작을 때 무리하게 재학습하면 학습 데이터에만 과도하게 맞춰지는 과적합 위험이 있으므로, 이에 대한 원리와 대책은 과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법 글에서 자세히 다룹니다.
LLM은 이미지를 어떻게 봅니까?
한 줄 답: 이미지 인코더가 사진을 패치 단위로 나누고 토큰으로 변환하면, 언어 모델이 이를 텍스트 프롬프트와 함께 읽어 문장으로 답을 생성합니다.
이미지 패치·토큰 변환과 문장 생성
멀티모달 LLM은 사진을 그대로 합성곱 필터에 넣는 대신, 이미지를 작은 패치로 분할한 뒤 각 패치를 벡터 형태의 이미지 토큰으로 변환합니다. 언어 모델은 이 이미지 토큰들을 사용자가 입력한 텍스트 프롬프트와 함께 읽어들인 뒤, 다음에 올 단어를 예측하는 방식으로 문장 답을 생성합니다.
따라서 프롬프트로 선택지를 강제하지 않는 한 LLM의 기본 출력은 고정된 클래스 확률 분포가 아니라 자유 형식의 텍스트입니다. 같은 사진을 입력했을 때 CNN이 필터와 특징 맵을 거쳐 6개 클래스에 대한 확률을 계산하는 흐름과, LLM이 이미지 토큰과 언어 모델을 거쳐 문장 답을 내놓는 흐름의 차이는 아래 구조와 같습니다.
이 실험은 무엇을 비교했습니까?
한 줄 답: 파인튜닝한 Inception v3 CNN과 범용 LLM 두 개에 생검으로 확인된 병변 사진을 동일하게 제시하고, 같은 6개 진단 중 첫 번째 답을 고르게 하여 비교했습니다.
실험 구성과 원문 저자의 보고 결과
원문 저자는 직접 실험을 설계한 피부과 전문의입니다. 공개된 피부과 이미지로 파인튜닝한 CNN(2015년 공개된 Inception v3)과 범용 LLM 두 개를 대상으로, 생검으로 확인된 병변 200개 사진을 보여주고 동일한 후보군에서 진단을 고르게 했습니다. 원문 저자의 보고에 따르면, 6개 진단 중 첫 번째 답 정답률은 파인튜닝한 CNN(Inception v3)이 62%였고 범용 LLM 두 개는 각각 42%였습니다.
해석할 때 주의할 한계점
- 표본이 작습니다.
- 각 LLM은 사례마다 한 번씩만 실행되었으며, 실행할 때마다 답이 달라질 수 있습니다.
- 생검까지 진행한 까다로운 사례만 사용되었습니다.
- 사용된 CNN은 의도적으로 최신 모델이 아니며, 최신·최고 성능 전용 모델과의 비교가 아닙니다.
작은 전용 모델이 이기는 이유는 무엇입니까?
한 줄 답: 바로 그 종류의 이미지로 직접 학습되었고, 정해진 클래스 중 하나만 고르면 되며, 범용 모델이 지닌 특정 답변 선호 경향을 겪지 않기 때문입니다.
도메인 파인튜닝과 고정 클래스 최적화
- 도메인 파인튜닝: 전용 모델은 해당 과제의 도메인 이미지를 반복해서 보며 분류에 필요한 시각적 단서를 직접 학습합니다.
- 고정된 출력 클래스: 자유 문장을 생성할 필요 없이 정해진 후보 클래스 중에서 정답을 고르는 것만 직접 최적화합니다.
- 범용 모델의 선호 답 경향: 원문 저자는 각 LLM이 자주 고르는 ‘선호 답’이 있었다고 관찰했습니다.
- 최적화 목표의 차이: 범용 모델은 하나의 좁은 분류 과제가 아니라 대화, 요약, 설명 등 여러 작업을 두루 다룰 수 있도록 최적화되어 있습니다.
물론 이 결과가 언제나 CNN이 더 낫다는 뜻은 아니며, 더 강력하거나 최신인 전용 모델을 쓰거나 다른 데이터셋을 사용하면 결과는 달라질 수 있습니다. 한편 거대 모델의 지식을 활용해 작고 빠른 전용 모델을 만드는 기법은 지식 증류(Knowledge Distillation)란? 큰 모델로 작은 모델을 학습시킬 때 양자화와 차이에서 확인할 수 있습니다.
그럼 언제 무엇을 써야 합니까?
한 줄 답: 라벨 집합이 명확한 분류·검출에는 전용 모델을 쓰고, 설명·대화·요약에는 LLM을 쓰며, 실무에서는 두 모델을 결합하는 구성이 자주 쓰입니다.
작업 목적별 선택 기준과 결합 구조
- 전용 모델: 정답 클래스가 명확히 고정된 이미지 분류나 객체 검출 작업에 적합합니다.
- 멀티모달 LLM: 분류 결과를 풀어 설명하거나, 보고서 초안을 작성하거나, 자유 형식의 질문과 대화를 처리할 때 강점이 있습니다.
- 결합 구조: 전용 모델이 먼저 이미지를 분류하고, LLM이 그 분류 결과를 받아 사용자에게 설명하거나 정리해 주는 방식(또는 LLM이 전용 분류기를 도구로 호출하는 방식)으로 두 모델의 장점을 합칠 수 있습니다.
의료적 판단은 반드시 전문의에게 받아야 하며, 이 글은 모델 구조를 공부하기 위한 정리입니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: ViT와 CNN의 처리 방식 차이, 전이학습의 정의, 그리고 LLM을 이미지 분류에 쓸 때의 판단 기준을 정리했습니다.
ViT와 CNN은 무엇이 다릅니까?
ViT(Vision Transformer)는 합성곱 필터 대신 이미지를 패치 단위로 쪼갠 뒤 셀프 어텐션(self-attention) 연산으로 처리한다는 점이 CNN과 다릅니다.
전이학습이란 무엇입니까?
대규모 일반 데이터셋으로 미리 학습된 모델을 가져와, 목표하는 작은 도메인 데이터셋에 맞게 다시 학습시켜 재사용하는 방법입니다.
LLM으로 분류하면 안 됩니까?
빠른 프로토타입을 만들거나 라벨링된 데이터가 부족할 때는 유용할 수 있지만, 고정된 라벨 집합과 충분한 학습 데이터가 있다면 전용 분류기를 학습시키는 쪽이 보통 더 자연스러운 선택입니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 작은 모델을 학습시키는 지식 증류, 파인튜닝 시 주의할 과적합, 모델의 신뢰도 보정을 다룬 관련 글입니다.
- 지식 증류(Knowledge Distillation)란? 큰 모델로 작은 모델을 학습시킬 때 양자화와 차이
- 과적합(Overfitting)이란? 학습 손실은 내려가는데 검증 손실이 오를 때 해결 방법
- LLM 신뢰도 점수란? 모델에게 확신도를 물어보면 안 되는 이유와 보정(Calibration)
출처는 어디입니까?
한 줄 답: 이 글에서 살펴본 피부 병변 사진 분류 비교 실험의 토론 링크와 원문 출처 정보입니다.
- Hacker News 토론: 전용 CNN과 범용 LLM의 피부 병변 사진 분류 비교 (확인 2026-11-02)
- 원문: lynchlab.net, Dr Magnus Lynch(2026-10-25 게시, 2026-11-02 열람)