LLM 신뢰도 점수(confidence score)는 질문에 답하는 에이전트를 만들 때 답변을 그대로보낼지, 사람에게 넘길지 결정하기 위해 흔히 찾는 값입니다. 하지만 모델에게 직접 확신도를 물어봐서 얻은 숫자는 그 자체로 믿기 어렵습니다. 왜 그런지, 그리고 보정(calibration)이 무엇인지 정리합니다.
핵심 요약
LLM에게 “얼마나 확신해?”라고 물어서 나온 숫자는 측정값이 아니라, 다른 글자처럼 토큰으로 이어 쓴 문장입니다. 같은 질문을 다시 하거나 말투를 바꾸면 숫자도 바뀝니다. 믿을 수 있는 신뢰도는 “이 점수라고 했을 때 실제로 얼마나 맞았나”를 기록해 맞춰 보는 보정(calibration)을 거쳐야 합니다.
LLM 신뢰도 점수란 무엇이고, “보정됐다”는 무슨 뜻입니까?
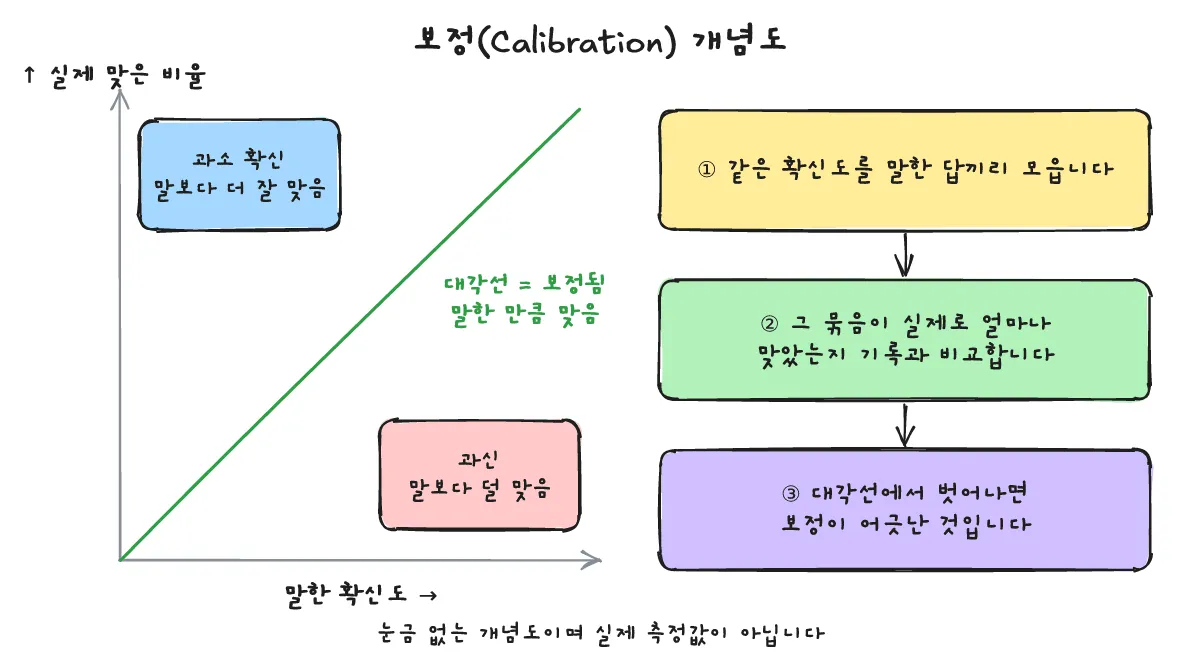
한 줄 답: 예측에 붙인 확신도와 실제로 맞은 비율이 여러 사례에서 일치할 때 그 신뢰도 점수가 보정(calibration)되었다고 합니다.
예보관의 확신도는 오늘 관측한 정보와 과거 기록에서 나옵니다. 같은 정보에 같은 규칙을 적용하면 언제나 같은 확신도가 나와야 합니다. 어떤 확신도가 믿을 만한지는 한 번의 예측만으로는 알 수 없고, 여러 사례를 모아 확인해야 합니다. 같은 확신도를 매긴 사례들을 한데 묶었을 때 실제로 그 일이 일어난 빈도와 비교하는 방식입니다. 말한 확신도와 실제 빈도가 일치하면 보정(calibration)되었다고 하며, 말한 것보다 덜 일어났다면 과신(overconfidence), 더 자주 일어났다면 과소확신(underconfidence) 상태입니다.
다만 보정되었다는 것만으로는 충분하지 않습니다. 날마다 계절 평균치만 똑같이 말하는 예보관도 장기 비율을 따져 보면 보정된 상태이지만, 특정한 날에 대해 아무런 정보도 주지 못합니다. 실제로 쓸모 있는 신뢰도 점수가 되려면 관찰된 정보를 활용하면서도 보정되어 있어야 하며, 누군가 모든 예측과 실제 결과를 빠짐없이 기록해야만 그 확신도가 정확한지 확인할 수 있습니다.
신경망 보정을 다룬 Guo 등의 논문(ICML 2017)에서도 보정을 예측에 부여된 확률이 실제 정답일 가능성을 반영하는 성질로 정의합니다. 완벽하게 보정된 모델이라면 확신도 p를 부여한 예측들 가운데 실제로 맞은 비율이 정확히 p와 같습니다. 이를 시각적으로 나타낸 것이 신뢰도 다이어그램(reliability diagram)입니다. 예측들을 확신도 구간별로 묶어 가로축에 확신도, 세로축에 실제 정확도를 그린 그래프로, 완벽하게 보정된 모델은 대각선 위에 놓이고 대각선에서 벗어난 정도가 곧 보정 오차가 됩니다. 해당 논문은 신경망이 깊고 커질수록 실제 정확도보다 높은 확신도를 내놓는 과신(overconfidence) 경향이 나타난다고 보고합니다.
LLM이 말한 확신도는 왜 믿기 어렵습니까?
한 줄 답: LLM은 이전 토큰에 이어 다음 토큰을 예측해 글자를 쓸 뿐, 내부 계기판에서 확신도를 읽어 숫자를 내놓는 것이 아니기 때문입니다.
LLM은 앞서 나온 토큰들을 바탕으로 다음 토큰을 하나씩 이어 쓰는 자기회귀(autoregressive) 방식으로 문장을 만듭니다. 토큰 단위로 글자를 생성하는 기본 원리는 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유에서 다룹니다. 모델이 문장 끝에 적는 확신도 숫자 역시 내부 계기판에서 읽어 온 측정값이 아니라, 다른 일반 텍스트와 똑같은 방식으로 이어 쓴 그럴듯한 다음 토큰일 뿐입니다. 사전학습 과정은 텍스트의 다음 토큰을 잘 맞히도록 모델을 평가할 뿐, 모델이 말한 확신도가 실제 정답 빈도와 일치하는지를 평가하지 않습니다.
그 결과 실제로 관찰할 수 있는 세 가지 현상이 나타납니다.
- 같은 질문을 다시 물어보면 숫자가 바뀔 수 있습니다.
- “정말 확실합니까?”처럼 묻는 말투나 표현을 바꾸면 숫자가 달라질 수 있습니다.
- 숫자를 쓰기 전에 이미 생성한 문장(예컨대 답이 명백히 맞다고 단정하는 문장)이 뒤이어 나올 확신도 숫자를 그에 맞춰 끌고 갑니다.
이러한 한계는 “Asking LLM for confidence” 블로그 글에서 정리되었고, 해커 뉴스(Hacker News)의 “Using LLM for confidence scoring is a bad idea” 토론에서도 논의되었습니다. 토론 참가자들은 루브릭이나 좁은 척도를 쓰자는 의견, 혹은 토큰 확률을 보자는 의견을 내놓기도 했으나, 다른 참가자들은 그런 방식 역시 결국 보정 과정을 거쳐야 한다고 지적했습니다.
그럼 믿을 수 있는 신뢰도는 어떻게 만듭니까?
한 줄 답: 모델 바깥에서 관찰 가능한 정보를 고르고, 모든 답변과 실제 정답 여부를 기록해 그룹별 실제 정답률로 규칙을 갱신해야 합니다.
모델에게 얼마나 확신하는지 직접 물어보는 프롬프트에는 이러한 구조적 한계가 있으며, 프롬프트 설계 전반의 내용은 프롬프트 엔지니어링 정리 글에서 확인할 수 있습니다. 원문 블로그는 질문에 답하는 에이전트를 예로 들어, LLM 바깥에서 다음 다섯 단계로 신뢰도 규칙을 만드는 방법을 제시합니다.
- 관찰 가능한 정보 선택: 검색에서 관련 문서를 찾았는지, 이전에 답해 본 유형의 질문인지, 같은 질문에 대한 두 번의 답변이 서로 일치하는지처럼 모델 바깥에서 확인할 수 있는 정보를 고릅니다.
- 과거 기본 비율에서 출발: 처음에는 과거 전체 기록의 기본 정답 비율(base rate)에서 시작합니다.
- 모든 답변과 결과 기록: 모든 답변마다 그때 관찰된 정보, 부여한 신뢰도, 그리고 실제로 답변이 맞았는지를 빠짐없이 기록합니다.
- 그룹별 실제 정답률로 규칙 갱신: 같은 조건으로 묶인 그룹별로 실제 맞은 비율을 집계하여 신뢰도를 매기는 규칙을 갱신합니다.
- 주기적 재확인과 수정: 시간이 지나면서 특정 그룹이 과신이나 과소확신으로 치우치지 않는지 주기적으로 다시 확인하고 규칙을 고칩니다.
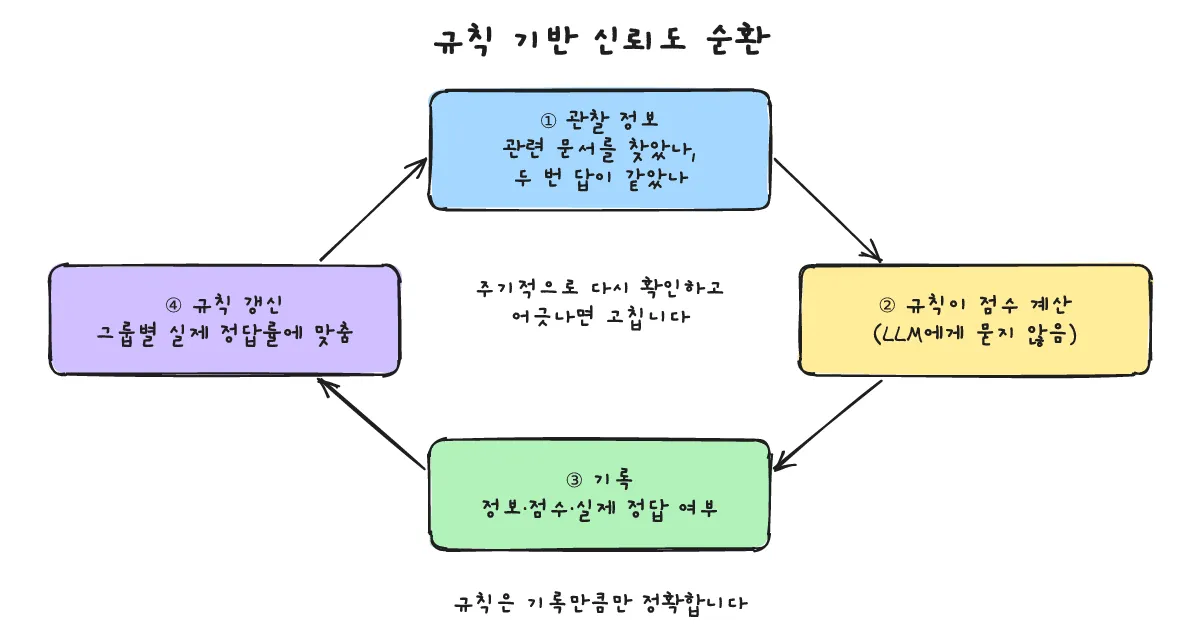
결국 이 규칙이 얼마나 믿을 만한지는 얼마나 충실하게 기록을 쌓았는지에 달려 있습니다.
토큰 확률(logprob)과는 무엇이 다릅니까?
한 줄 답: 토큰 확률은 모델이 다음 토큰에 매긴 내부 확률이라 말로 쓴 확신도와 다르지만, 실제 정답률과 맞는지 보정 확인을 거쳐야 한다는 점은 같습니다.
모델이 텍스트로 직접 적어 낸 확신도 숫자와, 모델이 다음 토큰을 고를 때 내부에서 계산하는 토큰 확률(logprob)은 구분해야 합니다. 토큰 확률은 말로 이어 쓴 문장이 아니라 모델 내부의 계산값이라는 점에서 측정값에 더 가깝습니다. 하지만 다음 토큰이 나올 확률이 곧 전체 답변이 사실로서 맞을 확률을 뜻하지는 않으므로, 토큰 확률을 신뢰도 점수에 활용하더라도 기록된 실제 결과와 대조해 보정(calibration)을 확인해야 합니다.
이처럼 모델 바깥의 기록을 보는 대신 모델 내부 작동 방식을 들여다보는 다른 접근은 기계적 해석가능성(Mechanistic Interpretability)이란?에서 다루며, 토큰을 고를 때 쓰는 샘플링 설정은 Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유에서 다룹니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: 프롬프트 변경만으로는 확신도를 보증할 수 없으며, 보정 여부와 함께 개별 사례의 정보를 반영하는지, 기록이 쌓이고 있는지를 확인해야 합니다.
프롬프트를 바꾸면 확신도를 믿을 수 있게 됩니까?
프롬프트만 바꿔서는 믿을 수 없습니다. 묻는 말투나 척도를 바꾸더라도, 그 점수가 나왔을 때 실제로 얼마나 맞았는지를 기록과 대조해 확인하지 않으면 보정 여부를 알 수 없기 때문입니다.
보정만 되면 좋은 신뢰도입니까?
아닙니다. 날마다 계절 평균만 말하는 예보관도 전체 비율로만 보면 보정된 상태이지만, 오늘의 구체적인 판단에는 아무 도움이 되지 않습니다. 좋은 신뢰도는 관찰된 정보를 활용해 사례를 구분하면서도 보정되어 있어야 합니다.
기록이 적을 때는 어떻게 합니까?
처음에는 과거의 기본 비율(base rate)에서 출발합니다. 초기에는 그룹 구분이 거칠 수밖에 없지만, 답변과 실제 정답 여부를 계속 기록하면서 데이터가 쌓이면 그룹별 규칙을 점차 정교하게 다듬을 수 있습니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 토큰 생성 원리, 프롬프트 설계, 기계적 해석가능성, 샘플링 설정을 다룬 글입니다.
- 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유
- 프롬프트 엔지니어링 정리 글
- 기계적 해석가능성(Mechanistic Interpretability)이란?
- Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유
출처는 어디입니까?
한 줄 답: 원문 블로그 글과 해커 뉴스 토론, 그리고 신경망 보정 정의를 다룬 ICML 논문입니다.
- Asking LLM for confidence (rumple.github.io, 2026-10-20) (확인 2026-10-25)
- Hacker News: Using LLM for confidence scoring is a bad idea (확인 2026-10-25)
- Guo, Pleiss, Sun, Weinberger, “On Calibration of Modern Neural Networks”, ICML 2017 (확인 2026-10-25)