핵심 요약
Grok 4.8에 대해 공식적으로 확인되는 것은 일론 머스크가 X에서 2026년 9월 14일에 남긴 게시글이 중심입니다. “2.5T 모델이며, 새로운 C++ 소프트웨어 스택으로 학습했고, 이번 주에 학습을 마치고 RL을 시작한다”는 내용입니다. 모델 카드, 벤치마크, 가격, 출시일은 공개되지 않았습니다. 2026년 10월 19일(KST) 확인 기준으로 xAI 공식 뉴스와 API 모델 목록에는 Grok 4.8이 없으며, 최신 주력 모델은 Grok 4.7입니다. 이 글은 2.5T 파라미터의 메모리 규모(감 잡기), RL 단계의 일반적 의미, C++ 스택의 일반적 이유를 정리합니다.
Grok 4.8에 대해 공식적으로 알려진 것은 무엇인가요?
한 줄 답: 일론 머스크가 X에 남긴 두 개의 게시글이 전부이며, 모델 카드·파라미터 구성·벤치마크·가격·출시일은 공개되지 않았습니다.
- 게시글 1 (X 게시글, 2026-09-14 10:24 KST / 2026-09-14 01:24 UTC): @techdevnotes가 “Apart from Grok 4.7, what are we even expecting from SpaceXAI in september”라고 묻자 일론 머스크가 답글로 남겼습니다.
- 원문: “Grok 4.8, which is a 2.5T model trained with our new C++ software stack, will finish training this week and start RL”
- 게시글 2 (X 게시글, 2026-09-14 20:19 KST): “Grok 4.8 will be a noticeable improvement.”
- 알려지지 않은 것: 공식 모델 카드, 밀집(dense)인지 MoE인지에 대한 구성, 벤치마크, 가격, 출시일은 없습니다. 그 주에 학습이 실제로 끝났는지도 공식적으로 확인되지 않았습니다.
2.5T 파라미터는 메모리로 얼마나 큰가요?
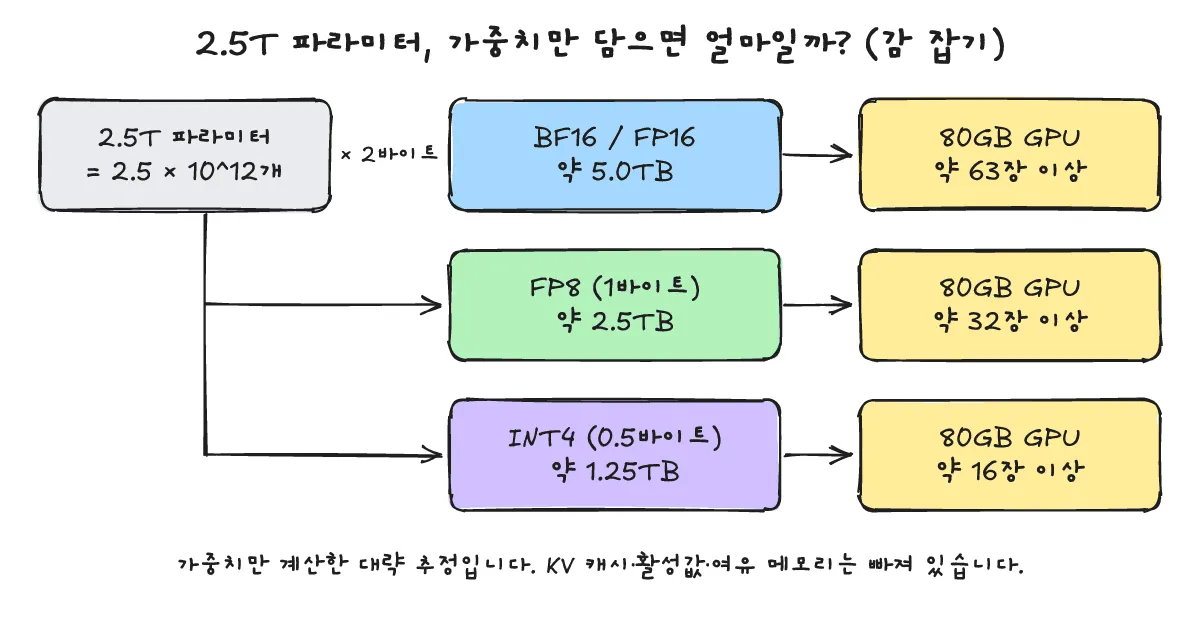
한 줄 답: 감 잡기(대략 추정)로, 가중치만 담아도 BF16 기준 약 5TB이며 80GB급 GPU가 최소 약 63장 필요합니다. 학습 상태까지 담으면 약 40TB입니다.
**감 잡기(대략 추정)**입니다. 가중치만 계산하고, 10진수 GB 단위, 80GB급 GPU를 가정합니다. xAI의 실제 구성이 아닙니다.
- 2.5T = 2.5 × 10^12 개 파라미터
- BF16/FP16 (파라미터당 2바이트): 2.5 × 10^12 × 2 B = 5.0 TB = 5,000 GB → 5,000 ÷ 80 = 62.5 → 가중치 보관만으로 최소 약 63장
- FP8 (1바이트): 2.5 TB = 2,500 GB → 2,500 ÷ 80 = 31.25 → 약 32장
- INT4 (0.5바이트): 1.25 TB = 1,250 GB → 1,250 ÷ 80 = 15.6 → 약 16장
- KV 캐시, 활성값, 프레임워크 오버헤드, 병렬화에 따른 중복은 제외한 값이므로 실제 배포에는 더 많이 필요합니다.
- 학습은 훨씬 무겁습니다. 혼합 정밀도 Adam은 파라미터당 대략 16바이트를 쓴다고 알려져 있습니다(fp16 가중치 2 + fp16 그래디언트 2 + fp32 마스터 가중치 4 + Adam m 4 + v 4, ZeRO 논문, Rajbhandari et al., 2019). 2.5 × 10^12 × 16 B = 40 TB = 40,000 GB → 40,000 ÷ 80 = 500장으로, 활성값을 빼고 모델 상태만 담아도 이 정도입니다. 이 역시 감 잡기이며 xAI의 실제 학습 구성은 공개되지 않았습니다.
- MoE 구조인지는 알려지지 않았습니다. 만약 MoE라면 토큰당 연산량은 줄어도 모든 전문가(expert) 가중치는 여전히 메모리에 올려야 합니다.
- 정밀도를 낮춰 메모리를 줄이는 원리는 양자화 정리 글을 참고해 주시기 바랍니다.
“학습을 끝내고 RL을 시작한다”는 무슨 뜻인가요?
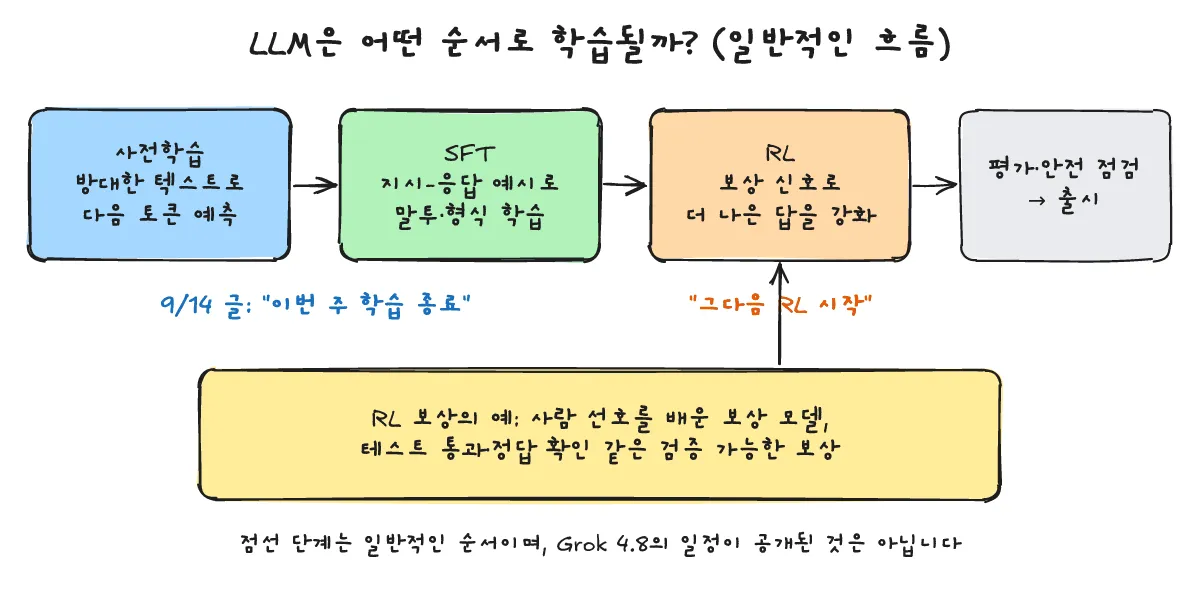
한 줄 답: 일반적으로 사전학습 단계가 끝나고, 보상 신호로 모델을 다듬는 후속 학습(post-training)에 들어간다는 뜻입니다. 아래 설명은 일반 지식이며 xAI의 발표가 아닙니다.
- 사전학습(pretraining): 방대한 텍스트에서 다음 토큰을 맞추는 자기지도 학습입니다.
- SFT: 지시와 응답 예시로 미세 조정하는 단계입니다.
- RL(강화학습): 선호 모델의 보상, 또는 테스트 통과·수학 정답 같은 검증 가능한 보상으로 모델을 개선합니다. RLHF는 PPO 계열 업데이트를 쓰고, DPO는 선호 데이터만 쓰는 대안입니다.
- 따라서 “학습을 끝내고 RL을 시작한다”는 사전학습 단계가 끝나고 후속 학습이 시작된다는 의미로 읽을 수 있습니다. 일반적으로 출시는 RL, 평가, 안전성 테스트 이후에 이뤄지지만, 이것도 일반론이며 xAI의 발표가 아닙니다.
- 사전학습·SFT·RLHF의 구분은 관련 정리 글에서 확인하실 수 있습니다.
학습 스택을 C++로 쓰는 이유는 무엇일까요?
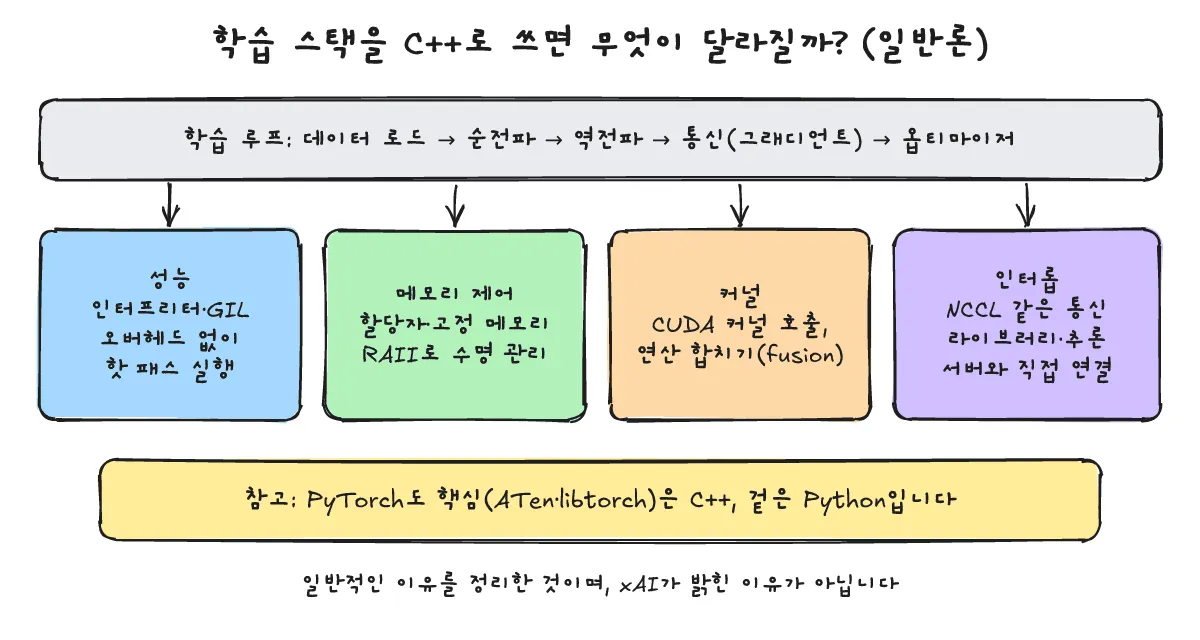
주의: 아래는 C++ 학습 스택에 대한 일반적인 추론이며, xAI가 밝힌 이유가 아닙니다. xAI는 이유를 설명한 적이 없습니다.
- 핫 패스의 오버헤드: Python 인터프리터와 GIL 오버헤드를 연산 중심 경로에서 피할 수 있습니다.
- 정밀한 메모리 제어: 할당자, 고정(pinned) 메모리, 단편화 회피를 직접 다룰 수 있어 2.5T 규모에서 유리할 수 있습니다.
- CUDA·커널 직접 연동: 융합 커널(fused kernel)을 통합하기 쉽습니다.
- 결정적 자원 관리: RAII로 자원 수명을 명확히 관리할 수 있습니다.
- 통신·서빙과의 연동: NCCL 같은 통신 라이브러리, 추론 서버와의 연동이 수월합니다.
- 참고로 PyTorch 같은 기존 프레임워크도 핵심은 C++(ATen/libtorch)이고 Python은 프런트엔드입니다.
10월 19일 기준 Grok 4.8은 출시됐나요?
한 줄 답: 아니요. 2026-10-19 01:00 KST경 확인한 공식 페이지에는 Grok 4.8 발표가 없습니다.
- 확인일: 2026-10-19 약 01:00 KST
- x.ai/news: 가장 최근 항목은 “Introducing Grok Voice 3.0”(2026-10-14)이며 Grok 4.8 발표는 없습니다.
- docs.x.ai 모델 목록: 가장 새로운 텍스트 모델은 grok-4.7이며 grok-4.8은 없습니다. 페이지에는 “use Grok 4.7. It is the most capable model we’ve built.”라고 적혀 있습니다.
- Grok 4.7은 2026-09-21에 출시된 최신 주력 모델입니다. 독립 매체 versusapp.com(2026-10-16)도 같은 날짜를 전합니다.
- 출시 시점: 공개된 출시일은 없습니다. 시점을 점치는 것은 추측에 불과하므로 이 글에서는 다루지 않겠습니다.
자주 묻는 질문은 무엇인가요?
Q1. Grok 4.8은 이미 출시됐나요?
2026-10-19 약 01:00 KST 확인 기준으로 출시되지 않았습니다. x.ai/news와 docs.x.ai 모델 목록 모두에 Grok 4.8이 없고, 최신 주력 모델은 Grok 4.7입니다. 출시일은 발표되지 않았습니다.
Q2. Grok 4.8은 밀집 모델인가요, MoE인가요?
알려지지 않았습니다. 머스크의 게시글은 “2.5T model”이라고만 밝혔고 파라미터 구성은 공개되지 않았습니다.
Q3. xAI가 C++ 스택을 쓰는 이유를 밝혔나요?
밝히지 않았습니다. 게시글에는 “new C++ software stack”이라는 표현만 있으며, 이 글의 C++ 이유는 모두 일반적인 추론입니다.
출처는 어디인가요?
- Elon Musk, X 게시글 (2026-09-14 10:24 KST)
- Elon Musk, X 게시글 (2026-09-14 20:19 KST)
- xAI News (2026-10-19 확인)
- xAI Docs: Models (2026-10-19 확인)
- versusapp.com, Grok 4.8 release date (2026-10-16)
- Rajbhandari et al., ZeRO (2019)