핵심 요약
잠재 추론은 모델이 중간 생각을 글(토큰)로 쓰지 않고, 마지막 층의 hidden state를 다음 입력으로 다시 넣어 내부에서 생각을 잇는 방식입니다. CoT(생각의 사슬)는 생각이 글로 남아 읽을 수 있고, 잠재 추론은 토큰을 덜 쓸 수 있지만 그 생각을 들여다보기 어렵습니다.
이 글은 잠재 추론이 무엇인지, CoT와 어떻게 다른지, 글로 생각하지 않는 모델이 도구를 어떻게 부르는지를 정리합니다. 2026-10-19(KST)에 Hacker News에 올라온 논문 “Hybrid Reasoning Agents”를 계기로 썼으며, 논문 고유의 주장은 “논문은 ~라고 주장합니다”로 따로 표시합니다. 수치와 벤치마크는 다루지 않습니다.
잠재 추론이란 무엇입니까?
한 줄 답: 중간 생각을 토큰으로 쓰지 않고 마지막 층 hidden state를 다음 입력으로 다시 넣어, 내부 벡터 공간에서 생각을 잇는 방식입니다.
여기서 hidden state(숨은 상태)는 Transformer의 마지막 층이 한 위치에 대해 내놓는 벡터입니다. 논문은 모델이 다음 입력을 만드는 방식을 두 가지로 나눕니다. 텍스트 모드에서는 마지막 층 hidden state에서 어휘 전체에 대한 softmax로 토큰 하나를 고르고, 그 토큰의 임베딩이 다음 입력이 됩니다. 잠재 모드에서는 토큰을 고르지 않고 hidden state 자체를 다음 입력으로 그대로 씁니다. 이것이 표준적인 잠재 추론이며, 선행 연구로는 Coconut 계열이 있습니다.
토큰이 무엇인지 궁금하다면 토큰·컨텍스트 윈도 정리 글을 참고하십시오.
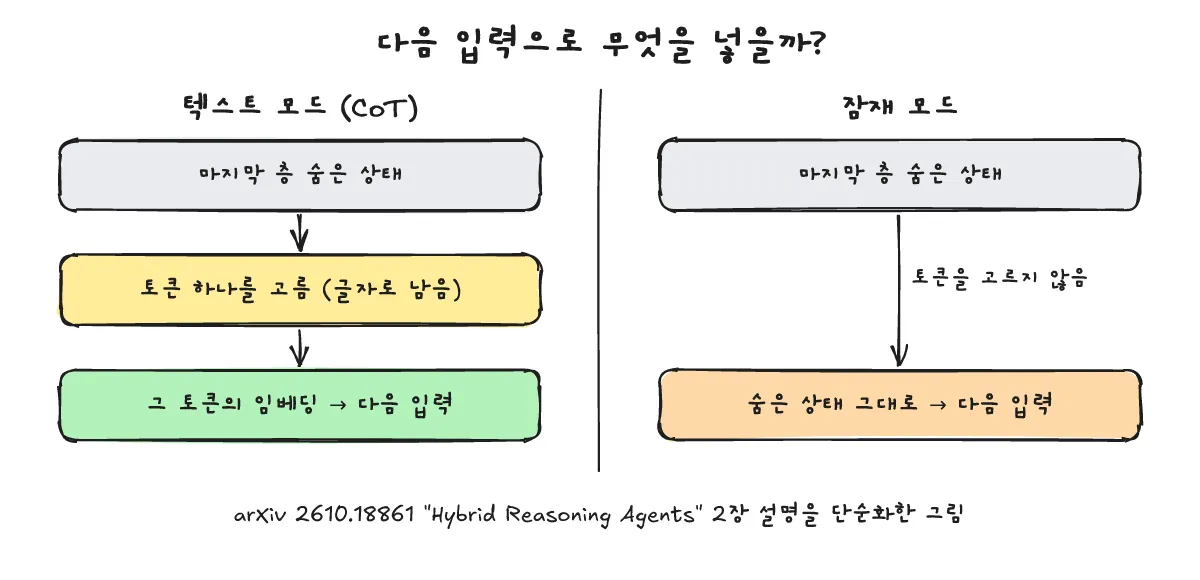
CoT와 무엇이 다릅니까?
한 줄 답: CoT는 생각이 토큰으로 남아 읽을 수 있지만 단계마다 출력 토큰을 쓰고, 잠재 추론은 토큰을 덜 쓸 수 있지만 읽기와 감사가 어렵습니다.
CoT(생각의 사슬)는 중간 풀이 단계를 토큰으로 써 내려가는 방식입니다. 사람이 그 단계를 읽을 수 있는 대신, 단계마다 출력 토큰이 듭니다. 잠재 추론은 중간 단계를 토큰으로 풀어 쓰지 않으므로 토큰을 덜 쓸 수 있지만, 그 단계가 사람이 바로 읽을 수 있는 글이 아니어서 감독과 감사가 더 어렵습니다. CoT 프롬프트를 쓰는 방법은 이 글에서 다루지 않으며, AI Day4 프롬프트 엔지니어링 글에서 볼 수 있습니다.
| 구분 | CoT | 잠재 추론 |
|---|---|---|
| 생각이 남는 형태 | 토큰(글) | hidden state(벡터) |
| 사람이 읽을 수 있는가 | 읽을 수 있음 | 직접 읽기 어려움 |
| 토큰 비용(정성) | 단계마다 출력 토큰 소모 | 중간 단계를 풀어 쓰지 않아 덜 쓸 수 있음 |
| 도구 호출 | 텍스트로 바로 생성 가능 | 텍스트 인터페이스와 맞지 않아 어려움 |
표의 내용은 일반적으로 알려진 사실이며, 논문 고유의 주장은 아래 섹션에서 “논문은 ~라고 주장합니다”로 구분해 적습니다.
글로 쓰지 않으면 도구는 어떻게 부릅니까?
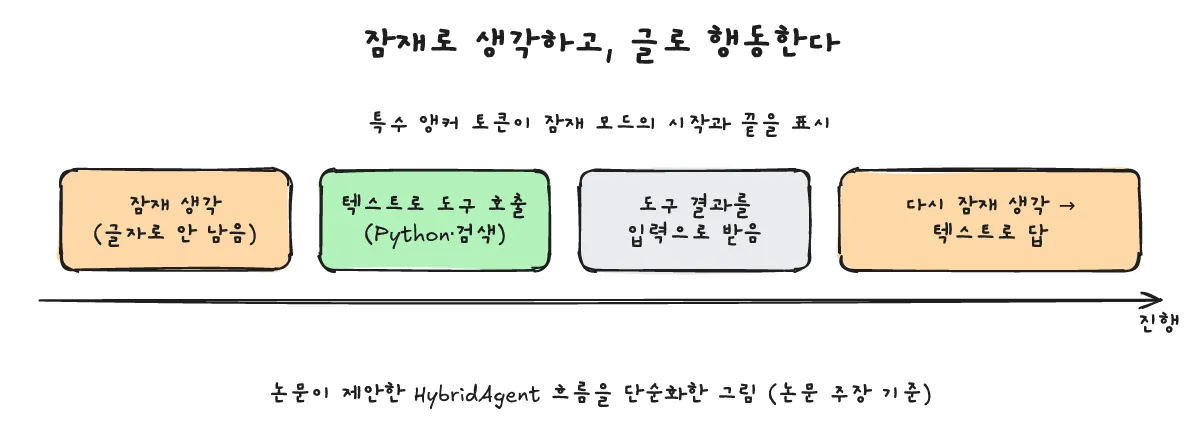
한 줄 답: 도구는 텍스트 인터페이스로 호출하기 때문에, 논문은 HybridAgent가 생각은 잠재 공간에서 하고 행동(도구 호출)은 텍스트로 생성한다고 주장합니다.
도구는 텍스트 인터페이스로 호출하므로, 순수 잠재 추론기는 도구를 부르기 어렵습니다. 논문 초록도 오늘날의 LLM 에이전트가 텍스트로 추론하고 행동하며, 잠재 추론은 효율적인 내부 매체지만 기본적인 도구 접근과 투명성이 부족하다고 지적합니다. 이 내용은 Hacker News 스레드(2026-10-19 KST 게시)와 arXiv 논문에서 확인했습니다.
논문이 제안하는 HybridAgent는 잠재 공간에서 생각하고 텍스트로 행동하며, Python이나 검색 같은 도구 호출은 텍스트로 생성합니다.
모드를 오가기 위해 논문은 HybridLink라는 경량 어댑터를 둡니다. 논문은 이 어댑터가 마지막 층 hidden state를 입력 임베딩 공간으로 되돌려 주어 모델이 두 모드를 전환할 수 있다고 주장합니다. 잠재 모드에 들어가고 나오는 지점은 특별한 앵커 토큰으로 표시합니다.
멀티턴 문맥은 KV 엔트리로 이어 가며, 논문은 이를 working memory라고 부릅니다. KV 캐시 자체는 AI Day3 LLM 추론·KV 캐시 글에서 다룹니다.
학습은 HybridSFT와 HybridRL 순서입니다. HybridSFT는 지도 파인튜닝 단계이고, HybridRL은 강화학습으로 언제 잠재 공간에서 생각하고 언제 텍스트로 행동할지를 배우게 한다고 논문은 주장합니다. SFT와 RL이 무엇인지는 사전학습·파인튜닝·RLHF 글을 참고하십시오.
잠재 생각은 들여다볼 수 있습니까?
한 줄 답: 논문은 각 잠재 단계를 가장 가까운 토큰 임베딩에 대응시켜 의사 텍스트로 읽을 수 있다고 주장하지만, 일반적으로 잠재 생각은 직접 읽기 어렵습니다.
논문은 각 잠재 단계를 가장 가까운 토큰 임베딩에 대응시키면 그 단계를 의사 텍스트처럼 읽을 수 있다고 주장합니다. 이것은 논문의 주장이며, 일반적으로는 잠재 단계가 글로 남지 않으므로 감독하고 감사하기 어렵습니다. 모델 내부를 읽는 연구 전반은 기계적 해석 가능성 글에서 다룹니다.
자주 묻는 질문은 무엇입니까?
잠재 추론을 쓰면 CoT 프롬프트가 필요 없습니까?
두 개념은 층위가 다릅니다. CoT 프롬프트는 입력을 쓰는 방식이고, 잠재 추론은 모델이 내부에서 생성을 이어 가는 방식입니다. 프롬프트 쪽은 프롬프트 엔지니어링 글을 참고하십시오.
지금 쓰는 챗봇이 잠재 추론을 합니까?
외부에서는 알 수 없습니다. 이 글에서 다룬 논문은 연구 단계의 제안입니다.
숨은 상태(hidden state)는 무엇입니까?
마지막 Transformer 층이 한 위치에 대해 내놓는 벡터입니다.
함께 보면 좋은 글은 무엇입니까?
출처는 어디입니까?
- Hacker News: Hybrid Reasoning Agents: LLM agents that think in latent space, act through text (2026-10-19 KST 게시, 확인일 2026-10-23)
- arXiv 2610.18861: Hybrid Reasoning Agents (Zou et al., 확인일 2026-10-23)