핵심 요약
SIMD(Single Instruction, Multiple Data)는 한 명령으로 여러 데이터에 같은 연산을 한꺼번에 하는 방식입니다. 128비트 레지스터 하나에는 8비트 값 16개가 들어가므로, 스칼라로 16번 할 덧셈을 한 번에 처리할 수 있습니다. C++에서는 컴파일러 자동 벡터화가 가장 쉬운 시작점이고, g++에서는 -O3 -fopt-info-vec-optimized로 루프가 벡터화되었는지 바로 확인할 수 있습니다.
SIMD 명령어를 갖춘 저가 마이크로컨트롤러 ESP32-S3에서 128비트 벡터 명령으로 컴퓨터 비전 특징점 검출(FAST)을 가속한 글이 Hacker News에서 화제가 되었습니다. 원문 저자는 참조 구현보다 빨라졌다고 보고했습니다. 이 글은 원문의 어셈블리나 알고리즘을 그대로 재현하지 않고, SIMD의 기본 개념과 PC의 g++ 환경에서 C++ 컴파일러 자동 벡터화 여부를 확인하는 방법을 정리합니다.
SIMD란 무엇입니까?
한 줄 답: 한 명령으로 여러 데이터 요소에 같은 연산을 동시에 적용하는 처리 방식입니다.
일반적인 스칼라 덧셈처럼 명령 하나가 데이터 하나만 처리하는 방식을 SISD(Single Instruction, Single Data)라고 부릅니다. 반면 SIMD(Single Instruction, Multiple Data)는 하나의 벡터 레지스터에 여러 값을 담아 두고, 명령 한 번으로 그 안의 모든 요소에 동일한 연산을 한꺼번에 수행합니다.
반복적인 요소별 연산이 많은 영상·오디오 처리나 배열 수학 연산에서 주로 활용됩니다.
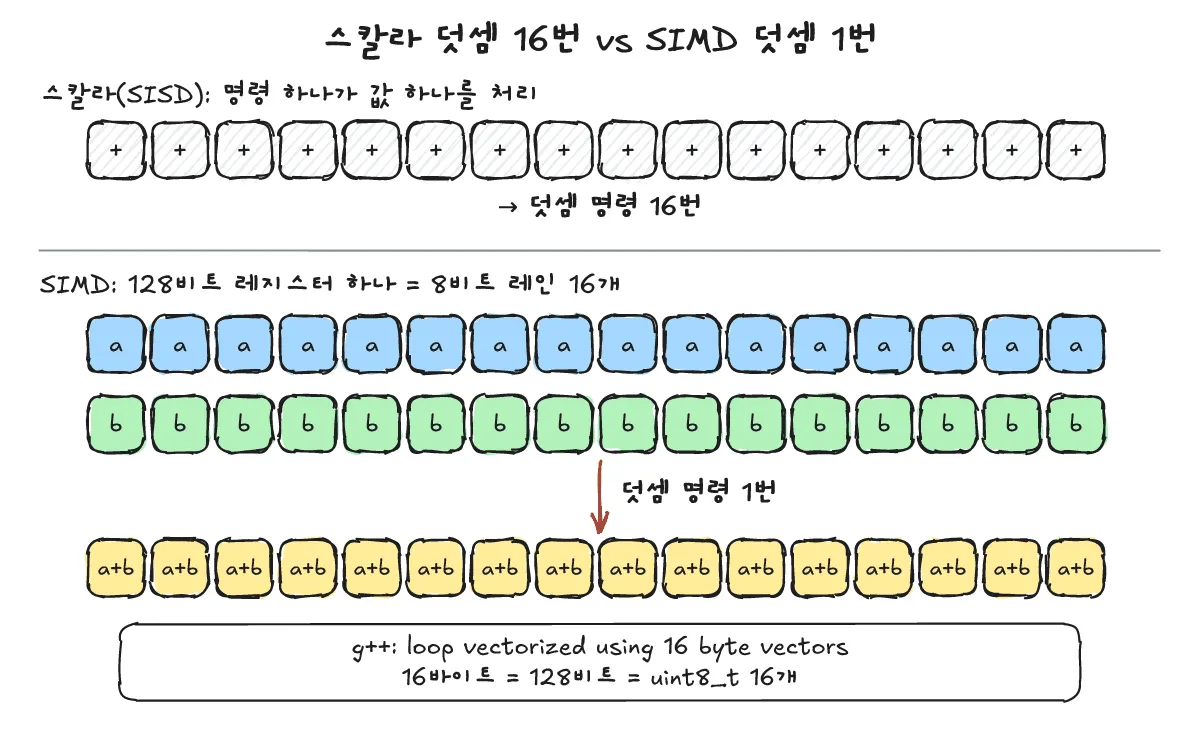
128비트 레지스터에는 값이 몇 개 들어갑니까?
한 줄 답: 레지스터 전체 폭인 128비트를 데이터 요소 하나의 비트 폭으로 나눈 개수만큼 들어갑니다.
벡터 레지스터 내부에서 개별 데이터 요소가 차지하는 칸을 레인(lane)이라고 부릅니다. 128비트 레지스터 하나에 들어가는 요소 개수는 데이터 폭에 따라 다음과 같이 나뉩니다.
| 요소 비트 폭 | 레인(lane) 개수 |
|---|---|
| 8-bit | ×16 |
| 16-bit | ×8 |
| 32-bit | ×4 |
원문에서 다룬 ESP32-S3의 벡터 레지스터도 128비트 폭을 갖추고 있어, 8비트 값 16개를 한 번에 담아 처리합니다. 메모리에 바이트가 저장되는 순서 자체는 벡터 레인의 개수와 별개의 주제이므로 엔디안(빅엔디안·리틀엔디안) 정리 글을 참고하시기 바랍니다.
C++에서 SIMD를 쓰는 방법은 무엇입니까?
한 줄 답: 컴파일러 자동 벡터화, 인트린식(intrinsics), 어셈블리 세 가지 방법이 있습니다.
- 자동 벡터화(auto-vectorization): 일반 C++ 루프를 작성하면 컴파일러가 분석해 벡터 명령으로 변환하는 방식입니다. 가장 쉽게 시작할 수 있고 이식성이 좋지만, 모든 루프가 항상 벡터화되지는 않습니다.
- 인트린식(intrinsics): 특정 벡터 명령에 대응하는 C/C++ 함수를 호출하는 방식입니다. 명령어 세트(ISA) 전용 헤더를 사용하므로 아키텍처에 종속됩니다.
- 어셈블리(assembly): 레지스터와 명령어를 직접 제어하는 방식입니다. 제어가 가장 세밀하지만 작성과 유지보수가 가장 어렵습니다. 원문 저자는 ESP32-S3 어셈블리를 직접 작성했습니다.
실무에서는 먼저 자동 벡터화로 시작해 컴파일러 리포트와 성능을 측정한 뒤, 꼭 필요한 구간만 하위 수준 방식을 검토하는 흐름이 안전합니다.
g++가 내 루프를 벡터화했는지 어떻게 확인합니까?
한 줄 답: -O3 -fopt-info-vec-optimized 옵션을 주고 컴파일하여 loop vectorized 메시지가 출력되는지 확인합니다.
다음은 두 uint8_t 배열을 더해 255를 넘지 않도록 잘라내는 C++ 예제 파일 simd/add.cpp입니다.
#include <cstdint>
#include <cstdio>
void add_u8(uint8_t* __restrict d,const uint8_t* __restrict a,const uint8_t* __restrict b,int n){for(int i=0;i<n;i++){int s=a[i]+b[i];d[i]=s>255?255:s;}}
int main(){uint8_t a[64],b[64],d[64];for(int i=0;i<64;i++){a[i]=i*4;b[i]=100;}add_u8(d,a,b,64);printf("%d %d %d\n",d[0],d[20],d[63]);}
이 글의 실행 환경(g++ 14.2.0, x86-64 리눅스)에서 확인한 결과는 다음과 같습니다.
$ g++ -O3 -fopt-info-vec-optimized simd/add.cpp -o add && ./add
simd/add.cpp:3:111: optimized: loop vectorized using 16 byte vectors
simd/add.cpp:3:111: optimized: loop vectorized using 16 byte vectors
simd/add.cpp:4:51: optimized: loop vectorized using 16 byte vectors
100 180 255
$ g++ -O1 -fopt-info-vec-optimized simd/add.cpp -o add1 && ./add1
100 180 255
add_u8 함수는 두 uint8_t 배열 요소를 더한 뒤 결과가 255보다 크면 255로 고정하는 포화 덧셈(saturating add)을 C++ 코드로 작성한 것이며, __restrict는 포인터가 가리키는 배열 영역이 서로 겹치지 않음을 컴파일러에 약속합니다.
-O3에서는 3번 줄(add_u8의 루프)과 4번 줄(main의 초기화 루프)이 using 16 byte vectors로 벡터화되었다고 출력됩니다. 16바이트는 곧 128비트이며, uint8_t 레인 16개를 한 번에 처리한다는 뜻입니다. 이 실행 환경에서 3번 줄 메시지가 두 번 나타나는 것은 함수의 별도 사본이 각각 벡터화될 때 같은 루프가 두 번 보고되는 경우일 수 있습니다.
프로그램 출력은 -O3과 -O1 모두 100 180 255로 동일합니다. 즉 벡터화는 계산 결과가 아니라 실행 방식을 바꾸는 최적화이며, -O1에서는 벡터화 메시지가 나오지 않습니다. 만약 루프가 왜 벡터화되지 않았는지 이유를 확인하고 싶다면 -fopt-info-vec-missed 옵션을 사용할 수 있습니다.
자동 벡터화를 막는 것은 무엇입니까?
한 줄 답: 포인터 에일리어싱, 루프 내부의 복잡한 분기·함수 호출, 반복 간 데이터 의존성, 정렬 조건이 주요 원인입니다.
- 포인터 에일리어싱(pointer aliasing): 입력 배열과 출력 배열이 메모리에서 겹치지 않는다는 사실을 컴파일러가 증명하지 못하면 벡터화를 보류합니다. 이 경우
__restrict키워드를 붙이거나 데이터 구조를 정리해 해결합니다. - 루프 내 분기와 함수 호출: 앞선 예제의 255 상한 고정처럼 단순한 조건문은 벡터 선택 명령으로 변환될 수 있지만, 내부를 알 수 없는 불투명한(opaque) 외부 함수 호출은 대개 벡터화를 가로막습니다.
- 반복 간 데이터 의존성(loop-carried dependency):
a[i]의 계산 결과가 이전 반복의a[i-1]에 의존하면 여러 레인을 동시에 계산할 수 없습니다. - 정렬(alignment) 및 알 수 없는 반복 횟수: 메모리 정렬 상태나 반복 횟수를 컴파일 시점에 알 수 없으면, 컴파일러가 런타임 검사 코드나 자투리(remainder) 스칼라 루프를 덧붙여야 합니다.
포화 연산과 부호 문제는 왜 생깁니까?
한 줄 답: SIMD 명령어 세트는 오버플로 시 값을 감싸는 대신 최댓값·최솟값에서 멈추는 포화 연산을 쓰거나 특정 부호 타입만 제공하는 경우가 있어 데이터를 맞춰 주어야 합니다.
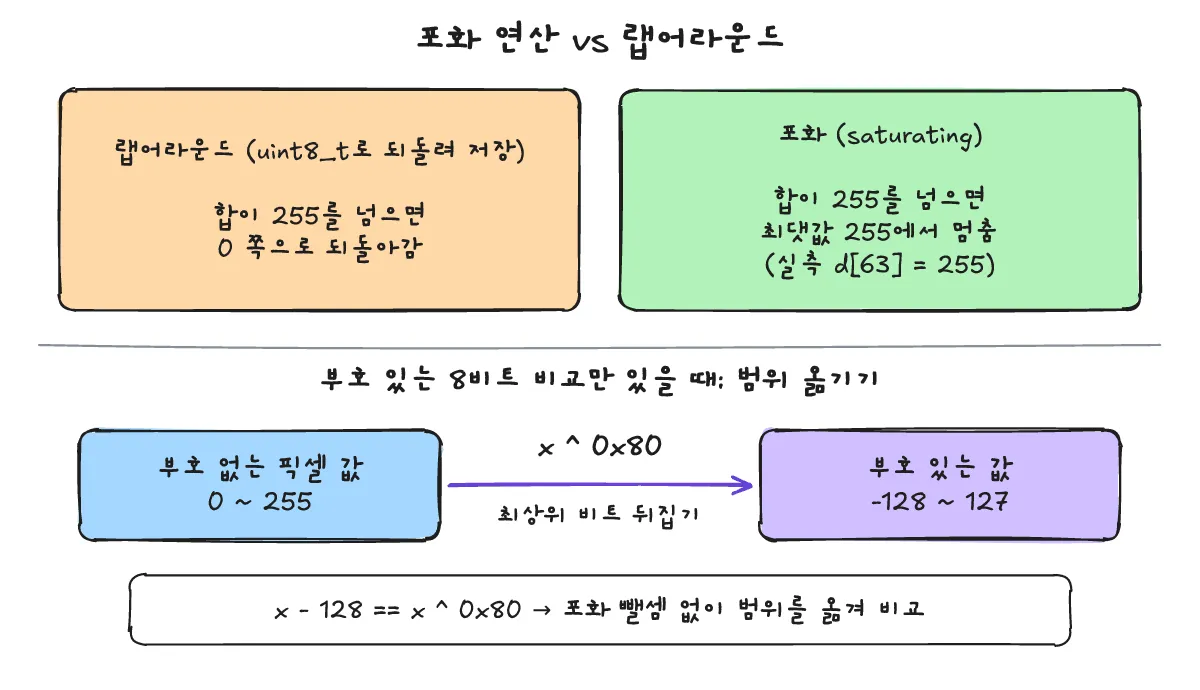
C++에서 일반적인 uint8_t 연산 결과를 다시 8비트로 변환하면 범위를 넘을 때 값이 감싸지는 래핑(wrap-around)이 일어납니다. 반면 포화 연산(saturating arithmetic)은 최댓값인 255에서 멈추며, 앞선 재현 코드에서 d[63]이 255로 출력된 것도 이 동작을 표현한 것입니다.
원문의 ESP32-S3 사례에서는 다음과 같은 하드웨어 특성이 언급됩니다.
- 8비트 비교 명령이 부호 있는(signed) 값에 대해서만 제공됩니다.
- SIMD 산술 연산이 포화 연산으로 동작하므로, 부호 없는(unsigned) 픽셀 값에서 단순히 128을 빼면 범위가 그대로 옮겨지지 않고 포화 때문에 범위 끝에서 잘려 버립니다.
- 정렬되지 않은(unaligned) 메모리 읽기가 불가능하여, 두 레지스터를 이어 붙인 뒤 원하는 구간을 잘라내는 명령어로 우회했습니다.
- 비트 XOR 성질인
x - 128 == x ^ 0x80(최상위 비트 반전)을 이용해 부호 없는 0255 범위를 부호 있는 -128127 범위로 옮겨 비교 명령이 동작하도록 맞추었습니다.
C++에서 작은 정수 타입이 연산 전에 int로 바뀌는 규칙과 부호 문제는 C++ 정수 승격(integral promotion)이란? ~true가 true가 되는 이유 글에서 자세히 다룹니다.
자주 묻는 질문은 무엇입니까?
한 줄 답: SIMD와 GPU의 구조적 차이, 임베디드 MCU에서의 자동 벡터화 조건, 벡터화 누락 원인 확인 옵션을 정리했습니다.
SIMD와 GPU는 무엇이 다릅니까?
SIMD는 CPU 코어 내부의 벡터 명령어로 CPU 레지스터에 담긴 데이터를 처리하는 방식이고, GPU는 수많은 코어를 갖춘 별도의 프로세서에서 대규모 병렬 작업을 수행하는 장치입니다. 두 방식 모두 데이터 병렬성을 활용하며, 가속기 구조 비교는 NPU와 GPU 차이점은? 구조·용도·전력으로 쉽게 비교 글을 참고하시기 바랍니다.
임베디드 MCU에서도 자동 벡터화가 됩니까?
툴체인과 명령어 세트(ISA)에 따라 다릅니다. 컴파일러의 벡터화 리포트 옵션으로 직접 확인해 보아야 하며, 일부 MCU의 SIMD는 제조사 라이브러리나 어셈블리(원문 사례)를 통해 활용합니다. 보드 없이 PC에서 펌웨어를 돌려 보는 주제는 「ESP32 에뮬레이터란? 보드 없이 펌웨어를 PC·브라우저에서 돌려볼 때」에서 다룹니다.
벡터화가 안 된 이유는 어떻게 봅니까?
g++에서 -fopt-info-vec-missed 옵션을 사용하면 벡터화되지 못한 루프에 대한 정보를 볼 수으며, 포인터 에일리어싱이나 반복 간 데이터 의존성 항목을 함께 점검합니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: C++ 정수 승격, 메모리 바이트 순서(엔디안), 병렬 연산 장치 비교 글을 함께 볼 수 있습니다.
- C++ 정수 승격(integral promotion)이란? ~true가 true가 되는 이유
- 엔디안(빅엔디안·리틀엔디안) 정리 글
- NPU와 GPU 차이점은? 구조·용도·전력으로 쉽게 비교
- 「ESP32 에뮬레이터란? 보드 없이 펌웨어를 PC·브라우저에서 돌려볼 때」
출처는 어디입니까?
한 줄 답: Hacker News 토론 스레드와 원문 블로그, GCC 문서 및 이 글의 실측 환경 정보입니다.
- Hacker News 토론: ESP32-S3의 SIMD로 컴퓨터 비전을 가속한 글 (확인 2026-11-02)
- 원문: shraiwi.com 블로그 글(2026-11-02 열람)
- GCC 자동 벡터화 프로젝트 문서(링크 생략)
- 실측: g++ (Debian 14.2.0-19) 14.2.0, x86-64 리눅스, 2026-11-02