Ollama 사용법은 리눅스에 Ollama를 설치해 로컬 서버(ollama serve)를 띄운 뒤, 언어 모델을 받아 명령줄(ollama run)이나 로컬 REST API(127.0.0.1:11434)에서 curl로 호출하는 흐름으로 이루어집니다. 이 글에서는 공식 문서의 기준과 함께 이 글의 실행 환경(x86-64 리눅스(Debian 13), CPU 8코어, GPU 없음, systemd 없음, Ollama 0.40.14)에서 작은 모델(SmolLM2-360M-Instruct)을 등록해 첫 실행과 API 호출까지 확인한 결과를 정리합니다.
핵심 요약
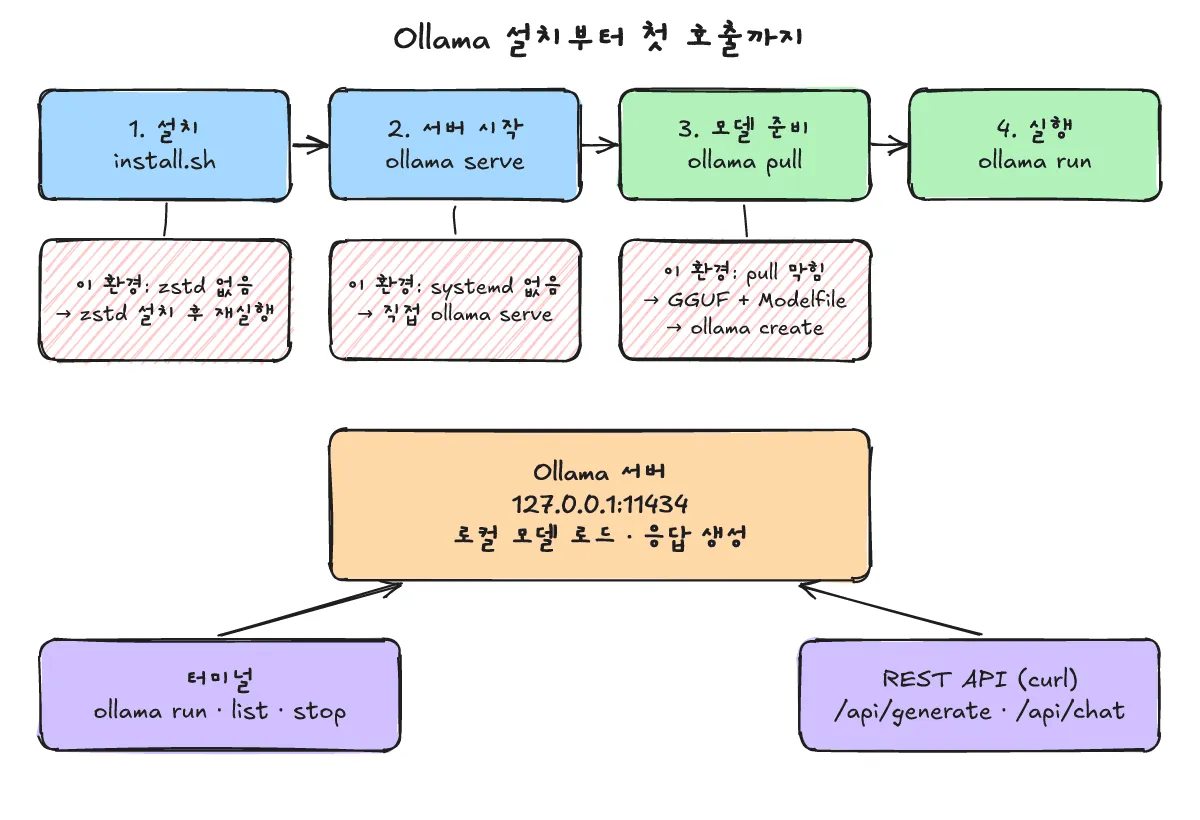
이 글의 실행 환경(x86-64 리눅스(Debian 13), CPU 8코어, GPU 없음, systemd 없음, Ollama 0.40.14)에서는 공식 설치 스크립트 첫 실행 때 zstd가 없어 중단되어 zstd 설치 후 완료했고, systemd가 동작하지 않아 ollama serve로 서버를 직접 띄웠으며, 네트워크 정책으로 ollama pull smollm2:360m의 모델 파일 다운로드 리다이렉트가 거부되어 공개된 GGUF 파일과 한 줄짜리 Modelfile 및 ollama create로 모델을 등록한 뒤 ollama run과 127.0.0.1:11434 REST API 호출을 확인했습니다.
Ollama 사용법의 출발점, Ollama는 무엇이고 무엇을 할 수 있습니까?
한 줄 답: Ollama는 로컬 환경에서 명령줄(CLI)과 127.0.0.1:11434 REST API로 대규모 언어 모델(LLM)을 내려받아 실행하고 관리하는 도구입니다.
로컬 서버(ollama serve)와 CLI·REST API 구조
공식 문서(FAQ 및 API 레퍼런스)에 따르면 Ollama는 기본적으로 127.0.0.1의 11434 포트에 로컬 서버를 바인딩합니다. 서버가 떠 있으면 터미널에서 CLI 명령으로 모델을 받아 실행하거나, 같은 주소의 REST API 엔드포인트로 HTTP 요청을 보내 응답을 받을 수 있습니다.
모델 이름은 model:tag 형식을 따르며 태그를 생략하면 기본값인 latest가 붙습니다. 공식 문서에는 다른 운영체제용 설치 파일도 안내되어 있으나, 이 글에서는 리눅스 환경을 기준으로 다룹니다.
리눅스에 Ollama를 어떻게 설치합니까?
한 줄 답: 공식 설치 스크립트(install.sh)를 실행해 설치하며, zstd 패키지가 필요하고 systemd가 없는 환경에서는 ollama serve로 서버를 직접 띄웁니다.
공식 설치 명령과 zstd 오류 해결
공식 리눅스 문서에서 안내하는 설치 명령은 다음과 같습니다(이 글에서는 동일한 스크립트를 먼저 파일로 저장한 뒤 sh install.sh로 실행했습니다).
$ curl -fsSL https://ollama.com/install.sh | sh첫 번째 실행에서는 압축 해제에 필요한 zstd가 설치되어 있지 않아 아래와 같이 중단되었습니다(처음 두 줄 발췌).
>>> Installing ollama to /usr/local
ERROR: This version requires zstd for extraction. Please install zstd and try again:zstd를 설치한 뒤 다시 실행하자 설치가 완료되었습니다. 아래는 두 번째 실행 출력에서 >>> 진행 줄과 systemd 경고 줄을 모은 발췌입니다(다운로드 진행률 표시와 GPU 감지 경고 한 줄은 생략했습니다).
>>> Cleaning up old version at /usr/local/lib/ollama
>>> Installing ollama to /usr/local
>>> Downloading ollama-linux-amd64.tar.zst
>>> Creating ollama user...
>>> Adding ollama user to video group...
>>> Adding current user to ollama group...
>>> Creating ollama systemd service...
WARNING: systemd is not running
>>> The Ollama API is now available at 127.0.0.1:11434.
>>> Install complete. Run "ollama" from the command line.
공식 리눅스 문서에는 스크립트 설치 대신 ollama-linux-amd64.tar.zst 패키지를 받아 /usr에 풀어 넣는 수동 설치 방법과, Ollama를 systemd 시작 서비스로 등록하는 방법(권장)도 함께 안내되어 있습니다.
systemd 미실행 경고와 ollama serve 수동 실행
이 환경에서는 systemd가 실행 중이지 않아 설치 스크립트가 서비스를 자동으로 시작하지 못했습니다. 따라서 공식 문서의 수동 실행 안내에 따라 다른 터미널에서 ollama serve로 서버를 직접 띄운 뒤, ollama -v로 버전을 확인했습니다.
$ ollama -v
ollama version is 0.40.14
모델은 어떻게 받아서 실행합니까?
한 줄 답: 일반 네트워크에서는 ollama pull <model>이나 ollama run <model>로 받으며, 다운로드 리다이렉트가 막힌 환경에서는 GGUF 파일과 한 줄짜리 Modelfile로 ollama create를 실행해 등록합니다.
기본 방식(ollama pull)과 네트워크 정책 제한 시 GGUF 가져오기
공식 CLI 문서에 따르면 일반적인 네트워크 환경에서는 아래 공식 문서 명령처럼 ollama pull <model>로 모델을 미리 내려받거나, ollama run <model>을 실행해 자동으로 내려받습니다(아래는 공식 문서의 명령 형식이며 이 환경의 실행 출력이 아닙니다).
ollama pull <model>
ollama run <model>
그러나 이 환경에서는 ollama pull smollm2:360m을 실행했을 때 이 환경의 네트워크 정책 때문에 모델 파일 다운로드 단계에서 리다이렉트가 거부되어 실패했습니다. 이는 이 실행 환경의 제약이며, 일반 네트워크에서는 공식 방식인 ollama pull <model>이나 ollama run <model>을 사용하면 됩니다.
여기서는 공식 문서(Importing a model)의 단일 파일 GGUF 가져오기 방법을 사용했습니다. 공개 배포된 SmolLM2-360M-Instruct의 Q8_0 GGUF 파일을 curl로 내려받은 뒤, 공식 문서 안내대로 FROM /path/to/file.gguf 구문을 담은 한 줄짜리 Modelfile을 작성했습니다. 공식 문서에 따르면 Ollama는 GGUF 모델을 가져올 때 별도로 양자화를 수행하지 않습니다.
FROM ./smollm2-360m-instruct-q8_0.gguf이어서 ollama create 명령으로 모델을 등록했습니다(진행률 표시 줄은 제거한 출력입니다).
$ ollama create smollm2-360m -f Modelfile
gathering model components
parsing GGUF
using existing layer sha256:48ab3034d0dd401fbc721eb1df3217902fee7dab9078992d66431f09b7750201
using autodetected template chatml
creating new layer sha256:f02dd72bb2423204352eabc5637b44d79d17f109fdb510a7c51455892aa2d216
writing manifest
success
ollama list와 ollama show로 모델 제원 확인
등록이 끝난 뒤 ollama list(공식 문서의 ollama ls와 동일)로 로컬 모델 목록을 확인한 결과는 다음과 같습니다.
$ ollama list
NAME                   ID              SIZE      MODIFIED
smollm2-360m:latest    0f1656a1eca9    386 MB    Less than a second ago
ollama show를 실행하면 파라미터 수(361.82M), 컨텍스트 길이(8192), 양자화 방식(Q8_0) 등 모델의 세부 정보를 볼 수 있습니다.
$ ollama show smollm2-360m
  Model
    architecture        llama
    parameters          361.82M
    context length      8192
    embedding length    960
    quantization        Q8_0
    template source     go_template
  Capabilities
    completion
  Parameters
    stop    "<|im_start|>"
    stop    "<|im_end|>"
출력에 나타난 Q8_0 양자화 표기와 메모리 절감 원리는 양자화(Quantization)란? FP16·INT8·INT4 차이와 LLM 메모리가 줄어드는 이유 글에서 자세히 다룹니다. 또한 context length 8192가 의미하는 토큰 계산과 입력 길이 제한은 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유 글에서 확인할 수 있습니다.
첫 실행은 어떻게 합니까?
한 줄 답: ollama run <model> "<prompt>"처럼 인자로 질문을 넘겨 단발 실행하거나, 프롬프트 인자 없이 실행해 대화형 모드로 사용할 수 있습니다.
ollama run 단발 실행과 대화형 실행 방법
명령줄에서 모델 이름 뒤에 프롬프트 문자열을 함께 넘기면 한 번의 답변을 출력하고 종료합니다.
$ ollama run smollm2-360m "What is the capital of France? Answer in one sentence."
The capital of France is Paris.
공식 CLI 문서에 따르면 프롬프트 인자 없이 ollama run <model>만 입력하면 터미널에서 바로 질문을 주고받는 대화형 모드로 실행할 수 있습니다. 참고로 이 절과 다음 절에 나오는 모델의 답변은 이 작은 모델이 생성한 출력 예시일 뿐이며 사실 여부의 근거가 아닙니다.
API는 어떻게 호출합니까?
한 줄 답: 로컬 11434 포트의 /api/generate, /api/chat, /api/tags, /api/version 엔드포인트에 curl로 요청을 보내며, "stream": false로 단일 JSON 응답을 받거나 기본 스트리밍(NDJSON)으로 받을 수 있습니다.
/api/generate와 /api/chat 단발 응답(“stream”: false)
공식 API 문서(docs/api.md)에 따르면 POST /api/generate는 단일 프롬프트에 대한 응답을 생성하고, POST /api/chat은 role과 content가 담긴 messages 배열을 받아 다음 대화 메시지를 생성합니다. 두 엔드포인트는 기본적으로 응답을 스트리밍하지만, 요청 본문에 {"stream": false}를 넣으면 스트리밍을 끄고 한 번에 결과를 받을 수 있습니다(최종 응답 객체에는 나노초 단위의 소요 시간 통계가 포함됩니다).
또한 options 객체에 temperature나 seed를 넘겨 생성 동작을 조절할 수 있습니다. 아래 API 호출에서는 모두 "temperature": 0, "seed": 42를 지정했으며, temperature 설정이 답변 변화에 미치는 영향은 Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유 글에서 볼 수 있습니다.
먼저 /api/generate에 "stream": false를 지정해 텍스트 본문(.response)만 추출한 결과입니다.
$ curl -s http://localhost:11434/api/generate -d '{"model": "smollm2-360m", "prompt": "Why is the sky blue? Answer in one sentence.", "stream": false, "options": {"temperature": 0, "seed": 42}}' | jq -r .response
The sky appears blue because of a phenomenon known as Rayleigh scattering, which occurs when sunlight enters Earth's atmosphere and encounters tiny molecules of gases such as nitrogen and oxygen. These molecules scatter the shorter wavelengths of light, such as blue and violet, in all directions, while the longer wavelengths, like red and orange, are scattered in a more random pattern. This scattering effect is responsible for the blue color of the sky, as the blue light is scattered more efficiently than the longer wavelengths.
다음은 /api/chat에 "stream": false를 지정해 응답 메시지 객체(.message)를 확인한 결과입니다.
$ curl -s http://localhost:11434/api/chat -d '{"model": "smollm2-360m", "messages": [{"role": "user", "content": "Name three primary colors."}], "stream": false, "options": {"temperature": 0, "seed": 42}}' | jq .message
{
  "role": "assistant",
  "content": "Three primary colors are red, blue, and yellow. These colors are the building blocks of all other colors and are used to create all other colors in the color spectrum."
}
채팅 답변인 “red, blue, and yellow”처럼 작은 모델은 표현이 느슨한 답을 내놓을 수 있으므로, 이 응답들은 출력 예시로만 참고합니다.
기본 스트리밍(NDJSON) 응답과 /api/tags·/api/version 조회
stream 옵션을 생략하면 기본값인 스트리밍 모드로 동작하며, 토큰 조각이 생성될 때마다 줄바꿈으로 구분된 JSON 객체가 차례대로 도착합니다. 아래는 처음 3줄을 확인한 결과입니다(created_at 시각은 UTC 기준입니다).
$ curl -s http://localhost:11434/api/generate -d '{"model": "smollm2-360m", "prompt": "Say hi.", "options": {"temperature": 0, "seed": 42}}' | head -n 3
{"model":"smollm2-360m","created_at":"2026-11-03T22:03:59.202964822Z","response":"Hello","done":false}
{"model":"smollm2-360m","created_at":"2026-11-03T22:03:59.209502177Z","response":"!","done":false}
{"model":"smollm2-360m","created_at":"2026-11-03T22:03:59.215637513Z","response":" How","done":false}
로컬에 등록된 모델 목록은 GET /api/tags로, 현재 실행 중인 서버 버전은 GET /api/version으로 조회합니다.
$ curl -s http://localhost:11434/api/tags | jq -r ".models[].name"
smollm2-360m:latest
$ curl -s http://localhost:11434/api/version
{"version":"0.40.14"}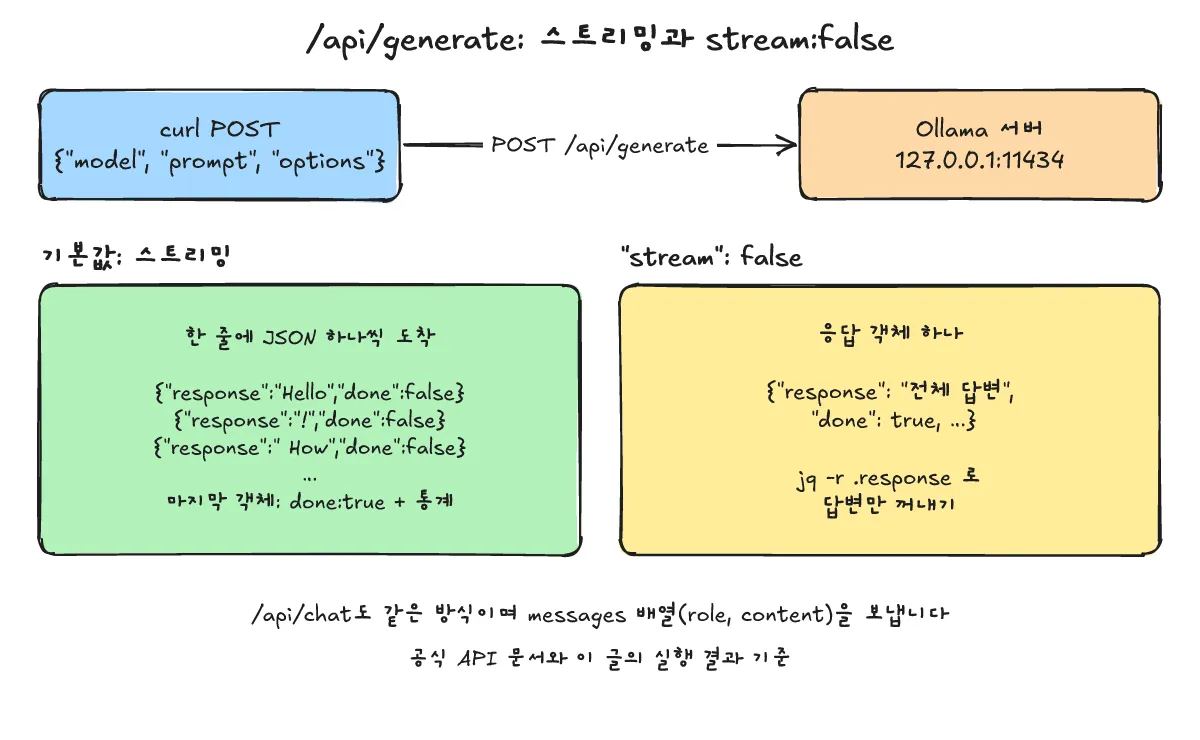
모델 관리와 메모리 해제는 어떻게 합니까?
한 줄 답: 모델은 기본적으로 5분 동안 메모리에 유지되며, ollama stop으로 즉시 내리고 ollama ps로 적재 상태를 확인합니다.
ollama stop·ollama ps와 5분 유지(keep-alive) 설정
공식 FAQ에 따르면 한 번 실행된 모델은 기본적으로 5분(5 minutes) 동안 메모리에 유지됩니다. 기다리지 않고 메모리에서 즉시 내리려면 ollama stop <model>을 실행하며, 현재 메모리에 올라와 있는 모델 목록은 ollama ps로 확인합니다. 유지 시간은 API 요청의 keep_alive 파라미터나 OLLAMA_KEEP_ALIVE 환경 변수로 조절할 수 있습니다.
$ ollama stop smollm2-360m
$ ollama ps
NAME    ID    SIZE    PROCESSOR    CONTEXT    RUNNER    UNTIL
위 출력에서 ollama ps 표가 비어 있는 것은 메모리에 적재된 모델이 없음을 뜻합니다. 만약 디스크에 등록된 모델 자체를 삭제하려면 공식 CLI 문서의 ollama rm <model> 명령을 사용합니다.
바인딩 주소(OLLAMA_HOST)와 저장 경로(OLLAMA_MODELS) 환경 변수
공식 FAQ와 CLI 문서에 정리된 서버 설정 항목은 다음과 같습니다.
- 바인딩 주소 변경: 기본값인
127.0.0.1:11434대신 다른 주소나 포트를 바인딩하려면OLLAMA_HOST환경 변수를 설정합니다. - 모델 저장 경로 변경: 리눅스 표준 서비스 설치 기준 모델 저장 경로는
/usr/share/ollama/.ollama/models이며, 다른 디렉터리를 쓰려면OLLAMA_MODELS환경 변수를 지정합니다. - 환경 변수 전체 목록 확인: 공식 문서의
ollama serve --help명령으로 서버가 참조하는 환경 변수 목록을 확인할 수 있습니다.
설치·실행이 막힐 때 확인할 것은 무엇입니까?
한 줄 답: zstd 설치 여부, ollama serve 프로세스 동작 여부(ollama -v 또는 /api/version), 네트워크 리다이렉트 차단 시 GGUF 가져오기 우회 여부를 순서대로 확인합니다.
이 환경에서 실제로 겪은 3가지 문제와 서버 상태 점검법
이 글의 실행 환경에서 설치부터 첫 실행까지 진행하며 실제로 마주친 세 가지 상황과 해결 방법은 다음과 같습니다.
- 설치 스크립트 중단(
zstd누락):ERROR: This version requires zstd for extraction.메시지가 나오면 시스템에zstd를 먼저 설치한 뒤 설치 스크립트를 다시 실행합니다. - 서비스 미기동(
WARNING: systemd is not running):systemd가 없는 컨테이너나 환경에서는 데몬이 자동 실행되지 않으므로, 별도 터미널이나 백그라운드에서ollama serve를 직접 실행합니다. 서버가 정상 응답하는지는ollama -v또는curl -s http://localhost:11434/api/version으로 바로 확인할 수 있습니다. - 모델 다운로드 리다이렉트 차단: 네트워크 정책 때문에
ollama pull이 모델 파일을 받지 못할 때는 공개된 단일 GGUF 파일을 내려받아FROM ./file.gguf한 줄을 적은Modelfile과ollama create <name> -f Modelfile로 로컬 등록할 수 있습니다.
자주 묻는 질문(FAQ)은 무엇입니까?
한 줄 답: 포트 번호, 모델 메모리 유지 시간, 단일 GGUF 파일 등록 방법을 요약했습니다.
Ollama API의 기본 주소와 포트 번호는 무엇입니까?
공식 FAQ에 따르면 기본 바인딩 주소는 127.0.0.1, 포트는 11434입니다. 바인딩 주소를 바꾸려면 OLLAMA_HOST 환경 변수를 사용합니다.
실행한 모델은 메모리에 얼마나 유지됩니까?
기본적으로 5분(5 minutes) 동안 메모리에 유지됩니다. 즉시 해제하려면 ollama stop <model>을 실행하고, 유지 시간을 바꾸려면 API의 keep_alive 파라미터나 OLLAMA_KEEP_ALIVE 환경 변수를 설정합니다.
외부에서 받은 GGUF 파일을 양자화 없이 그대로 등록할 수 있습니까?
가능합니다. Modelfile에 FROM /path/to/file.gguf를 적고 ollama create <name> -f Modelfile을 실행하면 되며, 공식 문서에 따라 가져오기 과정에서 별도의 양자화는 수행되지 않습니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: 양자화(Q8_0), 샘플링 파라미터(Temperature), 컨텍스트 윈도우(8192)의 원리를 다룬 글입니다.
- 양자화(Quantization)란? FP16·INT8·INT4 차이와 LLM 메모리가 줄어드는 이유
- Temperature와 Top-p란? LLM 답변이 매번 달라지는 이유
- 토큰과 컨텍스트 윈도우란? LLM이 글자를 세는 방식과 길이 제한이 생기는 이유
출처는 어디입니까?
한 줄 답: 이 글에서 참고한 Ollama 공식 문서와 API 레퍼런스 목록입니다.
- Ollama docs: Linux (확인 2026-11-04)
- Ollama docs: Importing a model (확인 2026-11-04)
- Ollama docs: CLI reference (확인 2026-11-04)
- Ollama API reference (docs/api.md) (확인 2026-11-04)
- Ollama docs: FAQ (확인 2026-11-04)