핵심 요약
RLHF는 사람이 두 답변 중 더 나은 쪽을 고른 비교 데이터로 먼저 보상 모델을 학습시키고, 그 보상 모델이 높은 점수를 주는 방향으로 언어 모델을 강화학습(PPO)으로 조정하는 방법입니다. 이때 원래 모델에서 너무 멀어지지 않도록 KL 페널티를 겁니다. DPO는 별도의 보상 모델과 강화학습 단계를 빼고 같은 비교 데이터로 모델을 직접 학습시키는 대안입니다.
RLHF(사람 피드백 기반 강화학습)는 언어 모델이 단순히 다음 토큰을 예측하는 수준을 넘어, 사람이 선호하는 방식의 응답을 생성하도록 정렬하는 핵심 학습 기법입니다. 이 글에서는 원 논문에 정리된 일반적인 흐름을 바탕으로 보상 모델(reward model), PPO 강화학습과 KL 페널티, 보상 해킹(reward hacking), 그리고 대안인 DPO와의 차이를 차례대로 살펴봅니다.
RLHF란 무엇입니까?
한 줄 답: RLHF(사람 피드백 기반 강화학습)는 사람이 비교해 고른 선호 데이터를 바탕으로 보상 모델을 만들고, 강화학습으로 언어 모델의 출력을 사람 선호에 맞게 조정하는 학습 방법입니다.
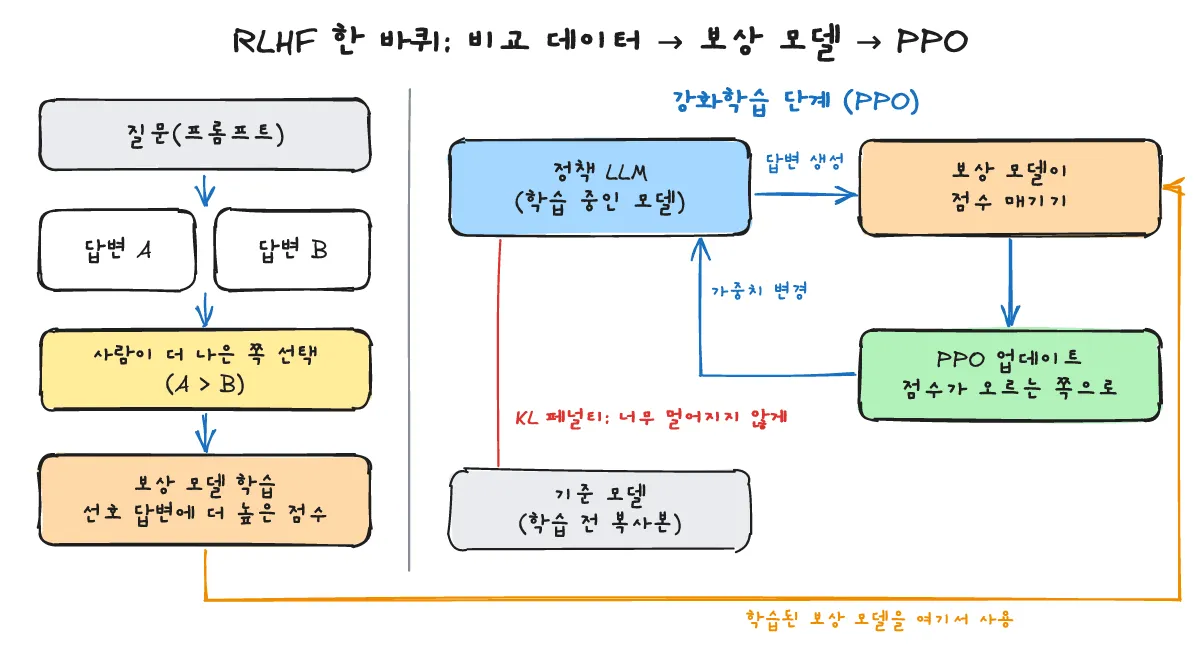
Ouyang et al.의 2022년 논문 “Training language models to follow instructions with human feedback”에서 설명하는 일반적인 흐름은 세 단계로 구성됩니다. 첫째, 시연(demonstration) 데이터를 사용해 지도 미세조정(SFT) 모델을 만듭니다. 둘째, 같은 프롬프트에 대한 여러 모델 출력의 순위를 사람이 매기거나 비교한 데이터를 모아, 선호된 출력에 더 높은 점수를 주도록 보상 모델을 학습시킵니다. 셋째, 미세조정된 모델(정책)이 보상 모델로부터 높은 점수를 받도록 PPO 강화학습 알고리즘으로 최적화하되, 기준(SFT) 모델에서 너무 멀어지지 않도록 토큰별 KL 페널티를 함께 적용합니다.
사전학습, SFT, RLHF로 이어지는 전체 단계별 개요는 사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나? 글에서 확인할 수 있습니다.
보상 모델은 어떻게 학습합니까?
한 줄 답: 같은 프롬프트에 대한 여러 응답 중 사람이 더 나은 쪽을 고르면, 선택된 응답에 더 높은 점수를 주도록 상대 비교 방식으로 학습합니다.
보상 모델(reward model)은 프롬프트와 모델의 응답을 입력받아 스칼라 점수를 출력하는 모델입니다. 학습 과정에서는 하나의 프롬프트에 대해 모델이 여러 응답을 생성하면, 사람이 이를 읽고 어느 응답이 더 나은지 비교하거나 순위를 매깁니다.
핵심은 사람이 각 응답에 절대적인 점수를 직접 매기는 것이 아니라, “응답 A가 응답 B보다 낫다”는 상대 비교(relative comparisons) 데이터를 통해 학습한다는 점입니다. 보상 모델은 이 비교 쌍에서 사람이 선호한 응답에 비선호 응답보다 더 높은 점수를 부여하는 방향으로 가중치를 갱신합니다.
PPO는 무엇을 바꿉니까?
한 줄 답: PPO는 언어 모델(정책)이 보상 모델에서 높은 점수를 받도록 가중치를 갱신하되, 기준 모델에서 너무 멀어지지 않게 토큰별 KL 페널티를 함께 적용합니다.
보상 모델이 준비되면 미세조정된 언어 모델을 강화학습의 정책(policy)으로 두고 PPO(Proximal Policy Optimization) 알고리즘으로 학습을 진행합니다. 이 과정은 다음과 같은 순환 구조로 이루어집니다.
- 정책(언어 모델)이 주어진 프롬프트에 대해 응답을 생성합니다.
- 보상 모델이 해당 응답을 평가해 점수를 계산합니다.
- 점수가 높아지는 방향으로 PPO가 정책의 가중치를 갱신합니다.
이때 보상 모델의 점수만 최대화하면 정책이 이상한 말투나 문장으로 흘러가거나, 보상 모델의 취약점을 파고들어 점수만 과도하게 높이는 과최적화(reward over-optimization)가 발생할 수 있습니다. 이를 막기 위해 원래의 SFT 모델(기준 모델, reference model) 출력 분포에서 벗어나는 정도에 비례해 토큰별 KL 페널티(per-token KL penalty)를 부과하여, 정책이 기준 모델에서 너무 멀리 이탈하지 않도록 제어합니다.
보상 해킹이란 무엇입니까?
한 줄 답: 보상 해킹은 모델이 실제로 더 좋은 답을 내는 대신 보상 모델의 허점을 파고들어 점수만 높이는 현상입니다.
보상 모델은 사람의 선호를 완벽하게 복제한 것이 아니라 유한한 비교 데이터로 학습된 근사 모델입니다. 따라서 정책 모델이 강화학습을 거치면서 실제로 사람에게 더 유용하거나 정확한 응답을 생성하는 대신, 보상 모델이 높은 점수를 주는 특정 패턴이나 빈틈을 찾아내어 점수만 끌어올리는 보상 해킹(reward hacking)이 나타날 수 있습니다.
이처럼 모델이 내놓는 높은 점수가 곧 실제 정답이나 품질을 보장하지 않는다는 문제는 LLM 신뢰도 점수란? 모델에게 확신도를 물어보면 안 되는 이유와 보정(Calibration) 글에서 다루는 신뢰도 보정 개념과도 맞닿아 있습니다.
RLHF와 DPO는 무엇이 다릅니까?
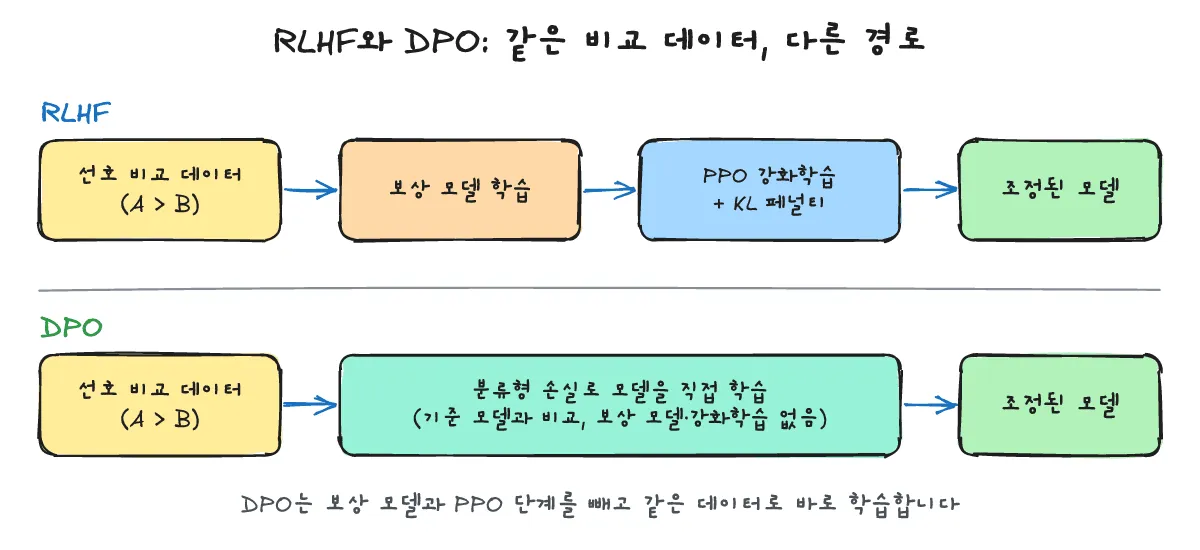
한 줄 답: RLHF는 별도의 보상 모델과 PPO 강화학습 루프를 쓰지만, DPO는 선호 쌍 데이터와 분류형 손실 함수만으로 언어 모델을 직접 학습시킵니다.
Rafailov et al.의 2023년 논문 “Direct Preference Optimization: Your Language Model is Secretly a Reward Model”에서 제시된 DPO(Direct Preference Optimization)는 별도의 보상 모델을 맞추거나 강화학습 루프를 돌리지 않고, 동일한 선호 비교 쌍 데이터에서 간단한 분류형 손실(classification-style loss)을 사용해 언어 모델을 직접 최적화합니다. 이때 DPO가 사용하는 손실은 분류 손실의 일종이며, 기초 개념은 교차 엔트로피(Cross-Entropy) 손실이란? 분류 모델이 MSE 대신 쓰는 이유 주제와 이어집니다.
| 구분 | RLHF (보상 모델 + PPO) | DPO |
|---|---|---|
| 필요한 것 | 별도의 보상 모델, 강화학습 루프, 기준 모델 | 선호 비교 데이터와 기준 모델만 필요(별도 보상 모델 없음) |
| 학습 방식 | 정책이 응답을 생성하고 보상 모델 점수로 PPO 강화학습 수행 | 선호 쌍 데이터에서 분류형 손실로 언어 모델을 직접 학습 |
| 장단점 | 구조가 유연하지만 관리할 구성 요소와 튜닝 부담이 큼 | 구조가 단순하고 실행이 안정적이나 고정된 선호 데이터셋에 묶임 |
자주 묻는 질문은 무엇입니까?
한 줄 답: RLHF와 사실 정확도의 관계, SFT만으로는 부족한 이유, 그리고 사람 피드백을 대체하는 후속 기법을 정리했습니다.
RLHF를 하면 사실 정확도가 올라갑니까?
아닙니다. RLHF는 사람의 선호를 반영하도록 모델을 조정할 뿐, 그 자체로 사실 정확도를 보장하지는 않습니다. 언어 모델의 환각(hallucination) 한계와 이를 보완하는 구조는 Day5~7: AI의 한계, Embedding·RAG 구조, AI Agent와 Tool Calling 글에서 다루고 있습니다.
SFT만 하면 안 됩니까?
지도 미세조정(SFT)은 주어진 시연 예시를 모방하도록 학습합니다. 반면 사람이 직접 하나의 모범 답안을 작성하기보다 두 응답 중 어느 쪽이 더 나은지 판별하기가 더 쉬운 경우가 많으며, 상대 비교 데이터는 이러한 “어느 쪽이 더 나은가”라는 선호 기준을 포착할 수 있습니다.
RLAIF나 Constitutional 방식은 무엇입니까?
사람이 직접 비교 라벨을 붙이는 과정의 일부를 AI 피드백으로 대체하여 선호 학습을 수행하는 접근 방식입니다.
함께 보면 좋은 글은 무엇입니까?
한 줄 답: LLM 학습 단계, 어텐션 구조, 환각 한계, 신뢰도 보정을 다룬 관련 글입니다.
- 사전학습·파인튜닝·RLHF 차이: LLM은 어떤 단계로 만들어지나?
- Self-Attention이란? Q·K·V로 토큰 비중 매기는 법
- Day5~7: AI의 한계, Embedding·RAG 구조, AI Agent와 Tool Calling
- LLM 신뢰도 점수란? 모델에게 확신도를 물어보면 안 되는 이유와 보정(Calibration)
출처는 어디입니까?
한 줄 답: 본문 설명의 근거가 된 RLHF와 DPO 원 논문 두 편입니다.